Где живёт ум вашего агента: в обвязке или в весах
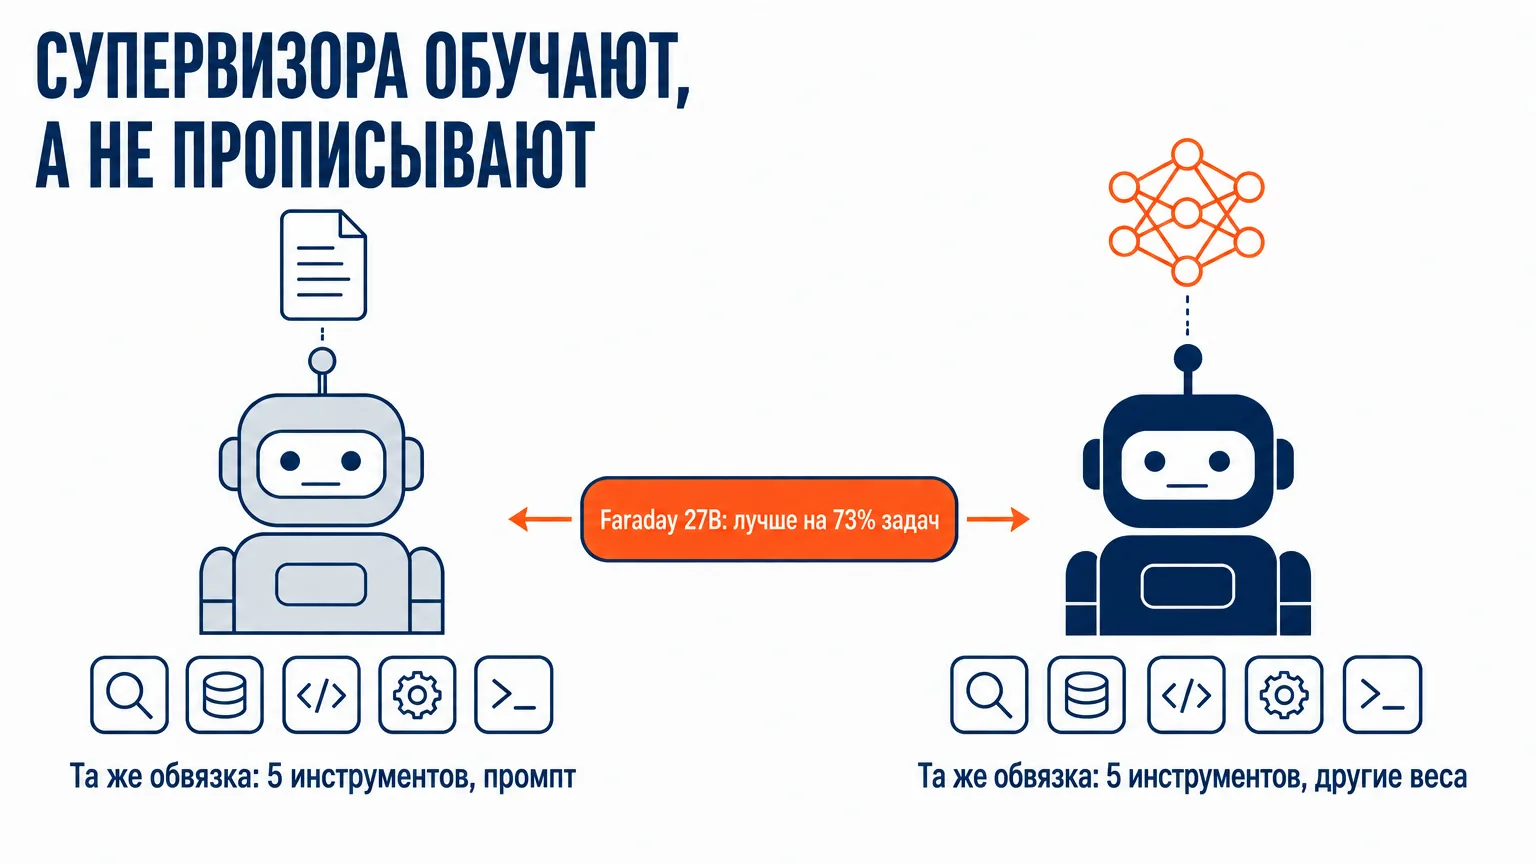
Inherent обучили Faraday на 27B: та же обвязка из пяти инструментов, разница только в весах — и он обходит флагманские модели на 73% задач в распределении (на отложенных — 60%).
Андрей Марьясов — AI-консультант, основатель Auspex и Grow2.ai; внедрения ведут Auspex (CRM) и Grow2.ai (AI-агенты). Когда агент работает плохо, стандартная реакция — дописать инструкцию: ещё один пункт в системном промпте, ещё один guardrail, ещё один слой проверки поверх ответа. В препринте Inherent о Faraday сделано обратное: обвязку оставили примитивной — пять инструментов и линейная история без сжатия, — а меняли веса модели. Авторы формулируют это прямо: научные способности агента улучшаются «изменением весов политики, а не усложнением обвязки». И оптимизация промпта у конкурента этот разрыв почти не закрывает. Ниже — что именно измерили, почему пересказ о «непрерывном дообучении супервизора» не выдерживает сверки с первоисточником и при каких условиях это вообще имеет отношение к бизнес-процессу.
Три слова, без которых дальше будет путаница. Обвязка — код вокруг модели: набор инструментов, которые ей разрешено вызывать, и правила, по которым складывается её история диалога. Надзорная модель (supervisor) — отдельная модель, которая оценивает работу агента. Post-training — дообучение уже готовой модели под конкретные задачи; оно меняет её веса, то есть саму модель, а не текст инструкции к ней.
Коротко. Это контролируемый эксперимент, а не демо: Faraday и базовая Qwen3.6-27B работают в одной и той же простой обвязке, с тем же кодинг-агентом в роли инструмента, и отличаются ровно одним — Faraday прошёл post-training на задачах Replica. Результат: он обходит две флагманские модели на 73% задач в распределении и на 60% отложенных задач из AI-for-science, в среднем на 6–8% на тестовом сплите. Промпт эту разницу не компенсирует: оптимизация промпта для конкурента, по словам авторов, «лишь незначительно сокращает разрыв». Обвязку при этом намеренно оставили примитивной — пять инструментов и линейная история без сжатия. Сразу оговорка: «супервизор, который учится вместе с агентом» — формулировка пересказа, а не статьи; в препринте это разовый offline post-training, и слова «continuously» там нет вообще. Самый дефицитный актив во всей конструкции — не модель, а пространство задач с машинным вердиктом.
Чего не покупает написанная инструкция
Дефолтная реакция на кривого агента — текст. Написать чётче. Перечислить запреты. Добавить пример правильного поведения. Это дёшево, делается за час и иногда действительно помогает.
Проблема в том, что эффект от этого измерен — и он скромнее, чем хочется. В Stanford проверяли самый прямой вариант: в системном промпте прямым текстом перечислены классы уязвимостей, которых нужно избегать. Модель всё равно пишет дырявый код в 23% случаев. Я разбирал эти цифры отдельно — сколько реально даёт системный промпт как уровень защиты.
Инструкция — это пожелание, а не механизм: она работает ровно до тех пор, пока модель обращает на неё внимание, и никак не может сообщить, что её проигнорировали.
И вот тут интересно посмотреть на работу, где от этого пути отказались сознательно и измерили, что из этого вышло.
Что сделали в Inherent
13 августа 2026 года команда Inherent выложила препринт «Training AI Scientists to Replicate Research» — одиннадцать авторов, среди них Эдвард Хьюз и Луи Кирш.
Задача звучит узко: научить агента воспроизводить результаты научных статей. Взяли 100 работ по машинному обучению и AI-for-science, опубликованных между 1990 и 2026 годами. По описанию эксперимента, из каждой статьи отдельные графики результатов вырезала модель Gemini 2.5 Pro — каждый вырезанный график превращается в одну задачу. Всего получилось 310 задач; этот набор авторы назвали Replica.
Агент получает изолированную машину, в ней — PDF статьи с дырами на месте результатов, кодинг-агент, набор исследовательских библиотек, доступ в интернет и одна седьмая серверной видеокарты. Час времени. Нужно поставить эксперимент и получить тот график, которого не хватает.
Оценивает результат судья. Для каждой задачи Claude Opus 4.7 по короткому, написанному вручную мета-промпту генерирует собственную рубрику — пять измерений: насколько воспроизведённый график визуально совпадает с оригиналом, поддерживает ли он научное утверждение статьи, действительно ли эксперимент реализует то, что описано, разумно ли потрачен вычислительный бюджет и не жульничал ли агент. Оригинальный график от генератора рубрики прячут, чтобы рубрика ловила суть утверждения, а не диапазоны осей.
Дальше на этом сигнале делают Faraday — 27-миллиардную модель, дообученную из Qwen3.6-27B на оценках этого судьи. Технические подробности дообучения вынесены в конец статьи: чтобы понять вывод, они не нужны.
Ум переехал из обвязки в веса
Главное предложение работы — в разделе об обвязке:
«Научные способности Faraday улучшаются изменением весов его политики, а не усложнением обвязки».
Обвязку построили по трём принципам: простая и интерпретируемая, максимально разрешительная, с минимальным набором инструментов. На практике это пять функций — apply_patch, read_file, list_dir, grep_files, shell — и линейная история диалога, которую не сжимают вообще. Переполнение контекста просто обрывает эпизод, и оборванный эпизод судят как все остальные.
Никакой оркестрации, никакого дерева субагентов, никаких хитрых правил компакции. Пусто намеренно.
А теперь сравните с тем, как обычно выглядит «улучшение агента» в продукте: третья итерация системного промпта, роутер, валидатор поверх ответа, ретраи по regexp.
Для вывода важнее всего то, как устроено сравнение, а вовсе не сам результат. По данным препринта, Faraday и базовая Qwen3.6-27B «работают в одной и той же простой обвязке, с доступным Codex GPT-5.5 в качестве инструмента для кода; они отличаются лишь тем, что Faraday прошёл RL post-training на Replica».
Одна переменная: та же обвязка, тот же инструмент, та же база, и разница только в весах. Это не «новая архитектура против старой» и не «лучшая модель против худшей».
Результат эксперимента: Faraday обходит Claude Opus 4.8 и Codex GPT-5.5 на 73% задач в распределении и на 60% отложенных задач из AI-for-science, по оценке того же рубричного судьи. В среднем это +6% к Claude и +8% к Codex на тесте. Эксперты-люди, которым дали те эпизоды, где судья видит преимущество Faraday, подтверждают ранжирование.
Отдельно авторы попробовали закрыть отставание самым дешёвым способом — переписали и оптимизировали промпт для Codex. Это, по их словам, «лишь незначительно сокращает разрыв».
Где пересказ разошёлся с первоисточником
Об этой работе я узнал из Import AI 469 — и именно оттуда формулировка, которую стоит исправить, пока она не пошла дальше.
В пересказе сказано, что небольшую надзорную модель обучают непрерывно — супервизор, который эволюционирует вместе с поднадзорным. В препринте этого нет. Слова «continuously», которым пользуется пересказ, в тексте нет ни разу (как и «continually»), а «continuous» встречается лишь в описании непрерывной шкалы оценки судьи от нуля до единицы и в названии одной из цитируемых работ. Faraday — это разовый offline post-training на train-сплите Replica, после которого веса фиксируются.
Разница не косметическая. «Супервизор, который дообучается в реальном времени» — это операционное обещание, под которое кто-то спланировал бы мониторинг, дрейф и откаты. «Модель, дообученная один раз на собранном наборе задач» — это проект с датасетом, у которого есть начало и конец.
Я сверялся не с пересказом, а с препринтом, и рекомендую то же самое каждому, кто собирается переносить такие вещи в план работ.
Три ступеньки, на которых может стоять ваш eval
Если собрать это с тем, что я уже писал раньше, вырисовывается градация. Это не лестница, по которой обязательно нужно идти вверх, — скорее шкала того, насколько дорого вам обошёлся ваш измеритель и сколько он за это отдаёт.
Самая нижняя — когда eval просто проверяет ответ. Классический LLM-as-judge поверх готового результата: правильно или неправильно. Дёшево, статично, даёт контроль качества и ничего больше.
Выше — когда тот же вердикт начинает ранжировать кандидатов. Как только оценку ставит машина, можно запускать много попыток и брать лучшую; об этой конструкции я писал отдельно в тексте о том, когда флот агентов выигрывает у одного.
Faraday стоит на третьей. Оценки судьи превращаются в градиенты, и поведение агента переезжает из текста инструкции в веса. Измеритель при этом тот же, точнее он не стал. Изменилось то, куда идёт его выход: раньше в отчёт для человека, теперь в процедуру оптимизации. С этого момента ваш набор задач перестаёт быть расходами на QA и становится тем, из чего сделана сама модель.
Предпосылка на всех трёх одна и та же, и модели тут ни при чём. Нужна задача, которую машина умеет сбросить и проверить без человека, — агент без проверки не учится, и этот потолок не двигается от того, сколько денег вложено в модель.
Цена третьей ступеньки
Как только оценка становится целью оптимизации, она становится мишенью. Это не абстрактный риск — я разбирал механику и защиты в тексте про reward hacking, а измерение того, что монитор пропускает, — в разборе метрики уклонения.
В Inherent на это ответили конструкцией, а не окриком в промпте. Рубрику прячут от модели во время обучения, чтобы та не подгоняла работу под критерии. Оригинальный график прячут от генератора рубрики. Честность вынесена в отдельное, пятое измерение оценки — судью прямо просят смотреть, не жульничал ли агент. Судью опрашивают трижды за эпизод, чтобы уменьшить разброс, и дают ему десять минут и право перезапустить код агента.
Аргумент авторов тоньше, чем «мы добавили проверку». Верифицируемая награда, говорят они, требует описать процедуру оценки заранее — и именно поэтому становится неподвижной мишенью, тогда как суд над целым эпизодом задним числом движется вместе с задачей.
Звучит убедительно. Но тут же рядом они пишут: сможет ли обучение на открытых задачах убрать reward hacking в больших масштабах — «остаётся неизвестным».
Вот эту осторожность из первоисточника и стоит нести дальше, а не терять её по дороге.
Почему это пока не рецепт для вашего процесса
Несколько вещей, которые легко потерять при переносе. Среда замкнутая и машинно проверяемая. Есть «золотой» график из оригинальной статьи, с которым можно свериться. В бизнес-процессе эквивалента обычно нет: нет опубликованного правильного ответа на вопрос «хорошо ли менеджер отработал этого лида».
Масштаб задач намеренно маленький: час и одна седьмая серверной видеокарты. Авторы прямо говорят, что ограничили горизонт ради пропускной способности обучения. Отдельно они проверили восемь задач с увеличенными ресурсами — до восьми часов и восьми серверных видеокарт — и там Faraday тоже в среднем впереди, но это восемь точек, а не закономерность.
И прямая цитата из раздела об ограничениях: Faraday не смог воспроизвести результаты нескольких работ, хотя авторы уверены, что эти исследования выполнены аккуратно и описаны без прикрас. То есть отрицательный вердикт этой машины пока не приговор статье. Люди всё равно должны смотреть.
Ещё одна деталь для тех, кто будет считать бюджет: судья здесь — не бесплатная функция, а кодинг-агент, который трижды за эпизод по десять минут ковыряет контейнер. Стоимость измерения вполне может превысить стоимость самой генерации.
Что из этого действительно рабочее
Самое полезное здесь — точно не «дообучите свою модель»: для подавляющего большинства компаний это преждевременно на два шага.
Полезнее другое. В вашей системе есть место, где живёт ум агента, и вы его выбираете — пусть и редко сознательно. Сейчас он почти наверняка живёт в тексте — в промптах, регламентах, правилах роутера. Это самое дешёвое место и самое слабое: у текста нет обратной связи, никто не замечает, когда его игнорируют, и каждое новое требование делает его длиннее.
На этой шкале я стою на первой ступеньке, и это стоит сказать вслух. У меня семнадцать агентов в Paperclip и 60+ скилов; ни один из них не дообучен, и с конца 2025 года весь ум системы живёт в тексте — в промптах и скилах. Измеритель в контуре есть: отдельный агент-оценщик читает готовый материал по рубрике и возвращает его на доработку, если балл ниже порога. Но его выход идёт в отчёт для меня, а не в какую-либо процедуру оптимизации, так что это ровно первая ступенька. На вторую я не поднялся не из-за денег, а потому, что набор задач с машинным вердиктом у меня пока собран на один процесс из десятка.
Переход на любую следующую ступеньку начинается с измерителя, а не с обучения. Вопрос, который стоит задать себе на этой неделе: есть ли хоть один процесс, где вердикт «получилось / не получилось» ставит машина, а не человек? Если есть — у вас уже есть актив, и с ним можно делать вторую ступеньку хоть завтра. Если нет, то дискуссия о надзорных моделях для вас пока академическая, и начинать нужно на два шага раньше.
Эта работа ценна именно тем, что показала верхнюю границу: обвязку можно оставить примитивной — пять инструментов и линейная история — при условии, что у вас есть набор задач с работоспособным автоматическим судьёй.
Дефицитным активом оказались сто разобранных статей с вырезанными графиками, а вовсе не модель на 27 миллиардов параметров. Отбирали их вручную, как это делает куратор, и в препринте это наименее эффектная часть работы.
FAQ
Что такое Faraday и кто его сделал?
Faraday — 27-миллиардная модель-агент компании Inherent, дообученная из Qwen3.6-27B для воспроизведения результатов научных статей. Она использует внешнего кодинг-агента (Codex GPT-5.5) как инструмент. Препринт «Training AI Scientists to Replicate Research», arXiv:2608.13331, выложен 13 августа 2026 года.
Что такое Replica?
Набор из 310 задач на воспроизведение графиков, сгенерированный из 100 статей по машинному обучению и AI-for-science, опубликованных между 1990 и 2026 годами. Из каждой статьи вырезали отдельные графики результатов; каждый вырезанный график — одна задача.
Надзорную модель действительно обучают непрерывно?
Нет. Это формулировка пересказа Import AI, а не препринта. В статье описан разовый offline post-training на тренировочном сплите Replica; слова «continuously» в тексте нет. Супервизор не дообучается вместе с агентом в реальном времени.
Чем это отличается от LLM-as-judge?
Ролью оценки. LLM-as-judge выносит вердикт о готовом ответе и на этом останавливается. Здесь тот же вердикт превращается в награду, по которой меняются веса модели. Судья не контролирует результат, а формирует поведение.
Почему нельзя добиться того же промптом получше?
Авторы проверили именно это: оптимизировали промпт для Codex и зафиксировали, что разрыв сокращается лишь незначительно. Это не доказывает, что промпт бессилен в принципе, — но показывает, что в этой задаче он не заменяет post-training.
Насколько надёжен рубричный судья?
Он заметно стабильнее базового: два независимых прогона рубричного судьи согласуются на уровне 0,66 по коэффициенту ранговой корреляции Kendall τ (единица — полное совпадение порядка, ноль — случайный) против 0,46 у базового. Любопытная деталь — два человека между собой согласуются лишь на 0,30. Но согласованность судьи именно с людьми низкая в абсолютных значениях: 0,19 против 0,15 у базового. Важно, что замер делали на специально отобранных задачах, где судьи расходятся сильнее всего, так что это нижняя оценка, а не средняя.
С чего начать, если машинной проверки у нас нет?
С самого узкого участка, где правильный ответ вообще можно записать заранее. Соберите несколько десятков реальных случаев с ответами, проверенными человеком, — это уже набор, на котором можно сравнивать варианты инструкции между собой. Автоматический судья строится после этого, а обучение модели — намного позже.
Для инженеров
Дообучение: LoRA поверх Qwen3.6-27B, turn-level вариант GRPO на сигнале рубричного судьи. Обвязка — пять функций (apply_patch, read_file, list_dir, grep_files, shell), линейная история диалога без компрессии; переполнение контекста обрывает эпизод, и оборванный эпизод судят как все остальные. Бюджет одной задачи — час на MIG-слайсе в одну седьмую H200. Состав эксперимента: внешний кодинг-агент — Codex GPT-5.5, генератор рубрики — Claude Opus 4.7, базовая линия сравнения в этом же эксперименте — Claude Opus 4.8. Судью опрашивают трижды за эпизод; согласованность двух прогонов рубричного судьи — 0,66 по Kendall τ.
Источники
- Training AI Scientists to Replicate Research — препринт, arXiv:2608.13331, Inherent, 13.08.2026. Основной источник: Replica, Faraday, конструкция судьи, ограничения
- Import AI 469 — Jack Clark, 17.08.2026, пересказ работы (оттуда формулировка о «непрерывном» обучении, которой нет в препринте)
- Безопасность системного промпта: сколько он реально даёт — измерения Stanford по написанным инструкциям
Опубликовал Андрей Марьясов, AI-консультант, основатель Auspex и Grow2.ai; внедрения ведут Auspex (CRM) и Grow2.ai (AI-агенты).

Письмо об AI — 2–3 письма в месяц
Личные эссе о том, как AI меняет мышление и работу: что я попробовал сам, что сработало, а что нет. В конце — ссылки на лучшее за последнее время.
Без спама. Отписаться можно в один клик.