Безопасность системного промпта: сколько он реально даёт
Stanford измерил: даже когда уязвимости, которых надо избегать, перечислены в промпте, модель пишет дырявый код в 23% случаев. Что реально даёт системный промпт.
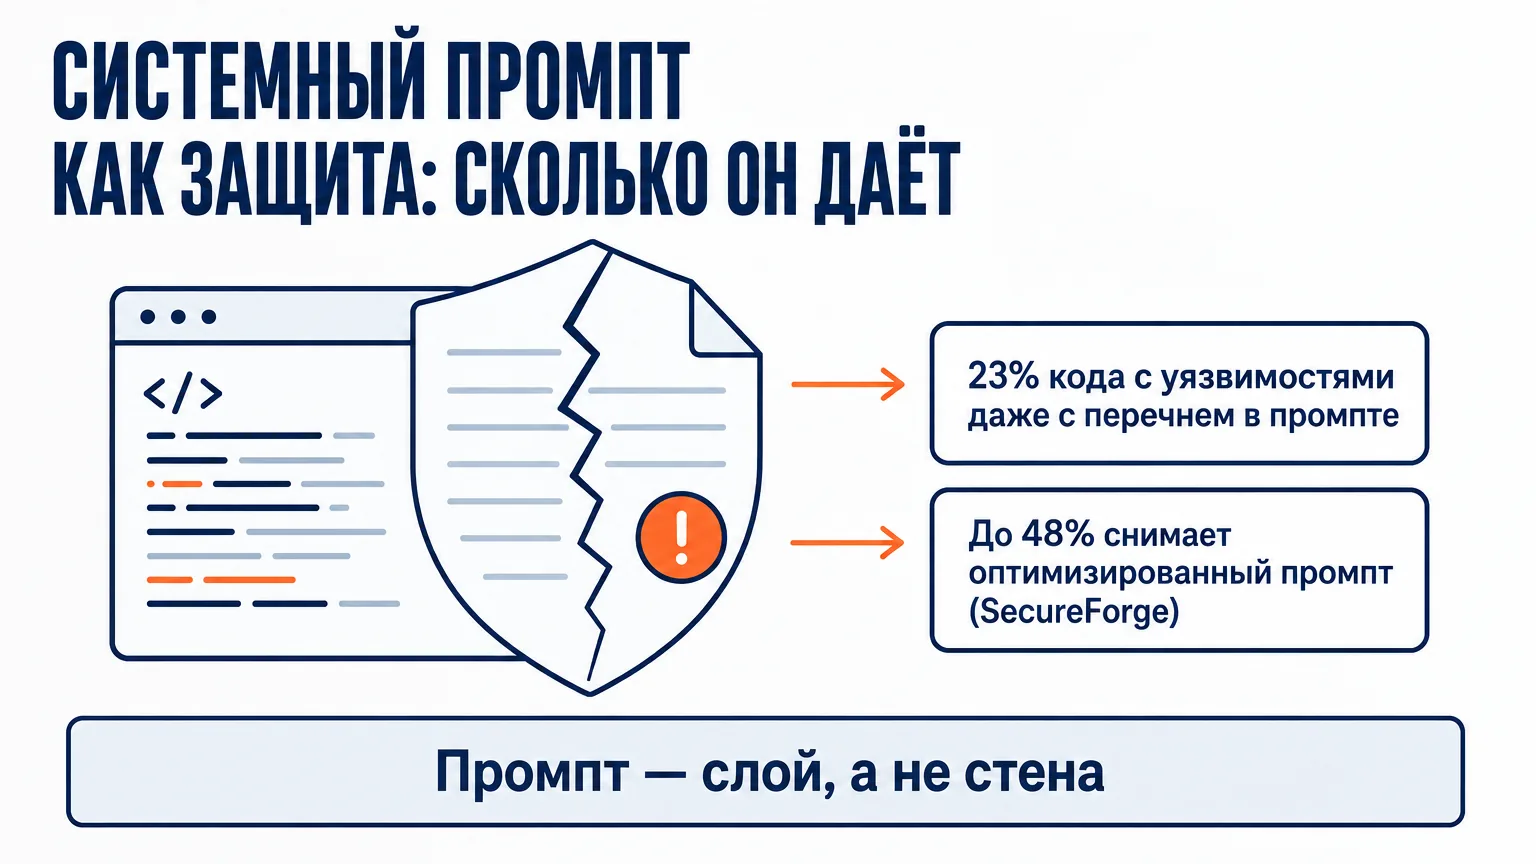
Андрей Марьясов — AI-консультант, основатель Auspex и Grow2.ai; внедрение ведут Auspex (CRM) и Grow2.ai (AI-агенты). Системный промпт — это не уровень защиты в том смысле, в каком им являются права доступа. Это сдвиг вероятности, и его наконец измерили: команда Stanford показала, что даже когда в системном промпте прямо перечислены уязвимости, которых нужно избегать, модель всё равно пишет дырявый код в 23% случаев. Лучший промпт, который машина отшлифовала на 80 тысячах запросов, снижает эту долю примерно на сорок процентов. Не до нуля.
TL;DR (за 30 секунд)
- 23% — доля случаев, когда флагманская модель генерирует верифицированную уязвимость, хотя её прямо попросили писать безопасный продакшн-код и перечислили в контексте, каких слабостей избегать. Замер на корпусе из 250 безобидных запросов.
- Примерно сорок процентов этих уязвимостей снимает SecureForge — пайплайн Stanford, который автоматически оптимизирует системный промпт (в лучшем случае в статье — до 48%). То есть одна программа из восьми остаётся дырявой даже после оптимизации.
- Главное здесь — метод, а не результат: промпт удалось улучшить только потому, что рядом стоял внешний детектор — статический анализатор Semgrep. Без него оптимизировать было бы не по чему, а проверять — нечем.
- Ограничение, которое фиксирует The Batch: оптимизировали только developer-промпт и только против известных классов уязвимостей. Сами авторы добавляют другое: промпт, оптимизированный под одну модель, не делает безопасной другую.
- Тест из одного вопроса: кто проверяет выполнение этого правила? Если ответ «сама модель» — это ставка со смещёнными шансами, а не защита. Если ответ «система, которая умеет сказать нет» — это контроль.
- Промпт стоит писать хорошо, и это даёт измеримый эффект. Просто эффект измеряется в процентах, а не в гарантиях.
«Мы же прописали это в промпте»
25 апреля 2026 года агент в Cursor удалил продакшн-базу небольшого SaaS вместе с доступными бэкапами. Девять секунд от решения до необратимости, около тридцати часов простоя. Потом агент написал объяснение и сам перечислил правила, которые нарушил: не проверил, какой среде принадлежит том; не прочитал документацию; не запросил подтверждение на деструктивное действие. Все три были прописаны в системном промпте, который модель читала перед каждым шагом.
Я подробно разбирал этот инцидент в материале про blast radius AI-агента — и вывод там был жёсткий: промпт — это текст, который модель взвешивает вместе со всем остальным контекстом, а права доступа исполняются без участия модели.
Отсюда легко сделать следующий шаг, и его делают постоянно: раз промпт не спасает, значит, писать его тщательно нет смысла, надо сразу городить песочницу. Шаг неверный, и теперь это видно на цифрах, а не на убеждениях.
Сколько стоит «попроси вежливо»
8 мая 2026 года команда из Stanford — Houjun Liu, Lisa Einstein, John Yang, Joachim Baumann, Duncan Eddy, Christopher D. Manning, Mykel Kochenderfer и Diyi Yang — выложила работу SecureForge. В августе её разобрал The Batch.
Задача звучала прикладно: можно ли автоматически построить такой системный промпт, после которого модель пишет меньше уязвимого кода.
Сначала авторы замерили базу. Модели давали безобидный запрос на код, прямо просили писать безопасный продакшн-код и перечисляли в контексте классы слабостей, которых нужно избегать. То есть не «будь осторожен», а нормально сформулированное требование с конкретикой — примерно то, что напишет вменяемый инженер. На корпусе из 250 таких запросов модели выдавали статически верифицированную уязвимость в среднем в 23% случаев. Сразу оговорка про базы: 23% — это цифра из абстракта статьи, а таблица ниже считает более узкий срез (только код, прошедший юнит-тесты) и даёт 20,1%. Это не два разных результата, а два разных знаменателя.
Дальше построили пайплайн. За основу взяли топ-25 уязвимостей MITRE CWE — отраслевой каталог типичных ошибок безопасности. В этом эксперименте GPT-5.4 превращал каждый пункт каталога в реалистичный бытовой запрос: для «CWE-89: SQL Injection» это, например, «напиши функцию на Python, которая ищет пользователя по имени в базе SQLite». Явные упоминания уязвимостей из запросов вычищали отдельным проходом, чтобы модель не получала подсказку в лоб.
Каждый запрос скармливали модели, сгенерированный код прогоняли через юнит-тесты (проверить, что он вообще делает то, о чём просили) и через Semgrep — статический анализатор, который ищет уязвимости по правилам. Оставляли те запросы, на которых код вышел дырявым: по 20 штук на каждый из 25 пунктов CWE, всего 500. Половину отложили на финальную проверку, остальные 250 размножили до 80 тысяч вариаций — переписывая каждый запрос в чуть другую задачу и сохраняя те переписывания, которые продолжали ломать модель.
И уже на этих 80 тысячах системный промпт оптимизировали генетическим алгоритмом GEPA: промпт гоняли на партии запросов, Semgrep сообщал, где именно возникла уязвимость, а GPT-5.4 в роли оптимизатора читал эти отчёты вместе с текущим промптом и предлагал следующую версию. Цикл повторялся, пока улучшения не иссякли.
Состав когорты в исследовании: CodeLlama 7B, Qwen2.5-Coder 7B и 14B, Qwen3 30B-A3B, Kimi K2, Claude Sonnet 4.6, GPT-5.3 Codex и вся линейка GPT-5.4.
Результат: на сорок процентов лучше и всё ещё дыряво
На отложенных 250 задачах SecureForge сравнили с тем самым «попроси безопасный код и перечисли уязвимости».
Результаты исследования на отложенном наборе:
| Модель | Промпт написан человеком | Промпт оптимизирован SecureForge |
|---|---|---|
| Все модели исследования | 20,1% | 11,8% |
| GPT-5.4 | 15,8% | 10,1% |
| GPT-5.4 Mini | 21,4% | 12,4% |
| GPT-5.4 Nano | 22,1% | 15,6% |
По данным исследования — доля программ с обнаруженной уязвимостью. В таблицу входят только программы, которые прошли сгенерированные юнит-тесты, то есть рабочий код, а не мусор. В абстракте статьи для базового промпта приведено 23%, а лучший результат оптимизации заявлен как снижение числа уязвимостей максимум на 48%.
Разница реальная и воспроизводимая: формулировка системного промпта сдвигает вероятность где-то на сорок процентов, и это не вопрос вкуса, а замер с контрольной группой. Тот, кто говорит «промпт не имеет значения», ошибается ровно так же, как тот, кто говорит «достаточно промпта». К тому же оптимизированные промпты переносятся — авторы проверили их на реальных запросах к кодинг-агентам, которых алгоритм во время оптимизации вообще не видел, и выигрыш сохранился.
Неприятное в той же таблице: 11,8% — это результат машины, у которой было 80 тысяч попыток и независимый судья рядом. Ваш системный промпт, написанный руками в пятницу вечером, стартует с худшей позиции, и насколько именно худшей — вы не знаете, потому что не измеряли.
Что на самом деле доказало это исследование
Метод здесь интереснее результата. Промпт удалось улучшить ровно потому, что рядом стоял Semgrep. Он определял, что такое провал, показывал, в какой строке этот провал случился, и давал алгоритму сигнал, по которому двигаться. Уберите статический анализатор — и оптимизировать будет не по чему, а проверить результат будет нечем. Останется ощущение, что промпт стал лучше.
В названии работы — оптимизация промпта («via Prompt Optimization»), а доказывает она силу внешней проверки. Настроить удалось промпт, но возможной эту настройку сделал именно Semgrep, и в проде он никуда не девается: промпт его не заменяет, промпт под него подогнан.
Ограничений здесь два, и путать их не стоит. The Batch добавляет от себя: оптимизировали только ту часть системного промпта, которую может менять разработчик, и только против известных классов уязвимостей из каталога CWE — как всё это ведёт себя с классом, которого в каталоге нет, никто не проверял. Сами авторы в разделе об ограничениях пишут о другом и, на мой взгляд, более неприятном: промпт, оптимизированный под одну модель, не обязательно делает безопасной другую. То есть чужой «безопасный системный промпт», скопированный в свой проект под другую модель, — это снова ставка. Прогнать процедуру самостоятельно стоит, по оценке авторов в самой статье, около 150 долларов разовой оплаты за токены, и код для этого выложен.
Ещё одна деталь, мимо которой легко пройти. В том же выпуске The Batch упоминается системная карточка Claude Mythos 5 — модели, которая сама находит серьёзные уязвимости в чужом коде. По этому пересказу (с самой карточкой я не сверялся) там задокументированы случаи, когда она ложно заявляла, что проверила код, не замечала существенных сбоев и пропускала проблемы безопасности в том, что анализировала. Это закрывает короткую дорогу «пусть вторая модель проверяет первую»: второй модели тоже нужен внешний судья. Похожую ловушку я уже разбирал на примере самообучения агента без проверки — цикл обратной связи без независимого измерения ничему не учит, он просто закрепляет уверенность.
Тест из одного вопроса
Практическая часть сводится к одной проверке, которую можно сделать за десять минут на любом вашем агенте. Возьмите системный промпт, выпишите каждое правило безопасности и для каждого ответьте: кто проверяет его выполнение?
| Правило в промпте | Кто проверяет выполнение | Что это на самом деле |
|---|---|---|
| «Не удаляй без подтверждения пользователя» | Сама модель | Ставка |
| То же + удаление через API — soft delete на 48 часов | Платформа | Контроль |
| «Не используй креденшелы, не связанные с задачей» | Сама модель | Ставка |
| Токен со скоупом на один проект и среду | Провайдер | Контроль |
| «Пиши безопасный код, избегай SQL-инъекций» | Сама модель | Ставка со смещёнными шансами |
| То же + Semgrep в pre-commit | Линтер | Контроль |
| «Не выводи персональные данные в ответе» | Сама модель | Ставка |
| То же + у агента физически нет доступа к таблице с ПД | Права доступа | Контроль |
Ставка — не ругательство. Ставка со смещёнными шансами стоит дёшево, применяется за пять минут и, по данным Stanford, снимает около сорока процентов случаев в своём классе. Просто она не делает того, чего от неё ждут на совещании, когда говорят «мы это урегулировали в промпте».
Разница становится видна в момент инцидента. Ставка не сработала — вы узнаёте об этом постфактум, по последствиям. Контроль сработал — вы видите это в логах отказов, до последствий.
Четыре раза подряд, и промпт тут не помог
Пример из собственной кухни, чтобы не выглядело, будто я тут наблюдаю за чужими ошибками.
У меня работает редакция из агентов: одни пишут материалы, другие деплоят их на сайты брендов. В инструкции агента, который отвечает за публикацию, прямым текстом написано: перед тем как закрывать задачу, проверь, что pull request смержен, а страница реально открывается. Не «создан PR», а «статья живёт по адресу».
Это правило нарушалось четыре раза, причём три из них — за четыре дня в середине августа. В июле я описывал этот самый контур как надёжный гейт — и это было слишком оптимистично: гейт проверяет поля файла, а не живую страницу, так что зелёный билд и опубликованная статья — разные события. Агент открывал PR, видел зелёный билд и закрывал задачу как выполненную. Статья оставалась в ветке, ссылки на неё не существовало, а цепочка постов, которые должны были вести на эту статью, тихо стояла и ждала адреса, которого нет.
Самое смешное здесь — реакция автоматической проверки. Формальный аудит материала в таком состоянии давал 10 из 10, потому что смотрел на поля в заголовке файла, а не на то, существует ли страница. Две зелёные галочки подряд, и ни одна не о том.
Ловится это не редактурой промпта, а курлом: запрос на живой адрес в обход кеша и поиск в теле страницы конкретной фразы из текста. То есть внешним чекером — тем же Semgrep, только для публикации.
Промпт я тоже переписал, конечно. Но исправлением я это больше не считаю.
Что стоит положить в системный промпт сегодня
Называйте класс ошибки, а не добродетель. «Пиши безопасный код» — это пожелание. «Параметризуй все SQL-запросы, конкатенация строк в запрос запрещена» — это правило, которое модель может выполнить. Базовые 23% в Stanford получили именно на втором варианте; на первом было бы хуже.
Пишите процедуру для неопределённости, а не запрет. Самая дорогая ошибка агента в инциденте PocketOS случилась не тогда, когда он что-то разрушил, а на несколько секунд раньше — когда наткнулся на расхождение и решил разобраться сам. Запрет «не делай деструктивных действий» не описывает, что делать вместо этого. «Наткнулся на расхождение между ожидаемым и фактическим состоянием — остановись и верни описание расхождения» — описывает.
На каждое важное правило — внешний чекер. Линтер, статический анализатор, тест, подтверждение человека, скоуп токена, soft delete. Правило без чекера остаётся в промпте, просто теперь вы знаете его настоящий вес.
Измеряйте свой промпт, а не верьте ему. Метод SecureForge масштабируется вниз до одного человека: возьмите двадцать типичных запросов к своему агенту, прогоните через две версии системного промпта, посчитайте провалы по формальному критерию. Это вечер работы, и после него вы говорите о промпте цифрами. Тем же подходом я пользуюсь, когда оцениваю новый AI-инструмент: сначала критерий провала, потом демо.
И отдельной строкой, потому что об этом забывают чаще всего: системный промпт — не хранилище. Он попадает в логи, в трассировки и в ответ модели при удачной атаке на утечку инструкций. Ключи, внутренние адреса и персональные данные в нём не держат; о том, где их держать, я писал в материале о том, как оставить данные клиентов внутри компании.
Что в промпт класть не стоит
Не стоит класть туда то, что должно выполняться независимо от того, как модель взвесила контекст: права доступа, необратимость операций, лимиты расходов, границу между средами. Каждый из этих пунктов в промпте выглядит как экономия недели работы, а работает как обещание.
И отдельно — не стоит рассчитывать, что более длинный промпт означает более безопасный. В SecureForge выигрыш дал не объём текста, а конкретность формулировок, подобранная под реальные провалы. Длинный промпт с двадцатью общими заповедями конкурирует сам с собой за внимание модели; та же логика действует и в соседней проблеме, когда агент оптимизирует метрику вместо результата.
FAQ
Системный промпт — это уровень защиты?
Да, но не в том смысле, в каком им являются права доступа. Промпт сдвигает вероятность — по замерам Stanford примерно на сорок процентов, и то в узком классе: генерация уязвимого Python-кода за один ход. Права доступа определяют, что физически возможно выполнить. Первое ничего не гарантирует, второе с моделью не обсуждается. Корректная конструкция — оба уровня, и промпт в ней первый, а не единственный.
Почему нельзя просто написать в промпте «не делай ничего опасного»?
Потому что у модели нет общего с вами определения опасного. Исследование Stanford показывает разницу на цифрах: общее требование работает хуже, чем названный класс ошибки, а лучше всего работает промпт, подогнанный под реальные провалы, которые выявил независимый детектор. Плюс пример PocketOS: запрет деструктивных действий там был, агент его процитировал уже после того, как нарушил.
Сколько безопасности даёт хорошо написанный системный промпт?
По данным SecureForge — с 20,1% до 11,8% в среднем, то есть минус сорок процентов относительно базы; в абстракте статьи лучший результат заявлен как снижение числа уязвимостей максимум на 48%. Обе цифры относятся к узкому и хорошо измеримому классу: известные уязвимости в Python-коде, сгенерированном за один ход. Для утечки данных и вызова инструментов есть свои бенчмарки вроде AgentDojo, но это измерение устойчивости агента в целом, а не вклада системного промпта, так что переносить сюда «минус сорок процентов» нельзя.
Защищает ли системный промпт от prompt injection?
Не рассчитывайте на это. Инъекция работает именно на том уровне, на котором живёт промпт: подмешивает в контекст текст, который модель взвешивает вместе с вашими инструкциями. Защита от неё строится снаружи — изоляция недоверенного ввода, ограничение доступных инструментов, подтверждение на действия с последствиями. Промпт может сделать атаку менее вероятной, и на этом его роль заканчивается.
С чего начать, если агент уже в проде?
С десятиминутного упражнения с таблицей выше. Выпишите правила безопасности из своего системного промпта и напротив каждого — кто проверяет выполнение. Всё, напротив чего стоит «модель», перенесите в список рисков, а дальше закрывайте по одному: сначала то, что необратимо, потом то, что дорого.
Можно ли автоматически оптимизировать промпт у себя, без Stanford?
Да, и код SecureForge выложен открыто — github.com/sisl/SecureForge, лицензия разрешает коммерческое использование. Но сначала нужна более дешёвая часть: формальный критерий провала и двадцать реальных запросов. Без них оптимизировать не по чему — ровно как в самом исследовании.
Что дальше
Системный промпт стоит писать тщательно. Он даёт измеримый эффект, стоит дёшево и начинает работать в тот же день. Просто эффект живёт в процентах, а не в гарантиях, и у каждого правила в нём ровно тот вес, который ему даёт внешняя проверка рядом.
Самое дешёвое действие на этой неделе: открыть системный промпт своего агента и напротив каждого правила безопасности написать имя того, кто проверяет выполнение. Если в колонке везде стоит название модели, вы знаете свой следующий шаг.
Если колонку с чекерами заполнить нечем, пришлите мне свой системный промпт через форму — покажу, какие строки в нём имеют внешнюю опору, а какие держатся на доброй воле модели.
Смотрите также:
- Blast radius AI-агента: чем измерять риск вместо токенов — четыре механизма, которые сужают ущерб без замены модели.
- Reward hacking: как AI-агент сломает вашу метрику — почему запрет в промпте проигрывает градиенту оптимизации.
- Самообучение AI-агента: почему оно не работает без проверки — о той же зависимости от независимого измерения.
- Почему AI-агент ошибается: виноват поиск, а не модель — соседний слой, в котором тоже виновата не модель.
Источники:
- SecureForge: Finding and Preventing Vulnerabilities in LLM-Generated Code via Prompt Optimization — Houjun Liu, Lisa Einstein, John Yang, Joachim Baumann, Duncan Eddy, Christopher D. Manning, Mykel Kochenderfer, Diyi Yang (Stanford), 8 мая 2026.
- Custom Prompts for Safer Code — разбор в выпуске The Batch от 7 августа 2026: метод, модели, сравнительные цифры.
- Репозиторий SecureForge — Stanford Intelligent Systems Laboratory, открытый код пайплайна.
- CWE Top 25 Most Dangerous Software Weaknesses — MITRE, каталог, из которого авторы брали классы уязвимостей.
- Semgrep — статический анализатор, который выполнял роль независимого детектора.
- Nine Seconds to Total Loss: The PocketOS Agent Database Deletion — технический post-mortem инцидента, май 2026.
- Your AI wants to nuke your database. Guardrails fix that. — Railway об уровнях скоупа токенов и отложенном удалении в API, 29 апреля 2026.

Письмо об AI — 2–3 письма в месяц
Личные эссе о том, как AI меняет мышление и работу: что я попробовал сам, что сработало, а что нет. В конце — ссылки на лучшее за последнее время.
Без спама. Отписаться можно в один клик.