Dónde vive la inteligencia de tu agente: en el harness o en los pesos
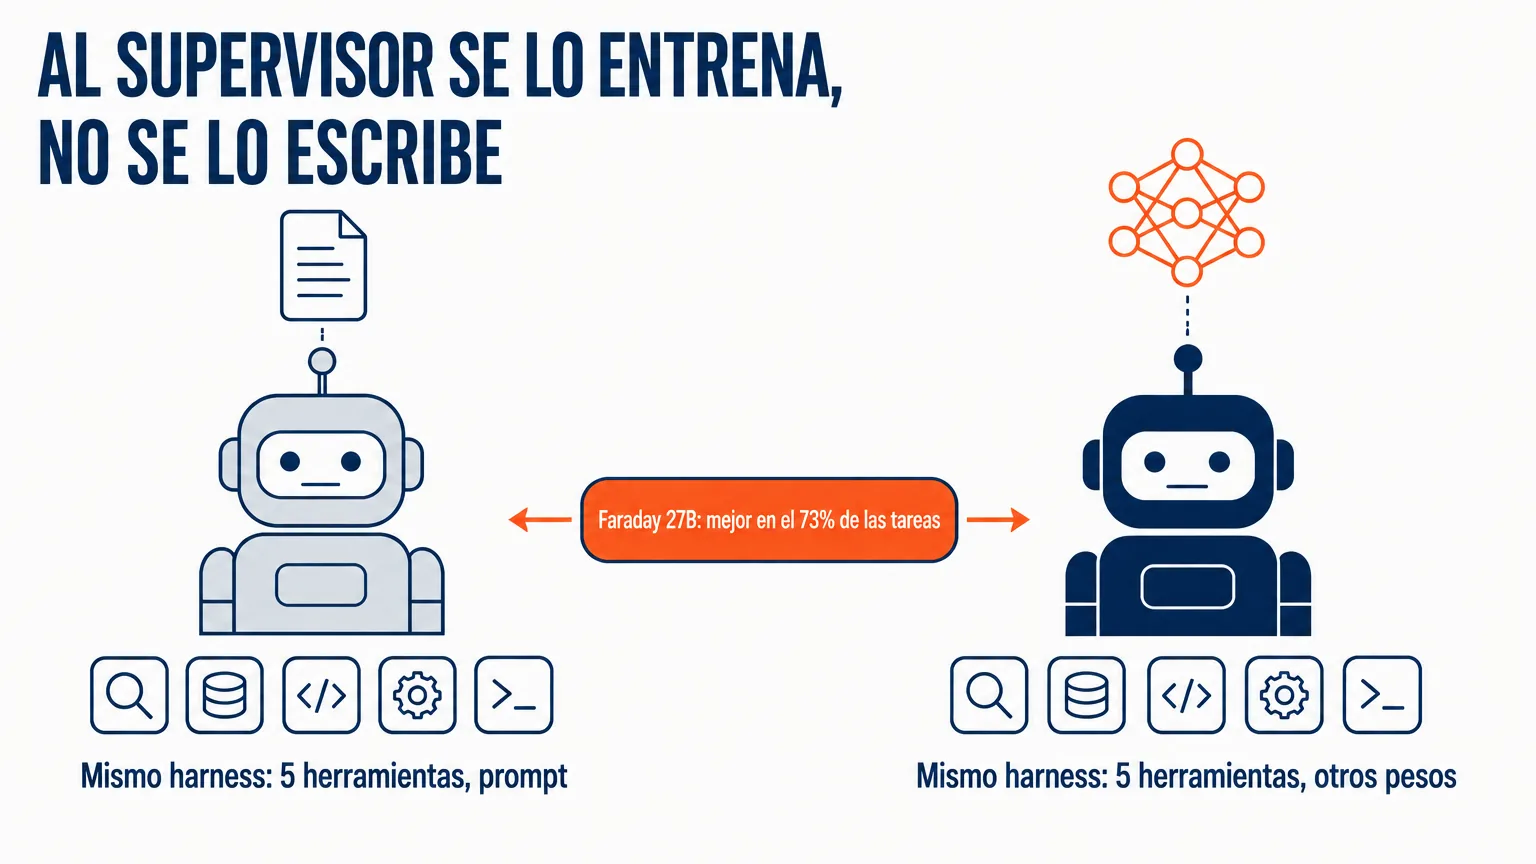
Inherent entrenó a Faraday (27B): mismo harness de cinco herramientas, solo cambian los pesos, y supera a modelos insignia en el 73% de las tareas en distribución (60% en las reservadas).
Andrew Maryasov — consultor de IA, fundador de Auspex y Grow2.ai; las implantaciones las llevan Auspex (CRM) y Grow2.ai (agentes de IA). Cuando un agente funciona mal, la reacción estándar es añadir instrucciones: un punto más en el prompt de sistema, un guardrail más, una capa más de verificación sobre la respuesta. En el preprint de Inherent sobre Faraday se hizo lo contrario: dejaron el harness primitivo —cinco herramientas y un historial lineal sin compresión— y lo que cambiaron fueron los pesos del modelo. Los autores lo dicen sin rodeos: las capacidades científicas del agente mejoran «cambiando los pesos de su política, no complicando el harness». Y optimizar el prompt del competidor casi no cierra esa brecha. A continuación: qué se midió exactamente, por qué el resumen sobre el «entrenamiento continuo del supervisor» no resiste el cotejo con la fuente original y en qué condiciones esto tiene siquiera relación con un proceso de negocio.
Tres términos sin los cuales lo que sigue se vuelve confuso. El harness es el código que rodea al modelo: el conjunto de herramientas que se le permite llamar y las reglas con las que se construye su historial de conversación. Un modelo supervisor es un modelo aparte que evalúa el trabajo del agente. El post-training es el entrenamiento adicional de un modelo ya terminado para tareas concretas; cambia sus pesos, es decir, el modelo mismo, y no el texto de las instrucciones que recibe.
En pocas palabras. Es un experimento controlado, no una demo: Faraday y el Qwen3.6-27B base se ejecutan en el mismo harness simple, con el mismo agente de código como herramienta, y se diferencian en una sola cosa: Faraday pasó por post-training con las tareas de Replica. El resultado: supera a dos modelos insignia en el 73% de las tareas dentro de la distribución y en el 60% de las tareas reservadas de AI-for-science, un 6–8% de media en el split de prueba. El prompt no compensa esa diferencia: optimizar el prompt del competidor, según los autores, «solo reduce marginalmente la brecha». El harness, además, se dejó primitivo a propósito: cinco herramientas y un historial lineal sin compresión. Una advertencia de entrada: «un supervisor que aprende junto con el agente» es una formulación del resumen, no del artículo; en el preprint se trata de un post-training offline hecho una sola vez, y la palabra «continuously» no aparece en absoluto. El activo más escaso de toda la construcción no es el modelo, sino un espacio de tareas con veredicto automático.
Lo que no compra una instrucción escrita
La reacción por defecto ante un agente que funciona mal es texto. Escribir con más claridad. Enumerar las prohibiciones. Añadir un ejemplo de comportamiento correcto. Es barato, se hace en una hora y a veces de verdad ayuda.
El problema es que el efecto está medido, y es más modesto de lo que uno quisiera. En Stanford probaron la variante más directa: en el prompt de sistema se enumeran, con todas las letras, las clases de vulnerabilidades que hay que evitar. Aun así, el modelo escribe código vulnerable en el 23% de los casos. Analicé esas cifras aparte: cuánto aporta en realidad el prompt de sistema como capa de seguridad.
Una instrucción es un deseo, no un mecanismo: funciona exactamente mientras el modelo le presta atención, y no tiene forma alguna de avisar de que la han ignorado.
Y aquí resulta interesante mirar un trabajo en el que se renunció a ese camino de forma deliberada y se midió qué salió de eso.
Qué hicieron en Inherent
El 13 de agosto de 2026 el equipo de Inherent publicó el preprint «Training AI Scientists to Replicate Research»: once autores, entre ellos Edward Hughes y Louis Kirsch.
La tarea suena acotada: enseñarle a un agente a reproducir los resultados de artículos científicos. Tomaron 100 trabajos de aprendizaje automático y AI-for-science publicados entre 1990 y 2026. Según la descripción del experimento, el modelo Gemini 2.5 Pro recortó de cada artículo gráficos de resultados individuales, y cada gráfico recortado se convierte en una tarea. En total salieron 310 tareas; los autores llamaron a ese conjunto Replica.
El agente recibe una máquina aislada y, dentro de ella, el PDF del artículo con huecos en lugar de los resultados, un agente de código, un conjunto de bibliotecas de investigación, acceso a internet y una séptima parte de una GPU de servidor. Una hora. Tiene que montar el experimento y obtener el gráfico que falta.
El resultado lo evalúa un juez. Para cada tarea, Claude Opus 4.7 genera su propia rúbrica a partir de un meta-prompt corto escrito a mano; son cinco dimensiones: hasta qué punto coincide visualmente el gráfico reproducido con el original, si respalda la afirmación científica del artículo, si el experimento realmente implementa lo que se describe, si el presupuesto de cómputo se gastó con sensatez y si el agente hizo trampa. El gráfico original se le oculta al generador de la rúbrica para que esta capte la esencia de la afirmación y no los rangos de los ejes.
Después, con esa señal se hace Faraday: un modelo de 27 mil millones de parámetros, entrenado a partir de Qwen3.6-27B con las puntuaciones de ese juez. Los detalles técnicos del entrenamiento están al final del artículo; no hacen falta para entender la conclusión.
La inteligencia se mudó del harness a los pesos
La frase central del trabajo está en la sección sobre el harness:
«Las capacidades científicas de Faraday mejoran cambiando los pesos de su política, no complicando su harness».
El harness se construyó según tres principios: simple e interpretable, lo más permisivo posible y con un conjunto mínimo de herramientas. En la práctica son cinco funciones —apply_patch, read_file, list_dir, grep_files, shell— y un historial de conversación lineal que no se comprime en absoluto. Si el contexto se desborda, el episodio simplemente se corta, y el episodio cortado se juzga como todos los demás.
Nada de orquestación, ni árbol de subagentes, ni reglas ingeniosas de compactación. Vacío a propósito.
Ahora compáralo con cómo suele verse la «mejora del agente» en un producto: la tercera iteración del prompt de sistema, un router, un validador sobre la respuesta, reintentos por regexp.
Lo más importante para la conclusión es cómo está planteada la comparación, y no el resultado en sí. Según el preprint, Faraday y el Qwen3.6-27B base «se ejecutan en el mismo harness simple, con Codex GPT-5.5 disponible como herramienta de código; se diferencian únicamente en que Faraday pasó por RL post-training en Replica».
Una sola variable: el mismo harness, la misma herramienta, la misma base, y la diferencia está solo en los pesos. No es «una arquitectura nueva contra una vieja» ni «un modelo mejor contra uno peor».
El resultado del experimento: Faraday supera a Claude Opus 4.8 y a Codex GPT-5.5 en el 73% de las tareas dentro de la distribución y en el 60% de las tareas reservadas de AI-for-science, según la evaluación del mismo juez con rúbrica. De media, eso es +6% frente a Claude y +8% frente a Codex en el conjunto de prueba. Los expertos humanos a quienes les dieron los episodios en los que el juez ve ventaja de Faraday confirman el ranking.
Aparte, los autores intentaron cerrar la brecha de la forma más barata: reescribieron y optimizaron el prompt para Codex. Eso, según ellos, «solo reduce marginalmente la brecha».
Dónde el resumen se apartó de la fuente original
Me enteré de este trabajo por Import AI 469, y es justo ahí donde está la formulación que conviene corregir antes de que siga circulando.
El resumen dice que al pequeño modelo supervisor lo entrenan de forma continua: un supervisor que evoluciona junto con el supervisado. En el preprint eso no está. La palabra «continuously», que usa el resumen, no aparece ni una sola vez en el texto (tampoco «continually»), y «continuous» aparece solo en la descripción de la escala continua de puntuación del juez, de cero a uno, y en el título de uno de los trabajos citados. Faraday es un post-training offline hecho una sola vez sobre el split de entrenamiento de Replica, después del cual los pesos quedan fijos.
La diferencia no es cosmética. «Un supervisor que se sigue entrenando en tiempo real» es una promesa operativa, para la cual alguien planificaría monitorización, deriva y rollbacks. «Un modelo entrenado una sola vez sobre un conjunto de tareas ya reunido» es un proyecto con un dataset, que tiene principio y fin.
Yo cotejé con el preprint, no con el resumen, y le recomiendo lo mismo a cualquiera que piense llevar cosas así a un plan de trabajo.
Tres peldaños en los que puede estar tu eval
Si se junta esto con lo que ya escribí antes, se dibuja una gradación. No es una escalera que haya que subir obligatoriamente; es más bien una escala de lo caro que te ha salido tu medidor y cuánto te devuelve a cambio.
El más bajo es cuando el eval simplemente verifica la respuesta. El clásico LLM-as-judge sobre un resultado terminado: correcto o incorrecto. Barato, estático, da control de calidad y nada más.
Más arriba, ese mismo veredicto empieza a ordenar candidatos. En cuanto la nota la pone una máquina, se pueden lanzar muchos intentos y quedarse con el mejor; sobre esa construcción escribí aparte, en el texto sobre cuándo una flota de agentes le gana a uno solo.
Faraday está en el tercero. Las puntuaciones del juez se convierten en gradientes, y el comportamiento del agente se muda del texto de la instrucción a los pesos. El medidor sigue siendo el mismo; no se volvió más preciso. Lo que cambió es adónde va su salida: antes, a un informe para una persona; ahora, a un procedimiento de optimización. A partir de ese momento tu conjunto de tareas deja de ser un gasto de QA y pasa a ser aquello de lo que está hecho el modelo mismo.
La condición previa en los tres es la misma, y no tiene que ver con los modelos. Hace falta una tarea que la máquina sepa reiniciar y verificar sin una persona —un agente sin verificación no aprende—, y ese techo no se mueve por más dinero que se invierta en el modelo.
El precio del tercer peldaño
En cuanto la evaluación se vuelve el objetivo de la optimización, se vuelve un blanco. No es un riesgo abstracto: analicé la mecánica y las defensas en el texto sobre reward hacking, y la medición de lo que el monitor deja pasar, en el análisis de la métrica de evasión.
En Inherent respondieron a esto con diseño, en lugar de una reprimenda en el prompt. La rúbrica se le oculta al modelo durante el entrenamiento, para que no ajuste su trabajo a los criterios. El gráfico original se le oculta al generador de la rúbrica. La honestidad se separó en una dimensión de evaluación aparte, la quinta: al juez se le pide directamente que mire si el agente hizo trampa. Al juez se le consulta tres veces por episodio para reducir la dispersión, y se le dan diez minutos y el derecho a volver a ejecutar el código del agente.
El argumento de los autores es más fino que «hemos añadido una verificación». Una recompensa verificable, dicen, exige describir de antemano el procedimiento de evaluación, y justamente por eso se vuelve un blanco fijo, mientras que juzgar el episodio completo a posteriori se mueve junto con la tarea.
Suena convincente. Pero ahí mismo escriben que si el entrenamiento con tareas abiertas puede eliminar a escala el reward hacking «está por ver».
Esa cautela de la fuente original es la que vale la pena llevar más lejos, en lugar de perderla por el camino.
Por qué esto todavía no es una receta para tu proceso
Algunas cosas que es fácil perder en el traslado. El entorno es cerrado y verificable por máquina. Hay un gráfico «de oro» del artículo original con el que se puede cotejar. En un proceso de negocio normalmente no hay equivalente: no existe una respuesta correcta publicada a la pregunta «¿el comercial trabajó bien este lead?».
La escala de las tareas es pequeña a propósito: una hora y una séptima parte de una GPU de servidor. Los autores dicen directamente que limitaron el horizonte en favor de la capacidad de procesamiento del entrenamiento. Aparte, probaron ocho tareas con más recursos —hasta ocho horas y ocho GPU de servidor—, y ahí Faraday también va por delante de media, pero son ocho puntos, no un patrón.
Y una cita directa de la sección de limitaciones: Faraday no logró reproducir los resultados de varios trabajos, aunque los autores están seguros de que esas investigaciones se hicieron con cuidado y se describieron sin adornos. Es decir, un veredicto negativo de esta máquina todavía no es una sentencia para el artículo. Las personas tienen que revisarlo de todos modos.
Un detalle más para quienes vayan a calcular el presupuesto: aquí el juez no es una función gratuita, sino un agente de código que tres veces por episodio pasa diez minutos hurgando en el contenedor. El coste de la medición bien puede superar el coste de la generación misma.
Qué de esto sirve de verdad
Lo más útil aquí, sin duda, no es «haz post-training de tu modelo»: para la gran mayoría de las empresas eso es adelantarse dos pasos.
Es más útil otra cosa. En tu sistema hay un lugar donde vive la inteligencia del agente, y tú lo eliges, aunque rara vez de forma consciente. Ahora mismo, casi con seguridad vive en el texto: en los prompts, los procedimientos, las reglas del router. Es el lugar más barato y el más débil: el texto no tiene retroalimentación, nadie nota cuando lo ignoran y cada nuevo requisito lo hace más largo.
En esta escala yo estoy en el primer peldaño, y vale la pena decirlo en voz alta. Tengo diecisiete agentes en Paperclip y 60+ skills; ninguno tiene post-training, y desde finales de 2025 toda la inteligencia del sistema vive en el texto: en los prompts y los skills. Sí hay un medidor en el circuito: un agente evaluador aparte lee el material terminado según una rúbrica y lo devuelve para corrección si la puntuación queda por debajo del umbral. Pero su salida va a un informe para mí y no a ningún procedimiento de optimización, así que es exactamente el primer peldaño. Si no he subido al segundo, no ha sido por dinero, sino porque el conjunto de tareas con veredicto automático lo tengo montado, por ahora, para un solo proceso de una decena.
Pasar a cualquier peldaño siguiente empieza por el medidor, no por el entrenamiento. Una pregunta que vale la pena hacerte esta semana: ¿hay al menos un proceso en el que el veredicto «funcionó / no funcionó» lo dé una máquina y no una persona? Si lo hay, ya tienes un activo, y con él puedes construir el segundo peldaño mañana mismo. Si no, la discusión sobre modelos supervisores es, por ahora, académica para ti, y hay que empezar dos pasos antes.
Este trabajo es valioso justamente porque mostró el límite superior: el harness se puede dejar primitivo —cinco herramientas y un historial lineal— con la condición de que tengas un conjunto de tareas con un juez automático que funcione.
El activo escaso resultaron ser cien artículos desmenuzados con sus gráficos recortados, y no el modelo de 27 mil millones de parámetros. Se seleccionaron con criterio de curaduría, a mano, y en el preprint esa es la parte menos vistosa del trabajo.
FAQ
¿Qué es Faraday y quién lo hizo?
Faraday es un modelo-agente de 27 mil millones de parámetros de la empresa Inherent, entrenado a partir de Qwen3.6-27B para reproducir los resultados de artículos científicos. Usa un agente de código externo (Codex GPT-5.5) como herramienta. El preprint «Training AI Scientists to Replicate Research», arXiv:2608.13331, se publicó el 13 de agosto de 2026.
¿Qué es Replica?
Un conjunto de 310 tareas de reproducción de gráficos, generado a partir de 100 artículos de aprendizaje automático y AI-for-science publicados entre 1990 y 2026. De cada artículo se recortaron gráficos de resultados individuales; cada gráfico recortado es una tarea.
¿De verdad al modelo supervisor lo entrenan de forma continua?
No. Esa es la formulación del resumen de Import AI, no del preprint. El artículo describe un post-training offline hecho una sola vez sobre el split de entrenamiento de Replica; la palabra «continuously» no aparece en el texto. El supervisor no se sigue entrenando junto con el agente en tiempo real.
¿En qué se diferencia esto de LLM-as-judge?
En el papel de la evaluación. LLM-as-judge emite un veredicto sobre una respuesta terminada y ahí se detiene. Aquí ese mismo veredicto se convierte en la recompensa con la que cambian los pesos del modelo. El juez no verifica el resultado, sino que moldea el comportamiento.
¿Por qué no se puede lograr lo mismo con un mejor prompt?
Los autores probaron justamente eso: optimizaron el prompt para Codex y registraron que la brecha se reduce solo marginalmente. Eso no demuestra que el prompt sea impotente por principio, pero sí muestra que en esta tarea no reemplaza al post-training.
¿Hasta qué punto es fiable el juez con rúbrica?
Es notablemente más estable que el juez base: dos ejecuciones independientes del juez con rúbrica coinciden en 0,66 según el coeficiente de correlación de rangos Kendall τ (uno es coincidencia total del orden; cero, azar) frente a 0,46 del juez base. Un detalle curioso: dos personas coinciden entre sí apenas en 0,30. Pero la concordancia del juez precisamente con las personas es baja en términos absolutos: 0,19 frente a 0,15 del juez base. Algo importante: la medición se hizo sobre tareas elegidas a propósito, aquellas en las que los jueces más discrepan, así que es una cota inferior, no una media.
¿Por dónde empezar si no tenemos verificación automática?
Por la parte más acotada donde la respuesta correcta se pueda siquiera escribir de antemano. Reúne unas cuantas decenas de casos reales con respuestas verificadas por una persona: eso ya es un conjunto con el que se pueden comparar variantes de la instrucción entre sí. El juez automático se construye después de eso, y el entrenamiento del modelo, mucho después.
Para ingenieros
Post-training: LoRA sobre Qwen3.6-27B, variante turn-level de GRPO con la señal del juez con rúbrica. El harness son cinco funciones (apply_patch, read_file, list_dir, grep_files, shell) y un historial de conversación lineal sin compresión; el desbordamiento de contexto corta el episodio, y el episodio cortado se juzga como todos los demás. El presupuesto por tarea es una hora en un slice MIG de una séptima parte de una H200. Composición del experimento: el agente de código externo es Codex GPT-5.5; el generador de la rúbrica, Claude Opus 4.7; la línea base de comparación en este mismo experimento, Claude Opus 4.8. Al juez se le consulta tres veces por episodio; la concordancia entre dos ejecuciones del juez con rúbrica es de 0,66 según Kendall τ.
Fuentes
- Training AI Scientists to Replicate Research — preprint, arXiv:2608.13331, Inherent, 13 de agosto de 2026. Fuente principal: Replica, Faraday, el diseño del juez, las limitaciones
- Import AI 469 — Jack Clark, 17 de agosto de 2026, resumen del trabajo (de ahí viene la formulación sobre el entrenamiento «continuo», que no está en el preprint)
- Seguridad del prompt de sistema: cuánto aporta en realidad — mediciones de Stanford sobre instrucciones escritas
Publicado por Andrew Maryasov, consultor de IA, fundador de Auspex y Grow2.ai; las implantaciones las llevan Auspex (CRM) y Grow2.ai (agentes de IA).

Una carta sobre IA: 2–3 emails al mes
Ensayos personales sobre cómo la IA cambia nuestra forma de pensar y trabajar: qué probé yo mismo, qué funcionó y qué no. Al final, enlaces a lo mejor de lo que he leído.
Sin spam. Puedes darte de baja con un clic.