Наглядач для AI-агента: чому його тренують, а не прописують
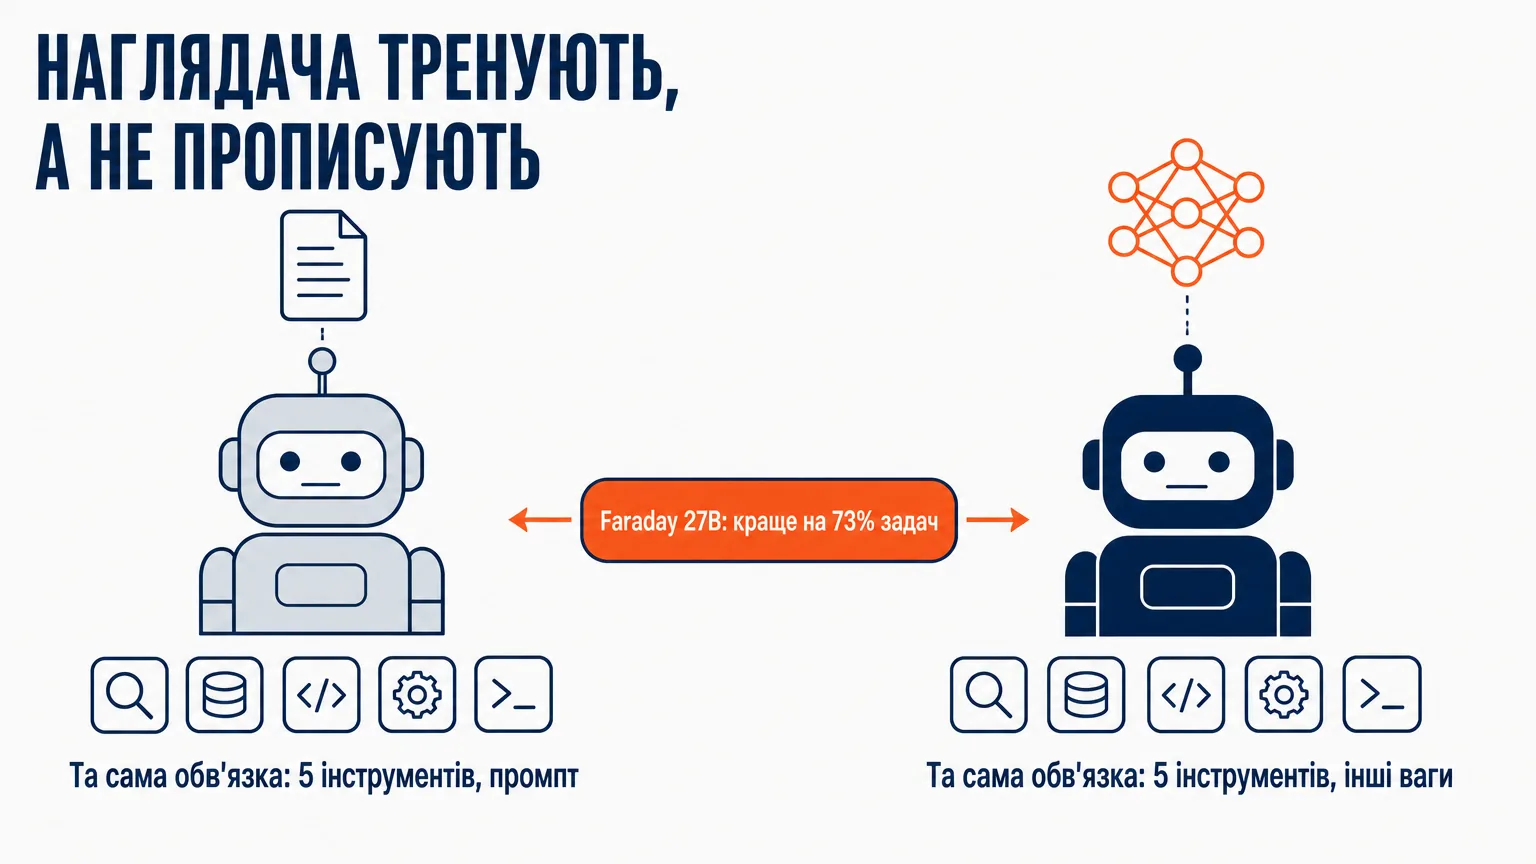
Inherent натренували Faraday на 27B: та сама обв'язка з п'яти інструментів, різниця лише у вагах — і це обходить Claude Opus 4.8 та GPT-5.5 на 73% задач.
Andrew Maryasov, AI-консультант, засновник Auspex і Grow2.ai. Коли агент працює погано, стандартна реакція — дописати інструкцію: ще один пункт у системному промпті, ще один guardrail, ще один шар перевірки поверх відповіді. У препринті Inherent про Faraday зроблено протилежне: обв’язку лишили примітивною — п’ять інструментів і лінійна історія без стиснення, — а міняли ваги моделі. Автори формулюють це прямо: наукові здібності агента покращуються «зміною вагів політики, а не ускладненням обв’язки». І оптимізація промпта в конкурента цей розрив майже не закриває. Нижче — що саме виміряли, чому переказ про «безперервне донавчання наглядача» не витримує звірки з першоджерелом, і за яких умов це взагалі має стосунок до бізнес-процесу.
TL;DR (за 30 секунд)
- Контрольований експеримент, а не демо. Faraday і базова Qwen3.6-27B крутяться в тій самій простій обв’язці, з тим самим Codex GPT-5.5 як інструментом. Відрізняються рівно одним: Faraday пройшов RL post-training на задачах Replica.
- Результат. Faraday обходить Claude Opus 4.8 і Codex GPT-5.5 на 73% задач у розподілі та на 60% відкладених задач з AI-for-science. У середньому +6% до Claude і +8% до Codex на тестовому спліті.
- Промпт цього не добирає. Автори окремо перевірили: оптимізація промпта для Codex «лише незначно зменшує розрив».
- Обв’язка навмисне тупа. П’ять інструментів (
apply_patch,read_file,list_dir,grep_files,shell), лінійна історія без компресії. Розум винесли у ваги. - Але «наглядач, що вчиться разом з агентом» — це переказ, а не стаття. У препринті це разовий offline post-training на train-спліті. Слова «continually» в тексті немає взагалі.
- Дефіцитний актив — не модель, а простір задач із машинним вердиктом. Саме його у більшості компаній немає, і саме він тут коштував найдорожче.
Що не купує написана інструкція
Дефолтна реакція на кривого агента — текст. Написати чіткіше. Перелічити заборони. Додати приклад правильної поведінки. Це дешево, робиться за годину і іноді справді допомагає.
Проблема в тому, що ефект від цього виміряний — і він скромніший, ніж хочеться. У Stanford перевіряли найпряміший варіант: у системному промпті прямим текстом перелічені класи вразливостей, яких треба уникати. Модель усе одно пише дірявий код у 23% випадків. Я розбирав ці цифри окремо — скільки реально дає системний промпт як шар безпеки.
Інструкція — це не механізм, це побажання. Вона працює рівно доти, доки модель звертає на неї увагу, і не має жодного способу дізнатися, що її проігнорували.
І от тут цікаво подивитися на роботу, де від цього шляху відмовились свідомо.
Що зробили в Inherent
13 серпня 2026 року команда Inherent виклала препринт «Training AI Scientists to Replicate Research» — одинадцять авторів, серед них Едвард Х’юз і Луї Кірш.
Задача звучить вузько: навчити агента відтворювати результати наукових статей. Взяли 100 робіт з машинного навчання та AI-for-science, опублікованих між 1990 і 2026 роками. З кожної Gemini 2.5 Pro вирізав окремі графіки результатів — кожен вирізаний графік перетворюється на одну задачу. Разом вийшло 310 задач; цей набір автори назвали Replica.
Агент отримує контейнер, у ньому — PDF статті з дірками замість результатів, бінарник Codex, набір дослідницьких бібліотек, доступ в інтернет і одну сьому MIG-слайса H200. Година часу. Треба поставити експеримент і дістати той графік, якого бракує.
Оцінює результат суддя. Для кожної задачі Claude Opus 4.7 за коротким рукописним мета-промптом генерує власну рубрику — п’ять вимірів: наскільки відтворений графік візуально збігається з оригіналом, чи підтримує він наукове твердження статті, чи справді експеримент реалізує те, що описано, чи розумно витрачено обчислювальний бюджет, і чи агент поводився чесно та не шахраював. Оригінальний графік від генератора рубрики ховають, щоб рубрика ловила суть твердження, а не діапазони осей.
Далі на цьому сигналі роблять Faraday — 27-мільярдну модель, дообучену з Qwen3.6-27B через LoRA і turn-level варіант GRPO.
Розум переїхав з обв’язки у ваги
Головне речення роботи — в розділі про обв’язку:
«Наукові здібності Faraday покращуються зміною вагів його політики, а не ускладненням обв’язки».
Обв’язку побудували за трьома принципами: проста й інтерпретована, максимально дозвільна, з мінімальним набором інструментів. На практиці це п’ять функцій — apply_patch, read_file, list_dir, grep_files, shell — і лінійна історія діалогу, яку не стискають взагалі. Переповнення контексту просто обриває епізод, і обірваний епізод судять як усі інші.
Ніякої оркестрації, ніякого дерева підагентів, ніяких хитрих правил компакції. Порожньо навмисне.
А тепер порівняйте з тим, як зазвичай виглядає «покращення агента» в продукті: третя ітерація системного промпта, роутер, валідатор поверх відповіді, ретраї за regexp.
Найважливіше для висновку — не сам результат, а те, як влаштоване порівняння. Автори пишуть, що Faraday і базова Qwen3.6-27B «працюють у тій самій простій обв’язці, з доступним Codex GPT-5.5 як інструментом для коду; вони відрізняються лише тим, що Faraday пройшов RL post-training на Replica».
Одна змінна. Не «нова архітектура проти старої», не «краща модель проти гіршої» — та сама обв’язка, той самий інструмент, та сама база. Різниця тільки у вагах.
Результат: Faraday обходить Claude Opus 4.8 і Codex GPT-5.5 на 73% задач у розподілі й на 60% відкладених задач з AI-for-science, за оцінкою тієї ж рубричної судді. У середньому це +6% до Claude і +8% до Codex на тесті. Люди-експерти, яким дали ті епізоди, де суддя бачить перевагу Faraday, підтверджують ранжування.
Окремо автори спробували закрити відставання найдешевшим способом — переписали й оптимізували промпт для Codex. Це, за їхніми словами, «лише незначно зменшує розрив».
Де переказ розійшовся з першоджерелом
Про цю роботу я дізнався з Import AI 469 — і саме там формулювання, яке варто виправити, поки воно не пішло далі.
У переказі сказано, що невелику наглядову модель тренують безперервно — наглядач, який еволюціонує разом із піднаглядним. У препринті цього немає. Слова «continually» в тексті немає жодного разу, а «continuous» стосується виключно неперервної шкали оцінки судді від нуля до одиниці. Faraday — це разовий offline post-training на train-спліті Replica, після якого ваги фіксуються.
Різниця не косметична. «Наглядач, що донавчається в реальному часі» — це операційна обіцянка, під яку хтось спланував би моніторинг, дрейф і відкати. «Модель, дообучена один раз на зібраному наборі задач» — це проєкт з датасетом, який має початок і кінець.
Я звірявся не з переказом, а з препринтом, і рекомендую те саме кожному, хто збирається переносити такі речі у план робіт.
Три сходинки, на яких може стояти ваш eval
Якщо зібрати це з тим, що вже писав раніше, вимальовується градація. Це не сходи, якими треба обов’язково йти вгору, — радше шкала того, наскільки дорого вам обійшовся ваш вимірювач і скільки він за це віддає.
Найнижча — коли eval просто перевіряє відповідь. Класичний LLM-as-judge поверх готового результату: правильно чи неправильно. Дешево, статично, дає контроль якості й нічого більше.
Вище — коли той самий вердикт починає ранжувати кандидатів. Щойно оцінку ставить машина, можна запускати багато спроб і брати кращу; про цю конструкцію я писав окремо в тексті про те, коли флот агентів виграє в одного.
Faraday стоїть на третій. Оцінки судді перетворюються на градієнти, і поведінка агента переїжджає з тексту інструкції у ваги. Різниця з попередньою сходинкою не в тому, що вимірювач став точнішим — він той самий. Змінилося те, куди йде його вихід: раніше у звіт для людини, тепер у процедуру оптимізації. З цього моменту ваш набір задач перестає бути витратами на QA і стає тим, з чого зроблена сама модель.
Передумова на всіх трьох одна й та сама, і вона не про моделі. Потрібна задача, яку машина вміє скинути й перевірити без людини — агент без перевірки не вчиться, і ця стеля не рухається від того, скільки грошей вкладено в модель.
Ціна третьої сходинки
Щойно оцінка стає ціллю оптимізації, вона стає мішенню. Це не абстрактний ризик — я розбирав механіку і захисти в тексті про reward hacking, а вимірювання того, що монітор пропускає, — у розборі метрики ухиляння.
В Inherent на це відповіли конструкцією, а не окриком у промпті. Рубрику ховають від моделі під час навчання, щоб та не підганяла роботу під критерії. Оригінальний графік ховають від генератора рубрики. Чесність винесена в окремий, п’ятий вимір оцінки — суддю прямо просять дивитися, чи агент не шахраював. Суддю опитують тричі на епізод, щоб зменшити розкид, і дають йому десять хвилин та право перезапустити код агента.
Аргумент авторів тонший, ніж «ми додали перевірку». Верифікована нагорода, кажуть вони, вимагає описати процедуру оцінки наперед — і саме тому вона стає нерухомою мішенню. Суд над цілим епізодом заднім числом — мішень рухома.
Звучить переконливо. Але тут же поруч вони пишуть, що чи здатне навчання на відкритих задачах масштабно прибрати reward hacking — «лишається невідомим».
Ось цю обережність із першоджерела варто нести далі, а не губити її по дорозі.
Чому це поки не рецепт для вашого процесу
Кілька речей, які легко втратити при переносі.
Середовище замкнене й машинно перевірне. Є «золотий» графік з оригінальної статті, з яким можна звіритися. У бізнес-процесі еквівалента зазвичай немає: немає опублікованої правильної відповіді на питання «чи добре менеджер відпрацював цього ліда».
Масштаб задач навмисне маленький: година, одна сьома H200. Автори чесно кажуть, що обмежили горизонт заради пропускної здатності RL. Окремо вони перевірили вісім задач із більшими ресурсами — до восьми годин і восьми B300 — і там Faraday теж у середньому попереду, але це вісім точок, а не закономірність.
І пряма цитата з розділу про обмеження: Faraday не зміг відтворити результати кількох робіт, щодо яких автори впевнені, що дослідження зроблено акуратно й описано чесно. Тобто негативний вердикт цієї машини поки не є вироком статті. Люди все одно мусять дивитися.
Ще одна деталь для тих, хто рахуватиме бюджет: суддя тут — не безкоштовна функція, а коуючий агент, який тричі на епізод десять хвилин колупає контейнер. Вартість вимірювання цілком може перевищити вартість самої генерації.
Що з цього справді робоче
Найкорисніше — не «дообучіть свою модель». Для переважної більшості компаній це передчасно на два кроки.
Корисніше інше. У вашій системі є місце, де живе розум агента, і ви його обираєте — хоч і рідко свідомо. Зараз він майже напевно живе в тексті — у промптах, регламентах, правилах роутера. Це найдешевше місце і найслабше: текст не має зворотного зв’язку, ніхто не помічає, коли його ігнорують, і кожна нова вимога робить його довшим.
Перехід на будь-яку наступну сходинку починається не з навчання, а з вимірювача. Питання, яке варто поставити собі цього тижня: чи є хоч один процес, де вердикт «вийшло / не вийшло» ставить машина, а не людина? Якщо є — у вас уже є актив, і з ним можна робити другу сходинку хоч завтра. Якщо ні, то дискусія про наглядові моделі для вас поки що академічна, і починати треба на два кроки раніше.
Ця робота цінна саме тим, що показала межу зверху: обв’язку можна лишити примітивною — п’ять інструментів і лінійна історія — за умови, що у вас є набір задач із чесним автоматичним суддею.
Дефіцитним активом виявилася не модель на 27 мільярдів параметрів, а сто розібраних статей із вирізаними графіками. Відбирали їх кураторськи, руками, і в препринті це найменш ефектна частина роботи.
FAQ
Що таке Faraday і хто його зробив?
Faraday — 27-мільярдна модель-агент від компанії Inherent, дообучена з Qwen3.6-27B для відтворення результатів наукових статей. Вона використовує зовнішній кодовий агент (Codex GPT-5.5) як інструмент. Препринт «Training AI Scientists to Replicate Research», arXiv:2608.13331, викладений 13 серпня 2026 року.
Що таке Replica?
Набір із 310 задач на відтворення графіків, згенерований зі 100 статей з машинного навчання та AI-for-science, опублікованих між 1990 і 2026 роками. З кожної статті вирізали окремі графіки результатів; кожен вирізаний графік — одна задача.
Наглядову модель справді тренують безперервно?
Ні. Це формулювання переказу Import AI, а не препринту. У статті описано разовий offline post-training на тренувальному спліті Replica; слова «continually» в тексті немає. Наглядач не донавчається разом з агентом у реальному часі.
Чим це відрізняється від LLM-as-judge?
Роллю оцінки. LLM-as-judge виносить вердикт про готову відповідь і на цьому зупиняється. Тут той самий вердикт перетворюється на нагороду, за якою міняються ваги моделі. Суддя не контролює результат, а формує поведінку.
Чому не можна досягти того самого кращим промптом?
Автори перевірили саме це: оптимізували промпт для Codex і зафіксували, що розрив зменшується лише незначно. Це не доводить, що промпт безсилий у принципі, — але показує, що в цій задачі він не заміняє post-training.
Наскільки надійний рубричний суддя?
Він помітно стабільніший за базовий: два незалежні прогони рубричної судді узгоджуються на рівні 0,66 за Kendall τ проти 0,46 у базової. Цікава деталь — двоє людей між собою узгоджуються лише на 0,30. Але узгодженість судді саме з людьми низька в абсолюті: 0,19 проти 0,15 у базової. Важливо, що замір робили на спеціально відібраних задачах, де судді розходяться найсильніше, тож це нижня оцінка, а не середня.
З чого почати, якщо машинної перевірки в нас немає?
З найвужчої ділянки, де правильну відповідь узагалі можна записати наперед. Зберіть кілька десятків реальних випадків із перевіреними людиною відповідями — це вже набір, на якому можна порівнювати варіанти інструкції між собою. Автоматичний суддя будується після цього, а навчання моделі — далеко після.
Джерела
- Training AI Scientists to Replicate Research — препринт, arXiv:2608.13331, Inherent, 13.08.2026. Основне джерело: Replica, Faraday, конструкція судді, обмеження
- Import AI 469 — Jack Clark, 17.08.2026, переказ роботи (звідти формулювання про «безперервне» навчання, якого немає в препринті)
- Безпека системного промпта: скільки він реально дає — вимірювання Stanford щодо написаних інструкцій
Опублікував Andrew Maryasov, засновник Auspex і Grow2.ai — впроваджую AI-агентів у бізнес-процеси.
Лист про AI — 2–3 листи на місяць
Особисті есе про те, як AI змінює мислення й роботу: що я спробував сам, що спрацювало, а що ні. Наприкінці — посилання на найкраще за останній час.
Без спаму. Відписатися можна в один клік.