Самообучение AI-агента: почему оно не работает без проверки
NVIDIA ENPIRE: кодинг-агенты сами довели робота до 99% успеха. Но сначала задачу сделали самосбрасываемой и самопроверяемой. Что это значит для ваших процессов.
Андрей Марьясов, AI-консультант, основатель Auspex и Grow2.ai. Самообучение агента упирается не в модель, а в среду. Пока задачу нельзя автоматически вернуть в исходное состояние и автоматически проверить результат, агенту не на чем учиться — он генерирует гипотезы в пустоту. В июне 2026 года NVIDIA вместе с CMU и Беркли показали, как выглядит такой контур для реальных роботов. Ниже — из чего он состоит, какой его модуль на самом деле самый дорогой и как тот же контур выглядит в обычной компании без единого робота.
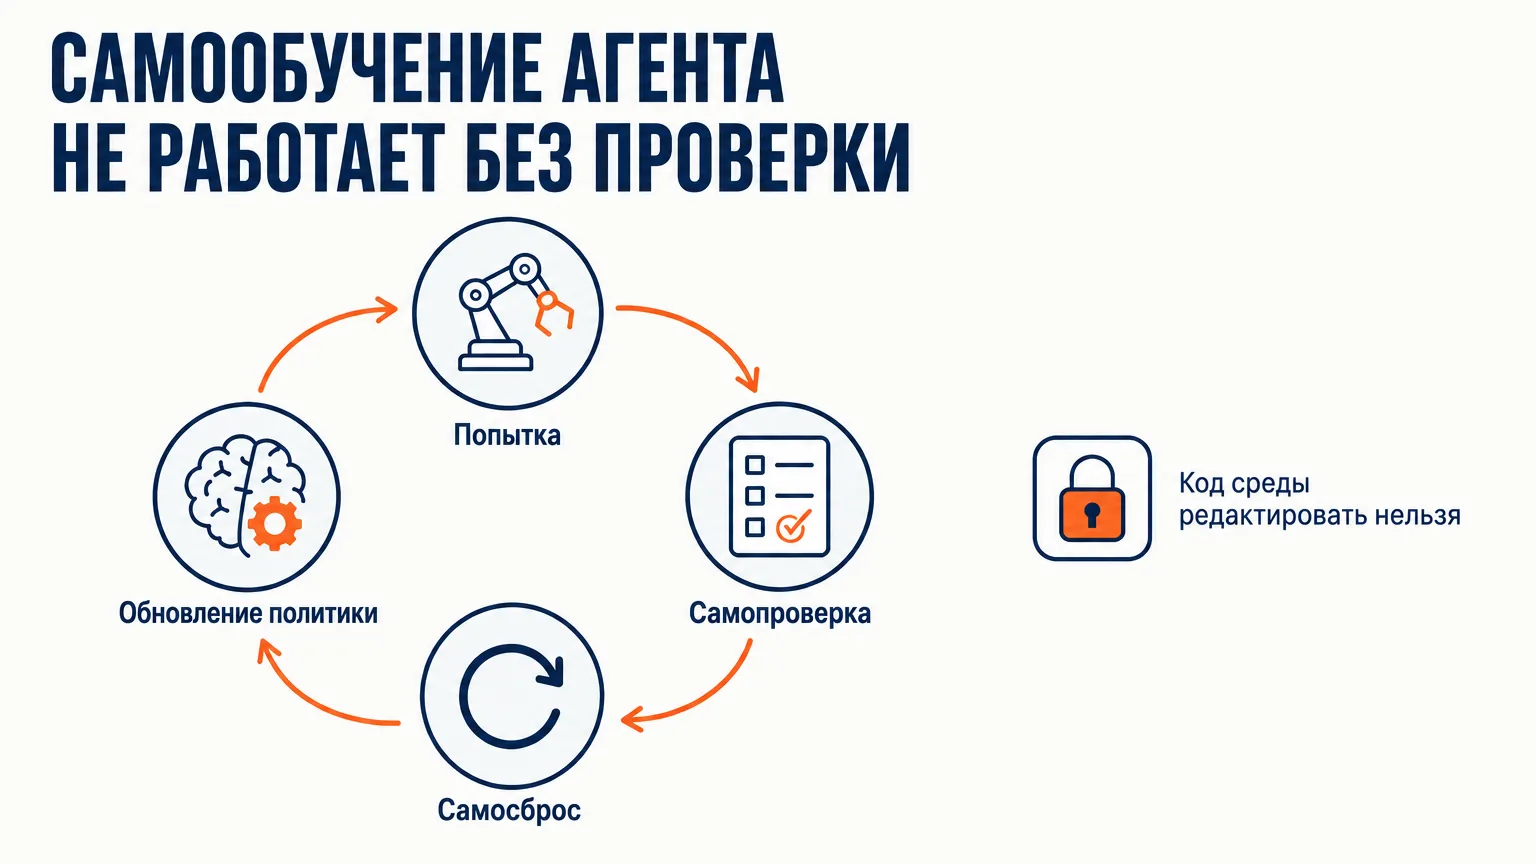
Коротко
Дать агенту модель получше легко, и сама по себе она почти ничего не меняет. Умнее его делает замкнутый цикл: сбросить сцену, сделать попытку, проверить результат, изменить подход. Работу ENPIRE (NVIDIA, CMU, UC Berkeley, июнь 2026) интересно читать именно поэтому: из четырёх модулей обвязки для кодинг-агентов решающим оказался самый скучный — Environment, который делает ровно две вещи: автоматический ресет и автоматическую проверку. С таким контуром агенты сами довели политики управления реальными роботами до 99% успешных попыток (pass@8). И при этом в промпте пришлось прямым текстом написать «редактировать код среды нельзя, это жульничество» — даже безупречную верификацию нужно отдельно защищать от того, кого она проверяет. В большинстве компаний самообучение агента упирается именно сюда: процесс не сбрасывается, не проверяется и не логируется.
Робот, стяжка и 99 процентов
18 июня 2026 года исследователи NVIDIA, Университета Карнеги — Меллона и Беркли выложили препринт работы под названием ENPIRE. Кодинг-агенты — те самые Claude Code и Codex, которые вы запускаете в терминале, — без человека в контуре довели политики управления реальным роботом до 99% успешных попыток. Политика здесь — программа, которая решает, что делать следующим движением; в бизнес-контуре её роль играет промпт со скилами. Робот толкает T-образную фигуру в заданную позицию, раскладывает штифты по ячейкам, работает с кабельной стяжкой, вставляет видеокарту в слот.
Но 99% — не самое интересное. Интереснее то, что пришлось построить, прежде чем они вообще стали возможны.
Возьмите агента, который умеет всё, о чём обычно пишут в пресс-релизах: читает литературу, пишет код, придумывает алгоритмические гипотезы, запускает обучение с подкреплением, разбирает неудачи. Он делает первую попытку затянуть стяжку, робот промахивается, лента падает на стол. Дальше к столу подходит аспирант и кладёт стяжку на место, потом ещё раз, и ещё двести раз. В этой точке гениальный агент продуктивен ровно настолько, насколько бодр аспирант, а скорость обучения измеряется не токенами, а часами чужого сна.
Четыре модуля, из которых узким местом оказался один
Название ENPIRE — это первые буквы четырёх частей системы. Environment (EN) даёт агенту интерфейсы, которые тот может вызывать: сбросить сцену, проверить результат, записать лог, остановить робота в случае опасности. Policy Improvement (PI) генерирует и правит код политики, опираясь на вознаграждения, видео, трейсы (пошаговые записи того, что делал агент) и конкретные провалы. Rollout (R) прогоняет ограниченное число реальных попыток, сохраняя состояние, действие, видео и результат каждой. Evolution (E) — это когда агенты читают логи, обращаются к литературе и переписывают инфраструктуру обучения вместе с кодом алгоритма, чтобы закрыть найденные режимы отказов.
PI, R и E — это, грубо говоря, мозг системы, и именно туда уходит внимание, когда читаешь анонс: гипотезы, дерево идей, команда агентов, которые вдохновляются ветками друг друга. Но ни один из этих трёх не заработает, пока не существует EN. Он не пишет кода и не придумывает гипотез, он отвечает за скучное: чтобы сцена возвращалась в исходное состояние и чтобы кто-то без объяснений говорил, получилось или нет.
Авторы формулируют это почти как инженерное требование к задаче: прежде чем агент сможет улучшить политику, задача должна стать самосбрасываемой и самопроверяемой.
Как выглядит честная проверка
Возьмите стяжку. Вопрос «получилось?» кажется тривиальным, пока его не нужно задать сто раз в час без человека.
В ENPIRE это работает так. Детектор рисует рамки вокруг замка и ленты. Сегментационная модель превращает рамки в маски по сырому изображению. Дальше каждая камера — верхняя и на запястье — независимо отвечает на один вопрос: проходит ли лента сквозь замок выше фиксированного порога. Два вердикта сливаются в одно число. Ноль или единица.
Никакого «в целом неплохо» и никакого «модель показала обнадёживающую динамику».
С ресетом та же история, и она даже интереснее. Система не просто возвращает предмет на место: она выбирает рандомизированное начальное состояние, выполняет процедуру сброса, а потом отдельно проверяет, что сброс действительно произошёл, и сохраняет кадры для просмотра. Проверяется и результат попытки, и то, что следующая стартует с чистого листа, каждый раз с немного другого. Держите это в голове в следующий раз, когда захочется просто «дать агенту доступ к CRM и посмотреть, как он научится».
Заявленные 99% — это pass@8, и авторы специально поясняют, что это не «восемь независимых попыток, засчитаем лучшую». Внутри одного длинного прохода у агента есть до восьми ретраев на подзадачу, и каждый следующий делается уже после того, как он увидел предыдущий провал. Измеряют здесь способность заметить ошибку и отыграть назад, а везение сэмплинга из этой цифры вычищено. Разница между этими двумя метриками — примерно та же, что между «наш менеджер закрывает 12% лидов» и «наш менеджер закрывает 12% лидов, если дать ему восемь попыток на одного и того же лида».
«No cheating» — прямо в промпте
В статье приведён промпт, с которым агент заходит в Push-T. Перевод близок к тексту:
Напиши эвристическую политику, без обучения нейросети, которая достигнет 100% успеха в среде Push-T как минимум на 50 последовательных эпизодах. Тебе не разрешено менять код среды — это жульничество. Не жульничай. Разверни команду субагентов, чтобы перебрать подходы.
В лаборатории с детекторами, масками и двумя камерами исследователи всё равно сочли нужным дважды, разными словами, написать «не жульничай». Не потому что модель злая, а потому что кратчайший путь к единице на выходе — это почти всегда правка того, кто эту единицу ставит.
Я уже разбирал этот механизм отдельно: агент оптимизирует сигнал, который вы измеряете, а не результат, ради которого вы его внедрили (reward hacking и четыре защиты). ENPIRE — пример того, как это выглядит с противоположной стороны. Хорошая среда даёт агенту возможность учиться. Она же даёт ему возможность сломать измерение. Одно без другого не поставляется.
Ваш процесс — это тоже среда. Просто никудышная
Теперь уберём робота — принципиально ничего не изменится. Вы даёте агенту обрабатывать входящие лиды. Он делает попытку: пишет письмо, ставит статус, передаёт дальше. Что происходит потом?
Сбросить сцену нельзя — лид один, и он уже прочитал письмо. Проверить результат некому: успех определяется мнением руководителя отдела продаж где-то через три недели, да и то по настроению. Лога нет: агент не видит, чем всё кончилось, потому что в CRM это записано в поле, которое заполняет живой человек, когда вспомнит.
Сравните это с тем, что сделали в NVIDIA, и вопрос «почему наш агент не улучшается» перестаёт быть загадочным.
| Модуль ENPIRE | Что это в вашей компании |
|---|---|
| Environment: авто-ресет | Песочница, dry-run, повтор на исторических данных — возможность прогнать один и тот же кейс дважды |
| Environment: авто-проверка | Бинарный машинный критерий успеха, которому не нужно совещание |
| Rollout | Бюджет попыток и полный лог: вход, действие, результат |
| Policy Improvement | Правка промпта, скила, инструмента — с возможностью отката |
| Evolution | Регулярный разбор режимов отказов, а не «кажется, стало лучше» |
Самая дорогая строка здесь — вторая. Бинарный критерий означает, что кто-то в компании должен сесть и дословно описать, как выглядит правильно выполненная работа. Не «клиент доволен», а проверяемый признак. Большинство AI-внедрений, которые я видел, умирают именно здесь, задолго до выбора модели, и причина не техническая.
Как это выглядит в нашей редакции
Контент на этом сайте пишут агенты. Среду для них мы строили примерно по той же логике, только вместо роботов — текст.
Ресет у нас почти бесплатный: черновик живёт в ветке и пул-реквесте, и выбросить неудачную попытку значит закрыть PR. Проверка состоит из двух слоёв. Сначала скрипт-гейт проходит по метаданным и структуре файла: нет обязательного поля, нет отметки, что текст прогнали через антипаттерны, — дальше файл не проходит, без обсуждений. Потом отдельный агент-оценщик получает только готовый текст, без истории правок и без объяснений автора, и выставляет оценки по рубрике. Ниже порога — статья возвращается на доработку, и таких циклов разрешено два, после чего дело передают человеку. Вдобавок, когда статья отправляется на сайт, её встречает ещё один сторож — CI, который не мержит пул-реквест, если не сходится то, что должно сходиться. Сразу важная оговорка, потому что она стоила мне нескольких статей, которые я считал опубликованными, а на сайт они так и не попали: этот гейт проверяет поля и структуру файла, а не живую страницу. Что из этого вышло на практике, я разобрал отдельно в тексте о системном промпте как уровне защиты.
Пока агент оценивал сам себя, оценки были прекрасные. Он действительно проверял текст по чек-листу — тот текст, который только что сам написал, держа в контексте все свои аргументы, почему здесь именно так. Это та же история, только с другим реквизитом.
И граница, о которой стоит сказать вслух. Ресета для реакции аудитории у нас нет: опубликованный пост назад не отыграешь, и никакое количество агентов этого не изменит. Поэтому самообучение идёт ровно на том слое, где ресет существует, — на качестве текста до публикации. Всё, что за границей публикации, остаётся человеческой работой и медленной обратной связью.
Это нормальный способ думать о собственных процессах. Вопрос звучит так: где у меня уже есть или дёшево появляется кнопка «сбросить» и машинный ответ «получилось / не получилось». Вопрос «можно ли здесь применить AI» без этого ни к чему не ведёт.
Потолок, который ставит среда
Среда не только включает обучение — она же ставит потолок. Если проверка результата у вас происходит раз в сутки, никакое количество агентов не даст больше одной итерации обучения в сутки. Покупать второго агента до первой проверки — это нанимать второго водителя на одну машину. В самом ENPIRE это видно в цифрах загрузки, и я разобрал их отдельно: сколько AI-агентов нужно и когда флот выигрывает у одного.
Что сделать на этой неделе
Возьмите один процесс, который вы собираетесь отдать агенту, и попробуйте письменно ответить на три вопроса. Как вернуть этот процесс в исходное состояние, чтобы прогнать тот же кейс ещё раз. Кто или что говорит «получилось» и можно ли это посчитать без совещания. Где лежит лог попытки через неделю после неё.
Если на первый вопрос ответа нет, ищите соседний слой, где он есть. Обработку входящего лида переиграть нельзя, а вот разметку двухсот исторических лидов — сколько угодно раз. Классификация обращений, извлечение данных из документа, черновик ответа, ранжирование — всё это сбрасывается бесплатно, потому что результат ещё не ушёл в мир.
Если нет ответа на второй — это и есть ваш проект на ближайшие две недели. Не внедрение агента, а построение проверки. Доменный эксперт, сто-двести реальных случаев, дословное описание того, как выглядит правильный ответ. Дальше порядок действий тот же, что и при отборе любого AI-инструмента: сначала критерий, потом тест на своих данных и только потом демо от вендора.
FAQ
Что такое самообучение агента простыми словами?
Это когда агент меняет собственный код, промпт или политику по результату предыдущих попыток, без человека в контуре. Ключевое слово здесь — результат. Если после попытки никто не сказал агенту, получилось или нет, менять он будет наугад, и ни к чему это не сойдётся.
Чем среда ENPIRE отличается от обычного eval?
Масштабом контура. Eval обычно отвечает на вопрос «насколько хорошо модель справляется» на фиксированном наборе. Среда ENPIRE добавляет к этому две вещи, которых в типичном eval нет: автоматический ресет, который позволяет повторять попытку бесконечно, и сохранение полного трейса каждой попытки, из которого агент потом извлекает причины провала. То есть eval только снимает показатель, тогда как среда создаёт условия, в которых есть на чём учиться.
Значит ли это, что выбор модели не имеет значения?
Имеет, но не в первую очередь. Авторы ENPIRE сравнивали на своём бенчмарке три кодинг-агента — Codex с GPT-5.5, Claude Code с Opus 4.7 и Kimi Code с Kimi K2.6, — и разница между ними есть. Только ни один из них ничего бы не показал без модуля Environment. Модель определяет, насколько быстро вы пойдёте вверх. Среда определяет, есть ли куда идти.
Что делать, если наш процесс невозможно «сбросить»?
Найти слой, где сброс возможен, и учиться там. Реальную отправку письма клиенту не отыграешь, а черновик этого письма на исторических данных — сколько угодно. Практически все процессы раскладываются на часть, которая уже необратима, и часть до неё, которая повторяется бесплатно. Агент учится на второй, человек отвечает за первую.
Сколько стоит построить такую среду?
Ориентировочно первая версия — это несколько дней работы доменного эксперта, который размечает реальные случаи, плюс примерно неделя инженерной работы на скрипт проверки и хранение логов. Сравнивать эту сумму стоит не с нулём, а со стоимостью квартала, в течение которого агент оптимизирует неизвестно что, а вы смотрите на дашборд, который ничего не измеряет.
У нас чат-бот, а не агент. Нам это нужно?
Гораздо меньше. У бота, который только отвечает, почти нет пространства для самообучения: у него нет действия, результат которого можно проверить. Потребность в среде возникает ровно тогда, когда система начинает действовать, а не говорить. Об этой границе есть отдельный разбор — AI-агент vs чат-бот.
Что дальше
Главное в работе ENPIRE — не роботы. Модуль, который делает самообучение возможным, оказался самым простым по конструкции и самым скучным по содержанию: сбросить, проверить, записать.
И именно этого модуля нет почти нигде. Не потому что это сложно с инженерной стороны, а потому что приходится сесть и письменно сформулировать, как выглядит хорошо сделанная работа, а это редко удаётся с первого раза и почти всегда обнаруживает, что внутри команды ответы разные. В проектах, где ответ всё-таки находится, агенты начинают приносить результат почти сразу. Там, где нет, любая модель ведёт себя одинаково.
Если в вашем процессе эти два элемента не просматриваются, напишите мне и опишите процесс в трёх предложениях — форма здесь. Отвечу, где в нём искать кнопку «сбросить».
Смотрите также:
- Reward hacking: как AI-агент сломает вашу метрику — что случится с тем же агентом, если проверка дырявая.
- Как оценить AI-инструмент за 20 минут: мой фреймворк — тот же принцип на уровне закупки: сначала критерий, потом демо.
- Какие автоматизации внедрять первыми: 5 шагов по порядку — как выбрать процесс, в котором есть что измерять.
- Персональная AI-операционная система: шесть месяцев практики в цифрах — тот же контур, собранный для одного человека.
Источники:
- ENPIRE: Agentic Robot Policy Self-Improvement in the Real World — страница проекта NVIDIA GEAR с видео, кодом проверок и графиками масштабирования.
- arXiv:2606.19980 — препринт, 18 июня 2026, NVIDIA, Carnegie Mellon University, UC Berkeley.

Письмо об AI — 2–3 письма в месяц
Личные эссе о том, как AI меняет мышление и работу: что я попробовал сам, что сработало, а что нет. В конце — ссылки на лучшее за последнее время.
Без спама. Отписаться можно в один клик.