Сколько AI-агентов нужно: когда флот выигрывает у одного
NVIDIA ENPIRE: флот агентов приходит к лучшему решению быстрее одного. Разбираю условие, при котором это работает, и почему «один агент» остаётся дефолтом в бизнесе.
Андрей Марьясов, AI-консультант, основатель Auspex и Grow2.ai. Правило «сверни цепочку из двенадцати агентов в одного с сильным eval» держится ровно до тех пор, пока задача eval — проверить ответ. Там, где он способен ранжировать много кандидатов, а правильный ответ заранее неизвестен, флот агентов приходит к лучшему решению быстрее одного. Условие здесь не «сколько агентов вы можете запустить», а «существует ли автоматический вердикт». Ниже — что именно измерили в NVIDIA, почему вторая половина того же результата говорит об обратном и при каких трёх условиях это вообще переносится на бизнес-процессы.
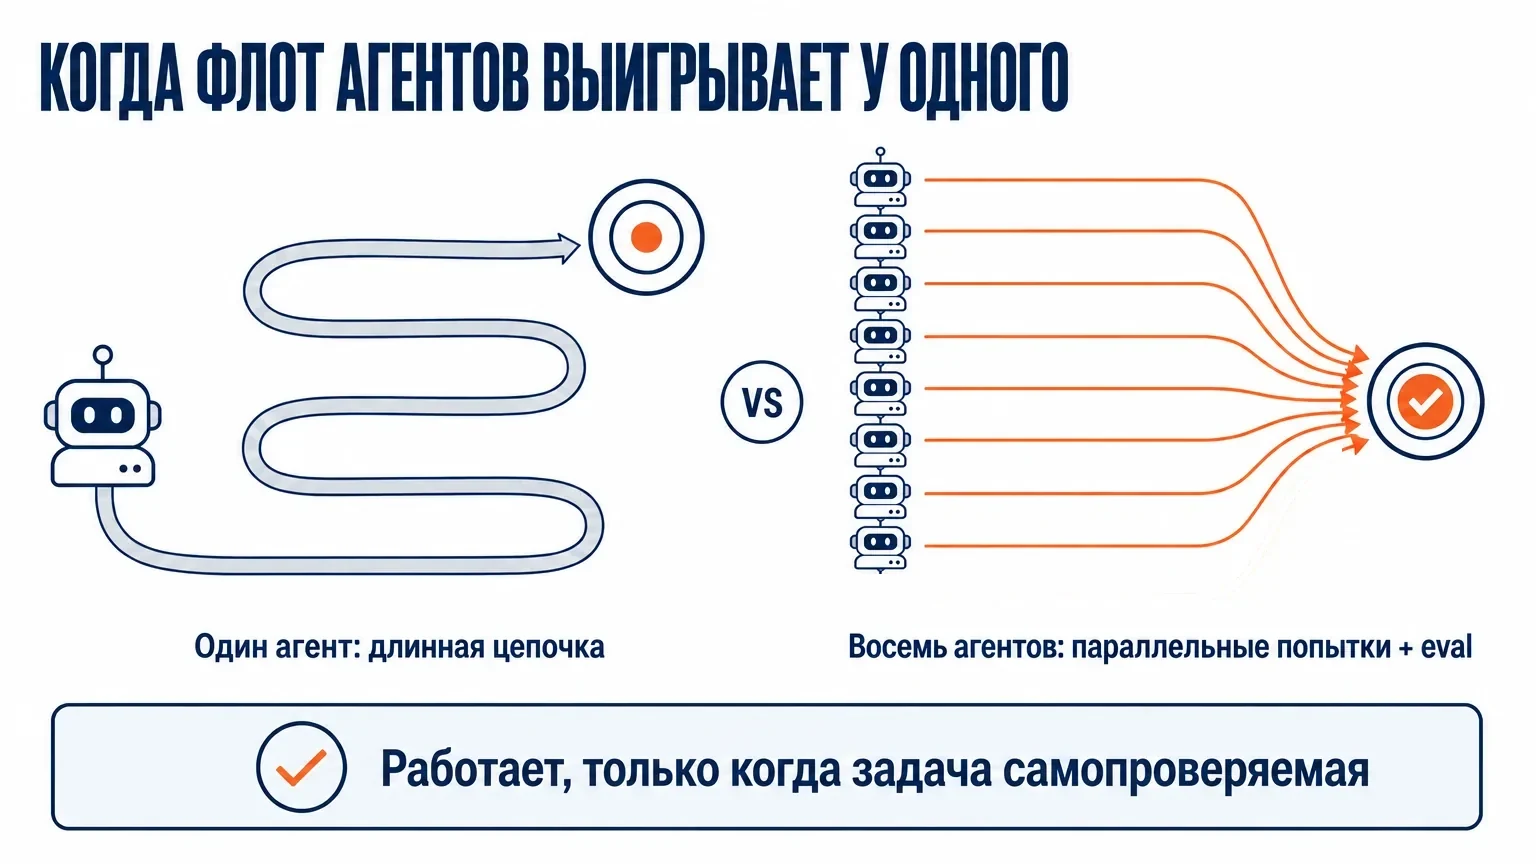
Восемь
Число, ради которого эту работу цитируют, — восемь. В проекте ENPIRE (NVIDIA, CMU, UC Berkeley, июнь 2026) большее число агентов, в пересказе Import AI это порядка восьми, раньше приходит к решениям с более высокой оценкой, и иногда мультиагентная конфигурация даёт более высокий абсолютный балл, чем одиночная. Причину авторы пересказа называют вероятной, а не установленной: более широкое исследование пространства решений.
Число здесь — наименее интересное. Флот в ENPIRE возможен только потому, что в системе уже есть автоматический вердикт «получилось / не получилось»; без него восемь агентов выдают восемь текстов, которые кто-то должен прочитать. Более того, та же работа содержит противоположный по настроению результат: с ростом числа роботов средняя загрузка робота падает, потому что агент читает логи, пишет код и ждёт модель, пока дорогое железо стоит. На бизнес отсюда переносятся три условия: результат проверяется автоматически, среда сбрасывается без последствий, пространство решений действительно широкое. Первые два проваливает большинство процессов в компаниях.
Правило, которое сейчас повторяют все
Формулировка ходит в разных вариантах, но суть одна: если вы можете написать сквозной eval для задачи (набор примеров с правильными ответами плюс скрипт, который ставит оценку без человека) — сверните цепочку из пяти или двенадцати агентов в одного с отлаженным промптом.
Чётче всего оно сформулировано в AI-Native Playbook (раздел 3.4, автор — Gerstep): «Мультиагентная цепочка — это человеческий способ справиться со сложностью, а не ответ на неё». То есть команды разбивают задачу на агентов не потому, что задача этого требует, а потому, что не удерживают в голове сложность одного промпта. Eval удерживает её вместо них.
Аргументы в пользу этого правила сильные, и я с ними не спорю. Координационные издержки в мультиагентных системах съедают большую долю токенов: контекст сериализуется в JSON, пересылается на каждом переходе, заново разбирается на другой стороне. Большинство корпоративных процессов монотонны, упорядочены и предсказуемы, без каких-либо адаптивных решений — мультиагентная архитектура им не нужна вообще.
Я и сам писал, что сбои мультиагентной системы случаются на стыках между агентами, а не внутри них, и каждый новый агент — это новый стык.
С аргументами всё в порядке. Плохо то, что правило почти всегда приводят без предпосылки, при которой оно истинно.
Что именно показал ENPIRE
18 июня 2026 года исследователи NVIDIA, Университета Карнеги — Меллона и Беркли выложили препринт ENPIRE — обвязку, которая даёт кодинг-агентам замкнутый цикл для обучения политик реальных роботов.
Об одном её модуле я уже писал отдельно. Environment делает две скучные вещи — автоматически сбрасывает сцену и автоматически проверяет результат, — и без него не работает ни один из трёх «умных» модулей. Тогда меня интересовало именно это: пока задача не стала самосбрасываемой и самопроверяемой, агенту не на чем учиться.
Сейчас меня интересует другая половина той же работы — та, что про количество агентов.
Авторы формулируют в аннотации на странице проекта: «ENPIRE можно существенно ускорить на флоте роботов» — и предлагают две метрики, Mean Robot Utilization (MRU) и Mean Token Utilization (MTU), чтобы измерять эффективность мультиагентного физического автоисследования. Не количество агентов. Загрузку.
Jack Clark в Import AI 463 (29 июня 2026) подытоживает результат так: есть убедительная отдача от масштабирования агентов, большее их число — например, восемь — приходит к решениям с более высокой оценкой раньше остальных, и иногда мультиагентная конфигурация даёт более высокий абсолютный балл, чем одиночная, вероятно из-за более широкого исследования пространства возможных решений.
Два уточнения, без которых это число легко преувеличить. «Например, восемь» — это формулировка пересказа, а не пороговое значение из работы; публичный конспект не приводит кривой отдачи, так что «восемь» стоит читать как порядок, а не как настройку. И слово «иногда» здесь весит много: более высокий абсолютный балл в мультиагентной конфигурации случается, а не гарантирован.
Устроен этот флот так. На проектной странице есть схема поиска в виде git-дерева гипотез: одна ветка на агента, одна точка на опробованную идею. Зелёным кольцом отмечена идея, которая подняла среднюю успешность команды, зелёными кривыми — перенос идей между агентами.
То есть это не фан-аут с голосованием: агенты ведут параллельные ветки, подсматривают друг у друга и ранжируются по одному общему числу, которое считает машина, вместо того чтобы усреднять выводы.
Почему это не опровержение правила, а его граница
Правило «один агент с сильным eval» молча предполагает, что правильный ответ по сути определён, а работа состоит в том, чтобы аккуратно его исполнить: оформить документ, провести транзакцию, пройти упорядоченные шаги регламента. В такой задаче eval — это контролёр на выходе, который говорит «правильно» или «неправильно» об одном результате. Второй агент здесь не добавляет нового ответа, он добавляет ещё один стык, на котором можно рассинхронизироваться.
ENPIRE решает задачу противоположного типа. Какой алгоритм научит робота затягивать кабельную стяжку, заранее не знает никто — ни исследователь, ни агент. Работа состоит не в том, чтобы исполнить известный ответ, а в том, чтобы его найти. Здесь eval перестаёт быть контролёром и становится судьёй на турнире: он сравнивает много кандидатов и упорядочивает их.
У этого повышения есть цена, о которой стоит сказать сразу. Как только eval становится судьёй, по которому ранжируются кандидаты, он превращается в мишень: оптимизировать оценку всегда дешевле, чем оптимизировать результат. В ENPIRE это закрыли грубо — в промпте прямым текстом написано, что править код среды нельзя, это жульничество. Механику я разбирал отдельно в тексте про reward hacking и четыре защиты; при переходе от одного агента к восьми риск не остаётся прежним, а умножается на число веток.
Отсюда разделение, которое я теперь считаю более точным, чем исходное правило:
Наличие автоматического eval определяет, возможен ли флот. Ширина пространства решений определяет, нужен ли он.
Без eval флот невозможен — не потому, что дорого, а потому, что восемь параллельных результатов без автоматического вердикта превращаются в восемь текстов, которые читает человек. В этот момент человек и есть eval, а число агентов упирается в его внимание.
При узком пространстве решений флот не нужен — даже с идеальным eval. Если ответ один, восемь агентов найдут один и тот же ответ восемь раз.
Вторая половина результата: железо простаивает, пока агент думает
Та же работа содержит результат, который редко цитируют вместе с «восемью агентами». Авторы пишут прямо в разделе об ограничениях на странице проекта:
Кодинг-агенты не полностью используют ресурсы робота, когда читают логи, пишут код, отлаживают или ждут языковую модель, на которой они работают. С ростом числа роботов MRU снижается, тогда как активная загрузка GPU растёт.
Дорогое и дефицитное здесь — робот. Он физический, ещё восемь штук командой в терминале не поднимешь. Агент, наоборот, дешёвый и параллельный. Когда вы добавляете роботов, узкое место переезжает с физического слоя на слой мышления: станция с парой манипуляторов, камерами и собственной RTX 5090 стоит и ждёт, пока агент дочитает логи и дождётся ответа модели.
Именно поэтому авторы и предложили MRU с MTU. Метрика флота звучит так: какая доля дефицитного ресурса реально работает. Количество запущенных агентов на этот вопрос не отвечает.
Поэтому результат и не читается как реклама флотов: в той же работе, где больше агентов даёт лучший балл, рост числа роботов одновременно ухудшает загрузку железа. Две оси масштабирования тянут в разные стороны, а цитируют обычно одну.
Три условия, при которых это переносится на бизнес
ENPIRE — про самообучение политик робота силами кодинг-агентов. Ваш процесс согласования договоров — другая задача, и прямой перенос здесь был бы подменой. Перенос корректен только тогда, когда ваша задача воспроизводит три свойства среды ENPIRE.
Первое: результат проверяется автоматически. Не «руководитель посмотрит», а машина ставит ноль или единицу без человека в контуре. В ENPIRE это детектор и сегментационная модель, которые независимо с двух камер отвечают на один вопрос. В вашем случае это могут быть тесты, сверка с эталонным набором, проверка схемы. Если вердикт выносит человек — условие не выполнено, и дальше можно не читать.
Второе: среда сбрасывается без последствий. Попытку можно повторить с чистого листа, и неудачная попытка никому ничего не стоит. Робот кладёт стяжку обратно. Клиент, которому агент уже отправил письмо, обратно не сбрасывается. Большинство бизнес-процессов необратимы именно здесь, и это главная причина, почему параллельный поиск в них не запускают.
Третье: пространство решений действительно широкое. Есть много независимых способов сделать работу, и вы заранее не знаете, какой лучше. Если способ один и он описан в регламенте — вам нужен надёжный исполнитель, а не поиск.
Три из трёх — можно думать о флоте. Два из трёх — нельзя, и чаще всего проваливается второе.
Где флот оправдан в обычной компании
Участки, где все три условия сходятся, существуют, просто их меньше, чем кажется по анонсам.
Код с тестами — канонический случай: вердикт выносит тестовый прогон, откат бесплатный, способов реализации много. Извлечение данных из документов, когда у вас есть размеченный эталонный набор на сотню образцов: восемь вариантов экстрактора ранжируются по точности на этом наборе автоматически.
Ближайший аналог того, что делает ENPIRE, — поиск самой инструкции для агента. Вы фиксируете eval-набор, генерируете восемь вариантов промпта или скила, прогоняете каждый по набору и берёте тот, что дал лучший балл. Это ровно та же конструкция: параллельные ветки, общее число, ранжирование вместо усреднения. И она доступна любой компании, которая сумела собрать пятьдесят примеров с правильными ответами.
А вот «восемь агентов пишут вам коммерческие предложения» в этот список не входит. Автоматического вердикта, который отличит лучшее предложение от худшего до отправки клиенту, не существует. Вы получите восемь документов и человека, который их читает.
Отдельно стоит назвать ловушку в интерпретации. Выигрыш восьми агентов в ENPIRE измерен как время до лучшего решения в исследовательском поиске, а не как пропускная способность на рутине. Если ваша задача — обработать очередь из двухсот одинаковых заявок, вы масштабируете пропускную способность, и это совсем другая механика. Путать «быстрее нашли» с «быстрее сделали» — самая дорогая ошибка при чтении таких результатов.
Коэффициенты надзора никуда не делись
Моё прикидочное правило после этой работы не изменилось, и это именно прикидка, а не замер: около десяти-двадцати агентов на одного супервизора там, где цена ошибки низкая, несколько — где средняя, и единицы там, где она финансовая, медицинская или юридическая. Числа выведены из того, сколько результатов успевает прочитать один человек за рабочий день, и в вашей команде они будут другими.
Проверить это можно на собственной кухне. У меня семнадцать агентов в Paperclip, и ни одной параллельной ветки среди них нет — все работают последовательно. Причина не в бюджете: дневной потолок на LLM я держу в районе пятнадцати долларов и ни разу в него не упёрся. Причина в том, что финальный вердикт по тексту выношу я, и восемь вариантов на входе означали бы восемь прочитанных текстов на выходе. Машинная проверка в контуре есть, но она смотрит на поля и структуру файла, а не на качество — ранжировать кандидатов по ней невозможно. Ровно та ситуация, которую описывает правило: eval, который проверяет, а не eval, который ранжирует.
Теперь видно, почему коэффициенты надзора именно такие. Они описывают среды, где автоматического eval нет и человек и есть eval. Когда вердикт выносит человек, число агентов упирается в его внимание, а бюджет и инфраструктура тут ни при чём. Чем выше ставка, тем внимательнее нужно смотреть и тем меньше агентов помещается в одну голову.
Ставка здесь измеряется не ощущениями, а объёмом ущерба и временем отката. Восемь агентов в песочнице с тестами и восемь агентов с доступом к боевой базе — это одна строка в дашборде и два разных коэффициента надзора.
Правило «не наращивай количество агентов» описывает мир без автоматического вердикта. Для большинства компаний это и есть их мир — поэтому правило остаётся разумным дефолтом, а не ошибкой.
Как звучит правило с предпосылкой
Исходную формулировку стоит достроить до такой:
Сворачивайте цепочку агентов в одного там, где ответ по сути определён, а eval проверяет результат. Разворачивайте флот там, где ответ нужно найти, а eval способен ранжировать кандидатов без человека. Нет автоматического eval — не делайте ни того, ни другого, сначала сделайте eval.
Практический порядок действий перед тем, как добавлять агентов:
- Спросите, существует ли машинный вердикт для этой задачи. Нет — дальше не идите, вся остальная дискуссия преждевременна.
- Спросите, известен ли правильный ответ заранее. Известен — вам нужен один надёжный исполнитель.
- Спросите, что в вашем процессе служит дефицитным ресурсом вроде робота и не начнёт ли он простаивать, пока агенты думают.
- Измеряйте загрузку этого ресурса, а не количество запущенных агентов.
Четвёртый пункт — прямой вывод из MRU. Количество агентов на дашборде ничего не говорит о том, работает ли то, за что вы платите. И как с любой метрикой агента, сначала назовите знаменатель: «загрузка 60%» без ответа на вопрос «от чего считали» — это просто число, а не показатель.
Чего эта работа не доказывает
ENPIRE не доказывает, что восемь агентов лучше одного вообще. Результат получен на одном классе задач — поиск алгоритма для обучения политики манипуляции — в среде с автоматическим сбросом и автоматической верификацией.
Кривой отдачи публичный пересказ не приводит, так что где начинается насыщение и где отдача становится отрицательной, мы не знаем. Бизнес-агентов эта работа не измеряет вообще, ни разу.
Координационные издержки она тоже не отменяет — она обходит их архитектурой, в которой агенты не передают работу друг другу по цепочке, а ведут независимые ветки с одним общим числом. Отдачу даёт форма, в которой агенты не мешают друг другу, а не их количество. Тот же флот из восьми агентов, собранный как последовательный конвейер, дал бы совсем другую картину.
FAQ
Сколько AI-агентов нужно бизнесу?
Столько, сколько ваш надзор способен проверить. Если вердикт о качестве работы выносит человек — по прикидочному правилу это десяток-другой агентов на супервизора при низких ставках, несколько при средних и единицы в финансах, медицине или юриспруденции; точные числа зависят от того, сколько результатов успевает прочитать ваш человек. Если вердикт автоматический, потолок поднимается, и ограничением становится загрузка дефицитного ресурса, а не внимание человека.
Когда флот агентов реально выигрывает у одного агента?
Когда одновременно выполнены три условия: результат проверяется машиной без человека, попытку можно повторить без последствий и есть много независимых способов сделать работу. В ENPIRE выполнены все три, и именно там большее число агентов приходит к лучшему решению раньше.
Значит ли это, что правило «один агент с сильным eval» ошибочно?
Нет. Оно верно для задач, где ответ по сути определён, а eval проверяет результат, — это большинство корпоративных процессов. Ошибочно не правило, а его применение без этой предпосылки к задачам поиска, где ответ заранее неизвестен.
Что такое MRU и MTU в ENPIRE?
Mean Robot Utilization и Mean Token Utilization — две метрики, которые авторы предложили для измерения эффективности мультиагентного физического автоисследования. Они измеряют, какая доля дефицитного ресурса реально работает, а не сколько агентов запущено.
Почему рост флота роботов ухудшает загрузку?
Потому что агент значительную часть времени думает, вместо того чтобы действовать: читает логи, пишет код, отлаживает, ждёт ответа модели. В это время физический ресурс простаивает. Авторы фиксируют это прямо: с ростом числа роботов MRU падает. Обратите внимание, что речь именно о масштабировании роботов, а не агентов — это разные оси, и работа измеряет просадку по первой.
Можно ли масштабировать агентов, если у нас нет автоматической проверки?
Технически можно, практически — это переносит нагрузку на человека. Восемь параллельных результатов без машинного вердикта означают восемь артефактов, которые кто-то прочитает. Сначала строится проверка, потом масштабируется количество.
С чего начать, если хочется попробовать параллельный поиск?
С самого дешёвого участка, где вердикт уже автоматический. Соберите пятьдесят-сто примеров с правильными ответами, сгенерируйте несколько вариантов инструкции для агента, прогоните каждый по набору и возьмите лучший по баллу. Это та же конструкция, что в ENPIRE, только без роботов.
Что дальше
Самое полезное, что можно вынести из этой работы, — порядок вопросов: сначала автоматический вердикт, потом ширина пространства решений и только потом количество агентов. Число «восемь» в этом списке вообще не нужно.
Компании обычно идут в обратном порядке и упираются в то, что дискуссия о количестве агентов была преждевременной на два шага.
Если вы сейчас решаете, сколько агентов запускать, — начните с вопроса, кто в вашем процессе ставит ноль или единицу. Если ответ «человек», то вы уже знаете свой потолок, и он не про агентов.
Источники:
- ENPIRE: Agentic Robot Policy Self-Improvement in the Real World — препринт, arXiv:2606.19980, 18.06.2026 (NVIDIA, CMU, UC Berkeley)
- Проектная страница ENPIRE — аннотация, метрики MRU/MTU, дерево гипотез
- Import AI 463 — Jack Clark, 29.06.2026, пересказ результата о масштабировании агентов
- AI-Native Playbook, 3.4 Making Agents Reliable — Gerstep, формулировка правила о сворачивании цепочки
Опубликовал Андрей Марьясов, AI-консультант, основатель Auspex и Grow2.ai; внедрения ведут Auspex (CRM) и Grow2.ai (AI-агенты).

Письмо об AI — 2–3 письма в месяц
Личные эссе о том, как AI меняет мышление и работу: что я попробовал сам, что сработало, а что нет. В конце — ссылки на лучшее за последнее время.
Без спама. Отписаться можно в один клик.