Cuántos agentes de IA se necesitan: cuándo una flota le gana a uno
NVIDIA ENPIRE: una flota de agentes llega a una mejor solución antes que uno solo. Cuándo funciona y por qué «un agente» sigue siendo lo habitual en los negocios.
Andrew Maryasov, consultor de IA, fundador de Auspex y Grow2.ai. La regla «reduce la cadena de doce agentes a uno solo con un eval sólido» se sostiene exactamente mientras la tarea del eval sea verificar la respuesta. Donde el eval puede ordenar muchos candidatos en un ranking y la respuesta correcta no se conoce de antemano, una flota de agentes llega a una mejor solución más rápido que uno solo. La condición aquí no es «cuántos agentes puedes lanzar», sino «si existe un veredicto automático». A continuación: qué midieron exactamente en NVIDIA, por qué la segunda mitad del mismo resultado dice lo contrario y bajo qué tres condiciones esto llega siquiera a trasladarse a los procesos de negocio.
Ocho
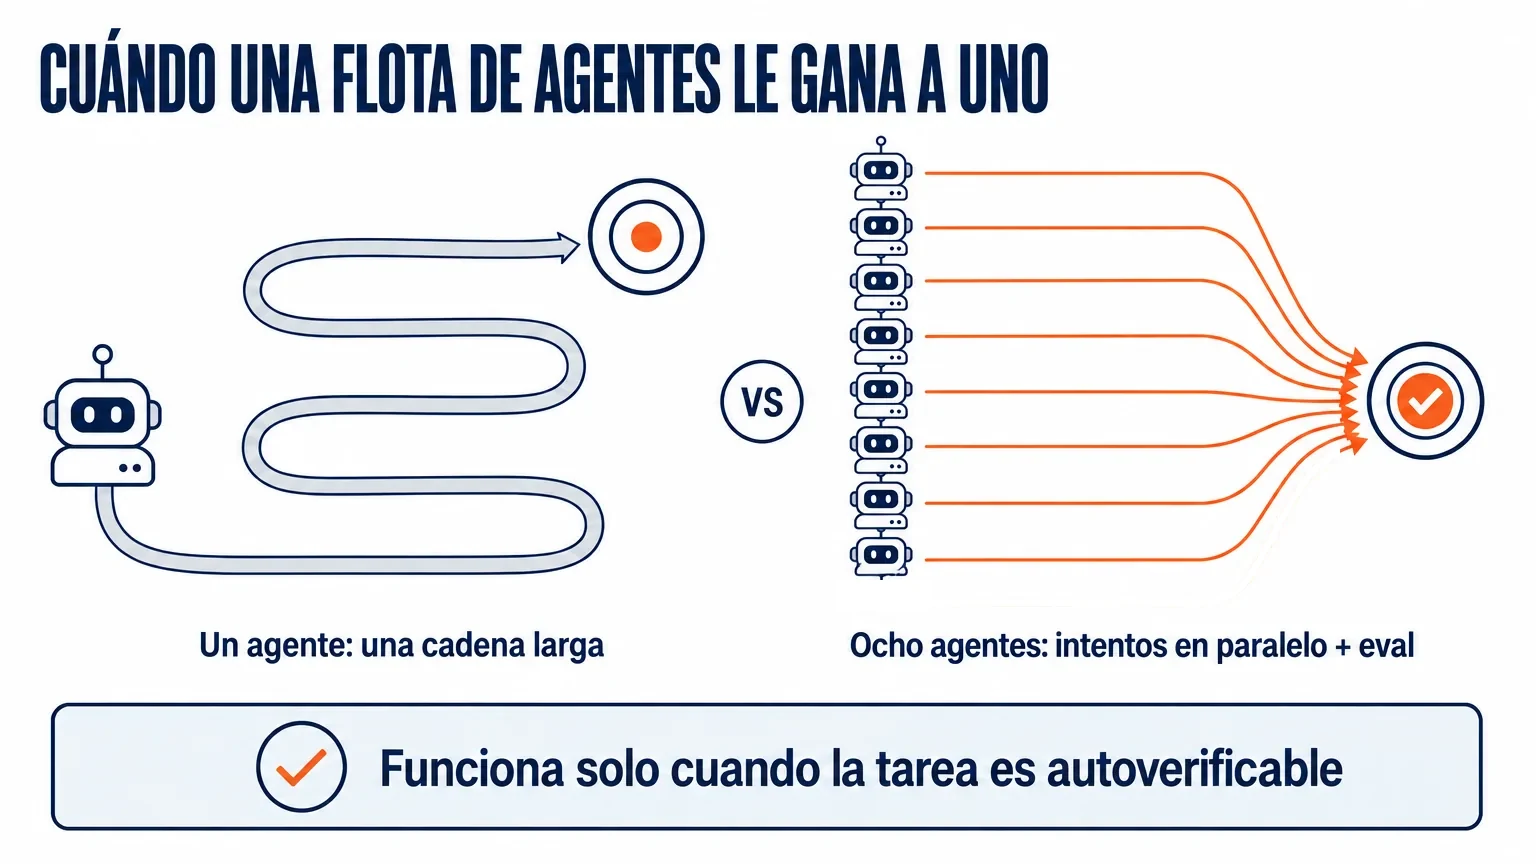
El número por el que se cita este trabajo es ocho. En el proyecto ENPIRE (NVIDIA, CMU, UC Berkeley, junio de 2026), un mayor número de agentes —del orden de ocho, según el resumen de Import AI— llega antes a soluciones con mejor puntuación, y a veces la configuración multiagente da una puntuación absoluta más alta que la de un solo agente. El resumen presenta la causa como probable, no como establecida: una exploración más amplia del espacio de soluciones.
El número es lo menos interesante. En ENPIRE la flota es posible solo porque el sistema ya tiene un veredicto automático «salió / no salió»; sin él, ocho agentes producen ocho textos que alguien tiene que leer. Es más, el mismo trabajo contiene un resultado de signo contrario: al crecer el número de robots, la utilización media de cada robot cae, porque el agente lee logs, escribe código y espera al modelo mientras el hardware caro está parado. De aquí se trasladan al negocio tres condiciones: el resultado se verifica automáticamente, el entorno se reinicia sin consecuencias y el espacio de soluciones es realmente amplio. Las dos primeras no las cumple la mayoría de los procesos de las empresas.
La regla que hoy repiten todos
La formulación circula en distintas versiones, pero la esencia es una sola: si puedes escribir un eval de extremo a extremo para la tarea (un conjunto de ejemplos con respuestas correctas más un script que pone la nota sin intervención humana), reduce la cadena de cinco o doce agentes a uno solo con un prompt bien afinado.
Donde mejor está formulada es en el AI-Native Playbook (sección 3.4, autor: Gerstep): «La cadena multiagente es una forma humana de lidiar con la complejidad, no una respuesta a ella». Es decir, los equipos dividen la tarea en agentes no porque la tarea lo exija, sino porque no logran sostener en la cabeza la complejidad de un solo prompt. El eval la sostiene por ellos.
Los argumentos detrás de esta regla son fuertes y no los discuto. Los costes de coordinación en los sistemas multiagente se comen una gran parte de los tokens: el contexto se serializa en JSON, se reenvía en cada traspaso y se vuelve a interpretar del otro lado. La mayoría de los procesos corporativos son monótonos, ordenados y predecibles, sin ninguna decisión adaptativa: la arquitectura multiagente no les hace falta en absoluto.
Yo mismo he escrito que los fallos de un sistema multiagente ocurren en las uniones entre agentes, no dentro de ellos, y que cada agente nuevo es una unión nueva.
Con los argumentos está todo bien. Lo malo es que la regla casi siempre se cita sin la premisa bajo la cual es verdadera.
Qué mostró exactamente ENPIRE
El 18 de junio de 2026, investigadores de NVIDIA, la Universidad Carnegie Mellon y Berkeley publicaron el preprint de ENPIRE: un harness que les da a los agentes de código un ciclo cerrado para entrenar políticas de robots reales.
Sobre uno de sus módulos ya he escrito aparte. Environment hace dos cosas aburridas —reinicia la escena automáticamente y verifica el resultado automáticamente— y sin él no funciona ninguno de los tres módulos «inteligentes». En ese momento me interesaba justo eso: mientras la tarea no sea autorreiniciable y autoverificable, el agente no tiene de qué aprender.
Ahora me interesa la otra mitad del mismo trabajo: la que trata del número de agentes.
Los autores lo formulan en el abstract de la página del proyecto: «ENPIRE se puede acelerar significativamente en una flota de robots», y proponen dos métricas —Mean Robot Utilization (MRU) y Mean Token Utilization (MTU)— para medir la eficiencia de la autoinvestigación física multiagente. No el número de agentes. La utilización.
Jack Clark, en Import AI 463 (29 de junio de 2026), resume el resultado así: hay rendimientos convincentes al escalar agentes; un mayor número de ellos —por ejemplo, ocho— llega a soluciones con mejor puntuación antes que el resto, y a veces la configuración multiagente da una puntuación absoluta más alta que la de un solo agente, probablemente por explorar una parte mayor del espacio de soluciones posibles.
Dos precisiones sin las cuales es fácil exagerar este número. «Por ejemplo, ocho» es la formulación del resumen, no un umbral tomado del trabajo; el resumen público no incluye una curva de rendimientos, así que conviene leer «ocho» como un orden de magnitud, no como un valor de configuración. Y el «a veces» aquí pesa: la puntuación absoluta más alta en la configuración multiagente se da, no está garantizada.
Esta flota está montada así. En la página del proyecto hay un esquema de la búsqueda en forma de árbol git de hipótesis: una rama por agente, un punto por cada idea probada. Con un anillo verde está marcada la idea que elevó la tasa de éxito media del equipo; con curvas verdes, el traspaso de ideas entre agentes.
Es decir, esto no es un fan-out con votación: los agentes llevan ramas paralelas, se miran de reojo entre sí y se ordenan según un único número compartido que calcula la máquina, en lugar de promediar conclusiones.
Por qué esto no refuta la regla, sino que marca su límite
La regla «un agente con un eval sólido» da por sentado, sin decirlo, que la respuesta correcta está en esencia definida y que el trabajo consiste en ejecutarla con cuidado: redactar un documento, registrar una transacción, recorrer los pasos ordenados de un procedimiento. En una tarea así, el eval es un inspector a la salida que dice «correcto» o «incorrecto» sobre un solo resultado. Un segundo agente aquí no aporta una respuesta nueva; aporta una unión más en la que se puede perder la sincronía.
ENPIRE resuelve una tarea del tipo opuesto. Qué algoritmo le enseñará al robot a cerrar un zip tie, nadie lo sabe de antemano: ni el investigador ni el agente. El trabajo no consiste en ejecutar una respuesta conocida, sino en encontrarla. Aquí el eval deja de ser un inspector y se convierte en juez de un torneo: compara muchos candidatos y los ordena.
Este ascenso tiene un precio que conviene mencionar de entrada. En cuanto el eval se vuelve el juez según el cual se ordenan los candidatos, se convierte en un blanco: optimizar la nota siempre es más barato que optimizar el resultado. En ENPIRE lo resolvieron de forma tosca: en el prompt dice con todas las letras que no se puede modificar el código del entorno, que eso es trampa. La mecánica la analicé aparte en el texto sobre reward hacking y cuatro defensas; al pasar de un agente a ocho, el riesgo no se queda igual, sino que se multiplica por el número de ramas.
De ahí sale una distinción que ahora considero más precisa que la regla original:
La existencia de un eval automático determina si la flota es posible. La amplitud del espacio de soluciones determina si hace falta.
Sin eval la flota es imposible, y no porque sea cara, sino porque ocho resultados paralelos sin veredicto automático se convierten en ocho textos que lee una persona. En ese momento la persona es el eval, y el número de agentes queda limitado por su atención.
Con un espacio de soluciones estrecho la flota no hace falta, ni siquiera con un eval perfecto. Si la respuesta es una sola, ocho agentes encontrarán la misma respuesta ocho veces.
La segunda mitad del resultado: el hardware está parado mientras el agente piensa
El mismo trabajo contiene un resultado que rara vez se cita junto con los «ocho agentes». Los autores lo escriben sin rodeos en el apartado de limitaciones de la página del proyecto:
Los agentes de código no aprovechan por completo los recursos del robot cuando leen logs, escriben código, depuran o esperan al modelo de lenguaje sobre el que funcionan. A medida que aumenta el número de robots, el MRU disminuye, mientras que la utilización activa de la GPU aumenta.
Lo caro y escaso aquí es el robot. Es físico: no se levantan ocho más con un comando en el terminal. El agente, en cambio, es barato y paralelo. Cuando añades robots, el cuello de botella se traslada de la capa física a la capa de pensamiento: una estación con un par de manipuladores, cámaras y su propia RTX 5090 queda parada esperando a que el agente termine de leer los logs y reciba la respuesta del modelo.
Justamente por eso los autores propusieron MRU y MTU. La métrica de la flota suena así: qué parte del recurso escaso está trabajando de verdad. El número de agentes lanzados no responde a esa pregunta.
Por eso el resultado tampoco se lee como publicidad de las flotas: en el mismo trabajo donde más agentes dan una mejor puntuación, el aumento del número de robots empeora al mismo tiempo la utilización del hardware. Los dos ejes de escalado tiran en direcciones distintas, y por lo general se cita uno solo.
Tres condiciones bajo las cuales esto se traslada al negocio
ENPIRE trata del autoaprendizaje de políticas de robot a cargo de agentes de código. Tu proceso de aprobación de contratos es otra tarea, y trasladar el resultado directamente sería hacer pasar una cosa por otra. El traslado es correcto solo cuando tu tarea reproduce tres propiedades del entorno de ENPIRE.
Primera: el resultado se verifica automáticamente. No «el jefe le echa un vistazo», sino que una máquina pone un cero o un uno sin una persona en el ciclo. En ENPIRE son un detector y un modelo de segmentación que, de forma independiente y desde dos cámaras, responden una misma pregunta. En tu caso pueden ser pruebas, una comparación contra un conjunto de referencia, una validación de esquema. Si el veredicto lo da una persona, la condición no se cumple y puedes dejar de leer aquí.
Segunda: el entorno se reinicia sin consecuencias. El intento se puede repetir desde cero, y un intento fallido no le cuesta nada a nadie. El robot vuelve a poner el zip tie en su lugar. Un cliente al que el agente ya le ha enviado un correo no se reinicia. La mayoría de los procesos de negocio son irreversibles justo aquí, y esa es la razón principal por la que en ellos no se lanza una búsqueda en paralelo.
Tercera: el espacio de soluciones es realmente amplio. Hay muchas formas independientes de hacer el trabajo y no sabes de antemano cuál es mejor. Si la forma es una sola y está descrita en el procedimiento, necesitas un ejecutor fiable, no una búsqueda.
Tres de tres: se puede pensar en una flota. Dos de tres: no, y la que falla más a menudo es la segunda.
Dónde la flota es legítima en una empresa normal
Las áreas donde coinciden las tres condiciones existen; simplemente son menos de lo que parece por los anuncios.
El código con pruebas es el caso canónico: el veredicto lo da la ejecución de las pruebas, revertir es gratis y hay muchas formas de implementarlo. La extracción de datos de documentos, cuando tienes un conjunto de referencia etiquetado de cien muestras: ocho variantes del extractor se ordenan automáticamente según su precisión sobre ese conjunto.
Lo más parecido a lo que hace ENPIRE es buscar la propia instrucción para el agente. Fijas un conjunto de eval, generas ocho variantes del prompt o del skill, ejecutas cada una sobre el conjunto y te quedas con la que obtuvo la mejor puntuación. Es exactamente la misma construcción: ramas paralelas, un número compartido, ranking en lugar de promediar. Y está al alcance de cualquier empresa que haya logrado reunir cincuenta ejemplos con respuestas correctas.
En cambio, «ocho agentes te escriben propuestas comerciales» no entra en esta lista. No existe un veredicto automático que distinga la mejor propuesta de la peor antes de enviársela al cliente. Vas a obtener ocho documentos y una persona que los lee.
Aparte conviene nombrar una trampa de interpretación. La ventaja de los ocho agentes en ENPIRE está medida como tiempo hasta una mejor solución en una búsqueda exploratoria, no como capacidad de procesamiento en tareas de rutina. Si tu tarea es procesar una cola de doscientas solicitudes idénticas, lo que escalas es la capacidad de procesamiento, y esa es una mecánica completamente distinta. Confundir «lo encontramos más rápido» con «lo hicimos más rápido» es el error más caro al leer este tipo de resultados.
Las proporciones de supervisión siguen ahí
Mi regla práctica no ha cambiado con este trabajo, y es justamente eso, una regla práctica, no una medición: alrededor de diez a veinte agentes por supervisor donde el coste del error es bajo, unos pocos donde es medio y contados donde es financiero, médico o legal. Los números salen de cuántos resultados llega a leer una persona en una jornada, y en tu equipo serán otros.
Esto se puede comprobar en casa. Tengo diecisiete agentes en Paperclip y no hay ni una sola rama paralela entre ellos: todos trabajan en secuencia. La razón no es el presupuesto: mantengo el tope diario de LLM en torno a quince dólares y nunca lo he alcanzado. La razón es que el veredicto final sobre el texto lo doy yo, y ocho variantes a la entrada significarían ocho textos leídos a la salida. Hay una verificación automática en el ciclo, pero mira los campos y la estructura del archivo, no la calidad: no sirve para ordenar candidatos. Es exactamente la situación que describe la regla: un eval que verifica, no un eval que ordena.
Ahora se ve por qué las proporciones de supervisión son precisamente esas. Describen entornos donde no hay eval automático y la persona es el eval. Cuando el veredicto lo da una persona, el número de agentes queda limitado por su atención, y el presupuesto y la infraestructura no tienen nada que ver. Cuanto más hay en juego, con más atención hay que mirar y menos agentes caben en una sola cabeza.
Lo que está en juego aquí no se mide por intuición, sino por el volumen del daño y el tiempo de reversión. Ocho agentes en un sandbox con pruebas y ocho agentes con acceso a la base de datos de producción son una misma fila en el dashboard y dos proporciones de supervisión distintas.
La regla «no aumentes el número de agentes» describe un mundo sin veredicto automático. Para la mayoría de las empresas ese es justamente su mundo; por eso la regla sigue siendo una opción por defecto razonable, no un error.
Cómo suena la regla con su premisa
Conviene completar la formulación original hasta dejarla así:
Reduce la cadena de agentes a uno solo donde la respuesta está en esencia definida y el eval verifica el resultado. Despliega una flota donde la respuesta hay que encontrarla y el eval es capaz de ordenar candidatos sin una persona. Si no hay eval automático, no hagas ni lo uno ni lo otro: primero haz el eval.
El orden práctico de acciones antes de sumar agentes:
- Pregunta si existe un veredicto de máquina para esta tarea. Si no, no sigas: todo el resto de la discusión es prematuro.
- Pregunta si la respuesta correcta se conoce de antemano. Si se conoce, necesitas un solo ejecutor fiable.
- Pregunta qué es, en tu proceso, el recurso escaso equivalente al robot, y si no empezará a quedar parado mientras los agentes piensan.
- Mide la utilización de ese recurso, no el número de agentes lanzados.
El cuarto punto es una conclusión directa del MRU. El número de agentes en el dashboard no dice nada sobre si está trabajando aquello por lo que pagas. Y como con cualquier métrica de un agente, primero nombra el denominador: «utilización del 60%» sin respuesta a la pregunta «¿sobre qué se calculó?» es solo un número, no un indicador.
Lo que este trabajo no demuestra
ENPIRE no demuestra que ocho agentes sean mejores que uno en general. El resultado se obtuvo en una sola clase de tareas —la búsqueda de un algoritmo para entrenar una política de manipulación— en un entorno con reinicio automático y verificación automática.
El resumen público no incluye la curva de rendimientos, así que no sabemos dónde empieza la saturación ni dónde el rendimiento se vuelve negativo. A los agentes de negocio este trabajo no los mide en absoluto, ni una sola vez.
Tampoco elimina los costes de coordinación: los esquiva con una arquitectura en la que los agentes no se pasan el trabajo unos a otros por una cadena, sino que llevan ramas independientes con un único número compartido. El rendimiento lo da una forma en la que los agentes no se estorban entre sí, no su cantidad. Esa misma flota de ocho, montada como una cadena de montaje secuencial, daría un panorama completamente distinto.
FAQ
¿Cuántos agentes de IA necesita una empresa?
Tantos como tu supervisión sea capaz de revisar. Si el veredicto sobre la calidad del trabajo lo da una persona, según la regla práctica son entre diez y veinte agentes por supervisor cuando hay poco en juego, unos pocos cuando el riesgo es medio y contados en finanzas, medicina o derecho; los números exactos dependen de cuántos resultados llega a leer la persona que revisa. Si el veredicto es automático, el tope sube y el límite pasa a ser la utilización del recurso escaso, no la atención de una persona.
¿Cuándo una flota de agentes realmente le gana a un solo agente?
Cuando se cumplen tres condiciones a la vez: el resultado lo verifica una máquina sin una persona, el intento se puede repetir sin consecuencias y hay muchas formas independientes de hacer el trabajo. En ENPIRE se cumplen las tres, y es justamente ahí donde un mayor número de agentes llega antes a una mejor solución.
¿Significa esto que la regla «un agente con un eval sólido» está equivocada?
No. Es correcta para las tareas donde la respuesta está en esencia definida y el eval verifica el resultado: es decir, para la mayoría de los procesos corporativos. Lo equivocado no es la regla, sino aplicarla sin esa premisa a tareas de búsqueda, donde la respuesta no se conoce de antemano.
¿Qué son MRU y MTU en ENPIRE?
Mean Robot Utilization y Mean Token Utilization: dos métricas que los autores propusieron para medir la eficiencia de la autoinvestigación física multiagente. Miden qué parte del recurso escaso está trabajando de verdad, no cuántos agentes se lanzaron.
¿Por qué el crecimiento de la flota de robots empeora la utilización?
Porque el agente pasa buena parte del tiempo pensando en lugar de actuar: lee logs, escribe código, depura, espera la respuesta del modelo. Durante ese tiempo el recurso físico está parado. Los autores lo registran directamente: al crecer el número de robots, el MRU cae. Ten en cuenta que se trata del escalado de robots, no de agentes: son ejes distintos, y el trabajo mide la caída en el primero.
¿Se pueden escalar los agentes si no tenemos verificación automática?
Técnicamente sí; en la práctica, eso traslada la carga a una persona. Ocho resultados paralelos sin veredicto de máquina significan ocho artefactos que alguien va a leer. Primero se construye la verificación, después se escala la cantidad.
¿Por dónde empezar si quieres probar la búsqueda en paralelo?
Por el área más barata donde el veredicto ya es automático. Reúne entre cincuenta y cien ejemplos con respuestas correctas, genera varias variantes de la instrucción para el agente, ejecuta cada una sobre el conjunto y quédate con la de mejor puntuación. Es la misma construcción que en ENPIRE, solo que sin robots.
Qué sigue
Lo más útil que se puede sacar de este trabajo es el orden de las preguntas: primero el veredicto automático, después la amplitud del espacio de soluciones y solo entonces el número de agentes. El número «ocho» ni siquiera hace falta en esa lista.
Las empresas suelen ir en el orden inverso y se topan con que la discusión sobre el número de agentes llegaba dos pasos antes de tiempo.
Si ahora estás decidiendo cuántos agentes lanzar, empieza por preguntarte quién pone el cero o el uno en tu proceso. Si la respuesta es «una persona», ya conoces tu tope, y no tiene que ver con los agentes.
Fuentes:
- ENPIRE: Agentic Robot Policy Self-Improvement in the Real World: preprint, arXiv:2606.19980, 18 de junio de 2026 (NVIDIA, CMU, UC Berkeley)
- Página del proyecto ENPIRE: abstract, métricas MRU/MTU, árbol de hipótesis
- Import AI 463: Jack Clark, 29 de junio de 2026, resumen del resultado sobre el escalado de agentes
- AI-Native Playbook, 3.4 Making Agents Reliable: Gerstep, formulación de la regla sobre reducir la cadena
Publicado por Andrew Maryasov, consultor de IA, fundador de Auspex y Grow2.ai; las implantaciones las llevan Auspex (CRM) y Grow2.ai (agentes de IA).

Una carta sobre IA: 2–3 emails al mes
Ensayos personales sobre cómo la IA cambia nuestra forma de pensar y trabajar: qué probé yo mismo, qué funcionó y qué no. Al final, enlaces a lo mejor de lo que he leído.
Sin spam. Puedes darte de baja con un clic.