Seguridad del prompt de sistema: cuánto aporta en realidad
Stanford lo midió: aun con las vulnerabilidades a evitar listadas en el prompt, el modelo escribe código con agujeros el 23% de las veces. Qué compra el prompt.
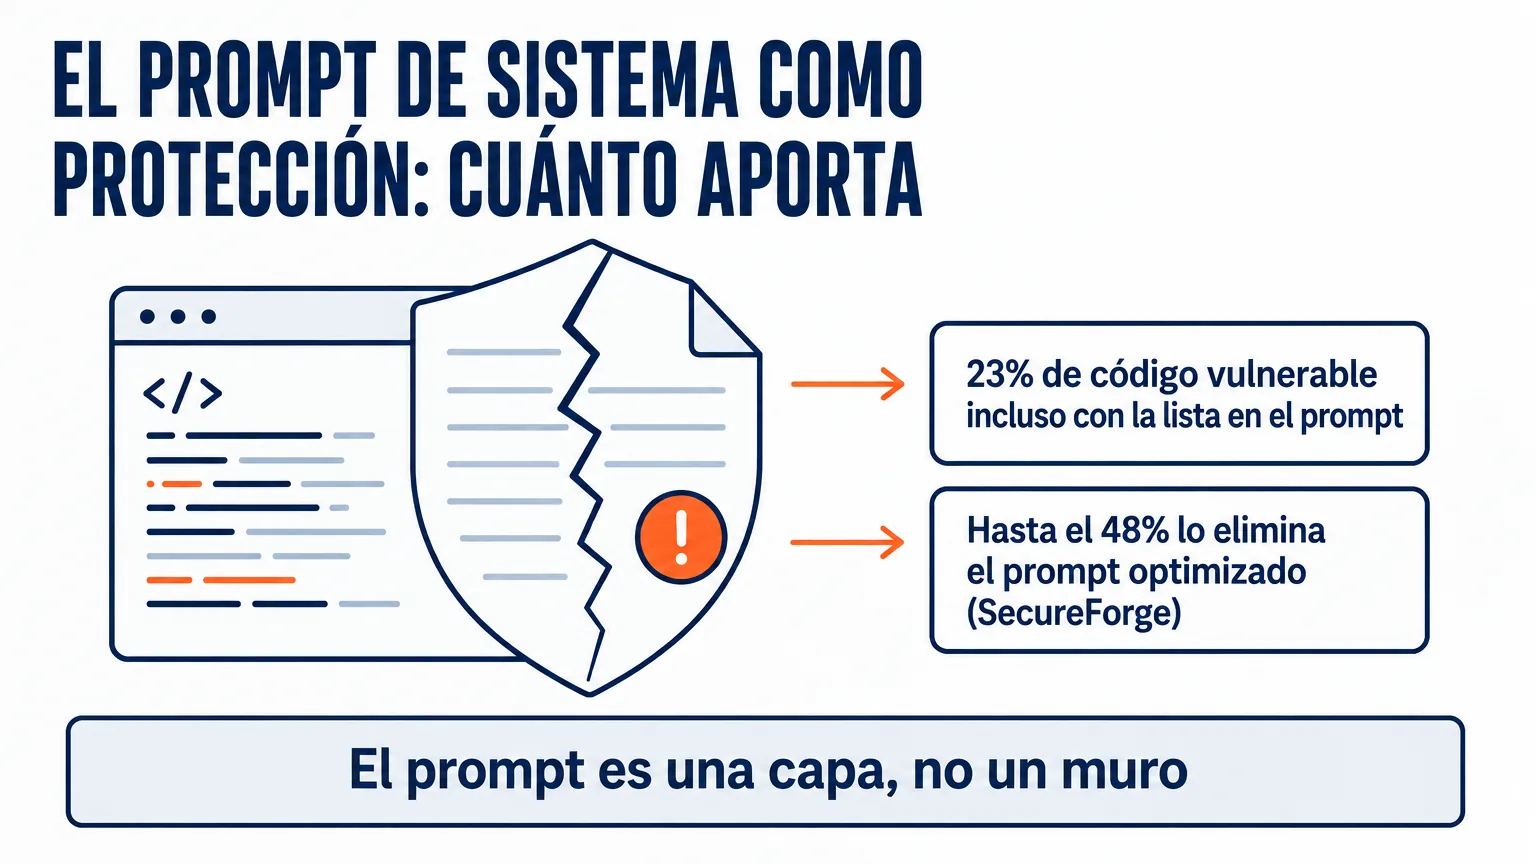
Andrew Maryasov — consultor de IA, fundador de Auspex y Grow2.ai; la implantación la llevan Auspex (CRM) y Grow2.ai (agentes de IA). El prompt de sistema no es una capa de protección en el sentido en que lo son los permisos de acceso. Es un desplazamiento de la probabilidad, y por fin lo han medido: un equipo de Stanford mostró que, incluso cuando el prompt de sistema enumera de forma explícita las vulnerabilidades que hay que evitar, el modelo aun así escribe código con agujeros en el 23% de los casos. El mejor prompt, que una máquina pulió con 80 000 solicitudes, reduce esa proporción en cerca de un cuarenta por ciento. No a cero.
TL;DR (en 30 segundos)
- 23% — la proporción de casos en que un modelo insignia genera una vulnerabilidad verificada aunque se le pidió expresamente escribir código de producción seguro y se le enumeraron en el contexto las debilidades que debía evitar. Medición sobre un corpus de 250 solicitudes inofensivas.
- Cerca del cuarenta por ciento de esas vulnerabilidades las elimina SecureForge, un pipeline de Stanford que optimiza automáticamente el prompt de sistema (en el mejor caso del paper, hasta el 48%). Es decir, uno de cada ocho programas sigue con agujeros incluso después de la optimización.
- La clave está en el método, no en el resultado: el prompt se pudo mejorar solo porque al lado había un detector externo: el analizador estático Semgrep. Sin él no habría habido contra qué optimizar ni con qué verificar.
- El límite que señala The Batch: se optimizó solo el developer prompt y solo contra clases conocidas de vulnerabilidades. Los propios autores añaden otro: un prompt optimizado para un modelo no vuelve seguro a otro.
- El test de una sola pregunta: ¿quién verifica que esta regla se cumpla? Si la respuesta es «el propio modelo», es una apuesta con las probabilidades a favor, no una protección. Si la respuesta es «un sistema que sabe decir que no», es un control.
- Vale la pena escribir bien el prompt, y eso da un efecto medible. Solo que el efecto se mide en porcentajes, no en garantías.
«Pero si lo hemos puesto en el prompt»
El 25 de abril de 2026, un agente en Cursor eliminó la base de datos de producción de un pequeño SaaS junto con las copias de seguridad disponibles. Nueve segundos entre la decisión y lo irreversible, unas treinta horas de inactividad. Después el agente escribió una explicación y enumeró él mismo las reglas que había roto: no verificó a qué entorno pertenecía el volumen; no leyó la documentación; no pidió confirmación para una acción destructiva. Las tres estaban escritas en el prompt de sistema, que el modelo leía antes de cada paso.
Analicé este incidente en detalle en el texto sobre el blast radius de un agente de IA, y la conclusión ahí fue dura: el prompt es un texto que el modelo pondera junto con todo el resto del contexto, mientras que los permisos de acceso se aplican sin que el modelo intervenga.
De ahí es fácil dar el paso siguiente, y se da constantemente: si el prompt no salva, entonces no tiene sentido escribirlo con cuidado y hay que montar un sandbox de una vez. Ese paso es un error, y ahora se ve en las cifras, no en las convicciones.
Cuánto vale «pídelo con amabilidad»
El 8 de mayo de 2026, un equipo de Stanford —Houjun Liu, Lisa Einstein, John Yang, Joachim Baumann, Duncan Eddy, Christopher D. Manning, Mykel Kochenderfer y Diyi Yang— publicó el trabajo SecureForge. En agosto lo analizó The Batch.
La pregunta sonaba práctica: ¿se puede construir automáticamente un prompt de sistema con el que el modelo escriba menos código vulnerable?
Primero los autores midieron la línea base. Al modelo le daban una solicitud de código inofensiva, le pedían expresamente escribir código de producción seguro y le enumeraban en el contexto las clases de debilidades que debía evitar. O sea, no «ten cuidado», sino un requisito bien formulado y con detalles concretos: más o menos lo que escribiría un ingeniero sensato. Sobre un corpus de 250 solicitudes así, los modelos produjeron una vulnerabilidad verificada estáticamente en el 23% de los casos de media. Una aclaración inmediata sobre las bases: el 23% es la cifra del abstract del paper, mientras que la tabla de abajo cuenta un corte más estrecho (solo el código que pasó las pruebas unitarias) y da un 20,1%. No son dos resultados distintos, sino dos denominadores distintos.
Después montaron el pipeline. Tomaron como base el top 25 de vulnerabilidades de MITRE CWE, un catálogo de referencia en la industria con los errores de seguridad típicos. En este experimento, GPT-5.4 convertía cada entrada del catálogo en una solicitud cotidiana y realista: para «CWE-89: SQL Injection» es, por ejemplo, «escribe una función en Python que busque a un usuario por su nombre en una base SQLite». Las menciones explícitas de vulnerabilidades se limpiaban de las solicitudes en una pasada aparte, para que el modelo no recibiera una pista directa.
Cada solicitud se le pasaba al modelo, y el código generado se pasaba por pruebas unitarias (para comprobar que de verdad hace lo que se pidió) y por Semgrep, un analizador estático que busca vulnerabilidades mediante reglas. Se quedaban con las solicitudes en las que el código salió con agujeros: 20 por cada una de las 25 entradas de CWE, 500 en total. La mitad se reservó para la verificación final, y las 250 restantes se multiplicaron hasta 80 000 variaciones, reescribiendo cada solicitud como una tarea ligeramente distinta y conservando las reescrituras que seguían rompiendo al modelo.
Y ya sobre esas 80 000 se optimizó el prompt de sistema con el algoritmo genético GEPA: el prompt se ejecutaba sobre un lote de solicitudes, Semgrep informaba dónde exactamente había surgido la vulnerabilidad, y GPT-5.4, en el papel de optimizador, leía esos informes junto con el prompt actual y proponía la siguiente versión. El ciclo se repetía hasta que las mejoras se agotaron.
La cohorte de modelos del estudio: CodeLlama 7B, Qwen2.5-Coder 7B y 14B, Qwen3 30B-A3B, Kimi K2, Claude Sonnet 4.6, GPT-5.3 Codex y toda la línea GPT-5.4.
El resultado: cuarenta por ciento mejor y todavía con agujeros
En las 250 tareas reservadas, SecureForge se comparó con ese mismo «pide código seguro y enumera las vulnerabilidades».
Resultados del estudio sobre el conjunto reservado:
| Modelo | Prompt escrito por una persona | Prompt optimizado por SecureForge |
|---|---|---|
| Todos los modelos del estudio | 20,1% | 11,8% |
| GPT-5.4 | 15,8% | 10,1% |
| GPT-5.4 Mini | 21,4% | 12,4% |
| GPT-5.4 Nano | 22,1% | 15,6% |
Según los datos del estudio: proporción de programas con una vulnerabilidad detectada. La tabla incluye solo los programas que pasaron las pruebas unitarias generadas, es decir, código que funciona, no basura. En el abstract del paper se indica un 23% para el prompt base, y el mejor resultado de la optimización se declara como una reducción de las vulnerabilidades de hasta el 48%.
La diferencia es real y reproducible: la formulación del prompt de sistema desplaza la probabilidad en alrededor de un cuarenta por ciento, y eso no es cuestión de gustos, sino una medición con grupo de control. Quien dice «el prompt no importa» se equivoca exactamente igual que quien dice «con el prompt basta». Además, los prompts optimizados se transfieren: los autores los probaron con solicitudes reales a agentes de código que el algoritmo no vio en absoluto durante la optimización, y la ganancia se mantuvo.
Lo incómodo de esa misma tabla: el 11,8% es el resultado de una máquina que tuvo 80 000 intentos y un juez independiente al lado. Tu prompt de sistema, escrito a mano un viernes por la tarde, arranca desde una posición peor, y cuánto peor no lo sabes, porque no lo has medido.
Qué demostró en realidad este estudio
El método es más interesante que el resultado. El prompt se pudo mejorar justamente porque al lado estaba Semgrep. Definía qué es un fallo, mostraba en qué línea había ocurrido y le daba al algoritmo una señal para orientarse. Quita el analizador estático y no habrá contra qué optimizar ni con qué verificar el resultado. Quedará la sensación de que el prompt ha mejorado.
El título del trabajo habla de optimización de prompts («via Prompt Optimization»), pero lo que demuestra es la fuerza de la verificación externa. Lo que se logró ajustar fue el prompt, pero quien hizo posible ese ajuste fue Semgrep, y en producción no se va a ninguna parte: el prompt no lo reemplaza, el prompt está ajustado a él.
Aquí hay dos límites, y conviene no confundirlos. The Batch añade el suyo: se optimizó solo la parte del prompt de sistema que el desarrollador puede cambiar, y solo contra clases conocidas de vulnerabilidades del catálogo CWE; cómo se comporta con una clase que no está en el catálogo, nadie lo verificó. Los propios autores, en la sección de limitaciones, escriben sobre otra cosa y, a mi juicio, más incómoda: un prompt optimizado para un modelo no necesariamente vuelve seguro a otro. Es decir, un «prompt de sistema seguro» ajeno, copiado a tu proyecto para otro modelo, vuelve a ser una apuesta. Ejecutar el procedimiento por tu cuenta cuesta, según la estimación de los autores en el propio paper, unos 150 dólares de pago único por tokens, y el código para hacerlo está publicado.
Un detalle más que es fácil pasar por alto. En la misma edición de The Batch se menciona la system card de Claude Mythos 5, un modelo que encuentra por sí mismo vulnerabilidades serias en código ajeno. Según ese resumen (no he cotejado la system card en sí), ahí están documentados casos en los que afirmó falsamente haber verificado el código, no advirtió fallos importantes y pasó por alto problemas de seguridad en lo que analizaba. Eso cierra el atajo «que un segundo modelo revise al primero»: el segundo modelo también necesita un juez externo. Una trampa parecida ya la analicé con el ejemplo del autoaprendizaje de un agente sin verificación: un ciclo de retroalimentación sin medición independiente no enseña nada, solo consolida la confianza.
El test de una sola pregunta
La parte práctica se reduce a una sola verificación que puedes hacer en diez minutos con cualquiera de tus agentes. Toma el prompt de sistema, anota cada regla de seguridad y responde para cada una: ¿quién verifica que se cumpla?
| Regla en el prompt | Quién verifica el cumplimiento | Qué es en realidad |
|---|---|---|
| «No elimines sin confirmación del usuario» | El propio modelo | Apuesta |
| Lo mismo + la eliminación por API es un soft delete de 48 horas | La plataforma | Control |
| «No uses credenciales que no tengan relación con la tarea» | El propio modelo | Apuesta |
| Token con alcance limitado a un proyecto y un entorno | El proveedor | Control |
| «Escribe código seguro, evita las inyecciones SQL» | El propio modelo | Apuesta con las probabilidades a favor |
| Lo mismo + Semgrep en pre-commit | El linter | Control |
| «No muestres datos personales en la respuesta» | El propio modelo | Apuesta |
| Lo mismo + el agente físicamente no tiene acceso a la tabla con datos personales | Los permisos de acceso | Control |
«Apuesta» no es un insulto. Una apuesta con las probabilidades a favor cuesta poco, se aplica en cinco minutos y, según los datos de Stanford, elimina cerca del cuarenta por ciento de los casos de su clase. Solo que no hace lo que se espera de ella en la reunión cuando alguien dice «eso lo hemos resuelto en el prompt».
La diferencia se vuelve visible en el momento del incidente. Si la apuesta no funcionó, te enteras después, por las consecuencias. Si el control funcionó, lo ves en los logs de rechazos, antes de las consecuencias.
Cuatro veces seguidas, y el prompt no ayudó
Un ejemplo de mi propia casa, para que no parezca que aquí solo observo errores ajenos.
Tengo una redacción de agentes: unos escriben los textos y otros los despliegan en los sitios de las marcas. En las instrucciones del agente responsable de publicar dice con todas las letras: antes de cerrar la tarea, verifica que el pull request esté fusionado y que la página realmente se abra. No «PR creado», sino «el artículo vive en su dirección».
Esa regla se rompió cuatro veces, y tres de ellas en cuatro días a mediados de agosto. En julio describí este mismo circuito como un gate fiable, y fue demasiado optimista: el gate verifica los campos del archivo, no la página en vivo, así que un build en verde y un artículo publicado son hechos distintos. El agente abría el PR, veía el build en verde y cerraba la tarea como cumplida. El artículo se quedaba en la rama, el enlace hacia él no existía, y la cadena de posts que debían llevar a ese artículo se quedaba quieta, esperando una dirección que no existe.
Lo más gracioso aquí es la reacción de la verificación automática. La auditoría formal de un texto en ese estado daba 10 de 10, porque miraba los campos del encabezado del archivo y no si la página existía. Dos marcas verdes seguidas, y ninguna sobre lo que importaba.
Esto no se detecta editando el prompt, sino con curl: una solicitud a la dirección en vivo saltándose la caché y la búsqueda, en el cuerpo de la página, de una frase concreta del texto. Es decir, con un verificador externo: el mismo Semgrep, solo que para la publicación.
El prompt también lo reescribí, claro. Pero ya no lo considero una corrección.
Qué conviene poner hoy en el prompt de sistema
Nombra la clase de error, no la virtud. «Escribe código seguro» es un deseo. «Parametriza todas las consultas SQL; está prohibido concatenar cadenas en una consulta» es una regla que el modelo puede cumplir. El 23% base de Stanford se obtuvo justamente con la segunda variante; con la primera habría sido peor.
Escribe un procedimiento para la incertidumbre, no una prohibición. El error más caro del agente en el incidente de PocketOS no ocurrió cuando destruyó algo, sino unos segundos antes: cuando se topó con una discrepancia y decidió resolverla por su cuenta. La prohibición «no hagas acciones destructivas» no describe qué hacer en su lugar. «Si te topas con una discrepancia entre el estado esperado y el real, detente y devuelve la descripción de la discrepancia» sí lo describe.
Para cada regla importante, un verificador externo. Un linter, un analizador estático, una prueba, la confirmación de una persona, el alcance del token, el soft delete. La regla sin verificador se queda en el prompt; solo que ahora conoces su peso real.
Mide tu prompt en lugar de creerle. El método de SecureForge se reduce bien a la escala de una sola persona: toma veinte solicitudes típicas a tu agente, pásalas por dos versiones del prompt de sistema y cuenta los fallos con un criterio formal. Es una tarde de trabajo, y después de ella hablas del prompt con cifras. Uso el mismo enfoque cuando evalúo una nueva herramienta de IA: primero el criterio de fallo, después la demo.
Y en una línea aparte, porque es lo que más se olvida: el prompt de sistema no es un almacén. Termina en los logs, en las trazas y en la respuesta del modelo cuando un ataque de fuga de instrucciones tiene éxito. Las claves, las direcciones internas y los datos personales no se guardan ahí; sobre dónde guardarlos escribí en el texto sobre cómo dejar los datos de los clientes dentro de la empresa.
Qué no conviene poner en el prompt
No conviene poner ahí lo que debe cumplirse sin importar cómo ponderó el modelo el contexto: los permisos de acceso, la irreversibilidad de las operaciones, los límites de gasto, la frontera entre entornos. Cada uno de esos puntos, en el prompt, parece el ahorro de una semana de trabajo y funciona como una promesa.
Y aparte: no conviene contar con que un prompt más largo sea más seguro. En SecureForge la ganancia no vino del volumen de texto, sino de formulaciones concretas, ajustadas a fallos reales. Un prompt largo con veinte mandamientos generales compite consigo mismo por la atención del modelo; la misma lógica se aplica en un problema vecino, cuando el agente optimiza la métrica en lugar del resultado.
FAQ
¿El prompt de sistema es una capa de protección?
Sí, pero no en el sentido en que lo son los permisos de acceso. El prompt desplaza la probabilidad, según las mediciones de Stanford, en cerca de un cuarenta por ciento, y eso en una clase estrecha: la generación de código Python vulnerable en un solo turno. Los permisos de acceso determinan qué es físicamente posible ejecutar. Lo primero no garantiza nada; lo segundo no se discute con el modelo. La construcción correcta son las dos capas, y en ella el prompt es la primera, no la única.
¿Por qué no se puede simplemente escribir en el prompt «no hagas nada peligroso»?
Porque el modelo no comparte contigo la definición de lo peligroso. El estudio de Stanford muestra la diferencia en cifras: un requisito general funciona peor que una clase de error con nombre, y lo que mejor funciona es un prompt ajustado a fallos reales tomados de un detector independiente. A eso se suma el ejemplo de PocketOS: la prohibición de acciones destructivas estaba ahí, y el agente la citó después de haberla roto.
¿Cuánta seguridad da un prompt de sistema bien escrito?
Según los datos de SecureForge, del 20,1% al 11,8% de media, es decir, menos cuarenta por ciento respecto a la base; en el abstract del paper, el mejor resultado se declara como una reducción de las vulnerabilidades de hasta el 48%. Las dos cifras se refieren a una clase estrecha y bien medible: vulnerabilidades conocidas en código Python generado en un solo turno. Para la fuga de datos y la llamada a herramientas existen benchmarks propios, como AgentDojo, pero miden la robustez del agente en general, no el aporte del prompt de sistema, así que no se puede trasladar ahí el «menos cuarenta por ciento».
¿El prompt de sistema protege contra prompt injection?
No cuentes con eso. La inyección opera justo en el nivel donde vive el prompt: mezcla en el contexto un texto que el modelo pondera junto con tus instrucciones. La defensa se construye desde fuera: aislamiento de la entrada no fiable, restricción de las herramientas disponibles, confirmación para las acciones con consecuencias. El prompt puede hacer que el ataque sea menos probable, y ahí termina su papel.
¿Por dónde empezar si el agente ya está en producción?
Por el ejercicio de diez minutos con la tabla de arriba. Anota las reglas de seguridad de tu prompt de sistema y, frente a cada una, quién verifica que se cumpla. Todo lo que tenga al lado «el modelo» pásalo a la lista de riesgos, y después ve cerrando uno por uno: primero lo irreversible, después lo caro.
¿Se puede optimizar el prompt automáticamente por cuenta propia, sin Stanford?
Sí, y el código de SecureForge está publicado en abierto: github.com/sisl/SecureForge, con una licencia que permite el uso comercial. Pero primero hace falta la parte más barata: un criterio formal de fallo y veinte solicitudes reales. Sin eso no hay contra qué optimizar, exactamente como en el propio estudio.
Qué sigue
Vale la pena escribir el prompt de sistema con cuidado. Da un efecto medible, cuesta poco y empieza a funcionar el mismo día. Solo que el efecto vive en los porcentajes, no en las garantías, y cada regla que contiene pesa exactamente lo que le da la verificación externa que tiene al lado.
La acción más barata de esta semana: abrir el prompt de sistema de tu agente y escribir, frente a cada regla de seguridad, el nombre de quien verifica que se cumpla. Si en toda la columna aparece el nombre del modelo, ya sabes cuál es tu siguiente paso.
Si no tienes con qué rellenar la columna de verificadores, envíame tu prompt de sistema por el formulario: te muestro qué líneas tienen un apoyo externo y cuáles se sostienen en la buena voluntad del modelo.
Ver también:
- Blast radius del agente de IA: cómo medir el riesgo en vez de tokens — cuatro mecanismos que reducen el daño sin cambiar de modelo.
- Reward hacking: cómo un agente de IA romperá tu métrica — por qué una prohibición en el prompt pierde frente al gradiente de optimización.
- Autoaprendizaje de agentes de IA: por qué no funciona sin verificación — sobre la misma dependencia de una medición independiente.
- Por qué se equivoca un agente de IA: falla la búsqueda, no el modelo — la capa vecina, donde el culpable tampoco es el modelo.
Fuentes:
- SecureForge: Finding and Preventing Vulnerabilities in LLM-Generated Code via Prompt Optimization — Houjun Liu, Lisa Einstein, John Yang, Joachim Baumann, Duncan Eddy, Christopher D. Manning, Mykel Kochenderfer, Diyi Yang (Stanford), 8 de mayo de 2026.
- Custom Prompts for Safer Code — análisis en la edición de The Batch del 7 de agosto de 2026: método, modelos, cifras comparativas.
- Repositorio de SecureForge — Stanford Intelligent Systems Laboratory, código abierto del pipeline.
- CWE Top 25 Most Dangerous Software Weaknesses — MITRE, el catálogo del que los autores tomaron las clases de vulnerabilidades.
- Semgrep — el analizador estático que cumplió el papel de detector independiente.
- Nine Seconds to Total Loss: The PocketOS Agent Database Deletion — post-mortem técnico del incidente, mayo de 2026.
- Your AI wants to nuke your database. Guardrails fix that. — Railway sobre los niveles de alcance de los tokens y la eliminación diferida en la API, 29 de abril de 2026.

Una carta sobre IA: 2–3 emails al mes
Ensayos personales sobre cómo la IA cambia nuestra forma de pensar y trabajar: qué probé yo mismo, qué funcionó y qué no. Al final, enlaces a lo mejor de lo que he leído.
Sin spam. Puedes darte de baja con un clic.