Marcas de agua en texto de IA: qué prueban y qué no
Marca de agua, detector de IA y provenance C2PA: tres mecanismos distintos que siempre se confunden. Ninguno prueba lo que se espera. Análisis con fuentes primarias y lo que de verdad exige el artículo 50 del AI Act.
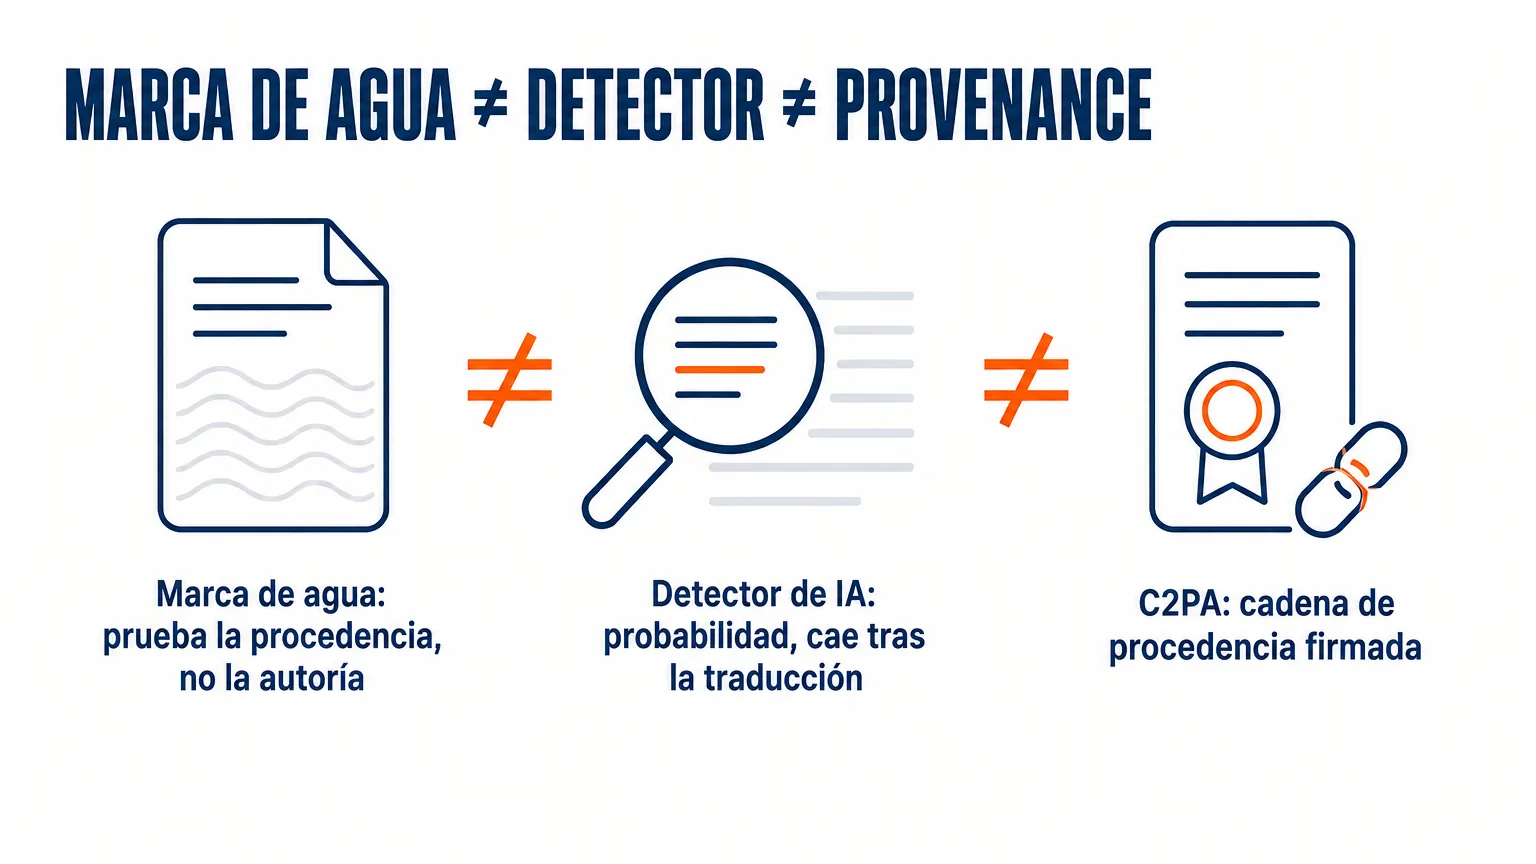
Andrew Maryasov, consultor de IA, fundador de Auspex y Grow2.ai. Este análisis es para quien tiene la expresión «detector de IA» en los KPI de la redacción o en el brief para un contratista, y para el abogado que debe firmar la página de compliance. En la conversación sobre «este texto lo escribió una IA» se mezclan tres mecanismos distintos: la marca de agua del proveedor —un rastro estadístico en la elección de tokens que le prueba a quien tiene el detector que el texto proviene de un modelo concreto—; el detector de IA —una herramienta externa que adivina, no prueba nada y se equivoca sistemáticamente con los textos de hablantes no nativos—, y la provenance C2PA —una firma criptográfica de quien publica, que prueba quién firmó el archivo, pero deliberadamente no juzga si el contenido es veraz—. La obligación que surgió en la UE el 2 de agosto de 2026 se levanta con revisión humana y un responsable con nombre y apellido, no borrando las huellas de IA.
TL;DR (en 30 segundos)
- La marca de agua prueba la procedencia, no la autoría. SynthID Text incrusta una señal en la elección de tokens; la detección es probabilística y tiene tres estados, incluido «incierto». No existe una vía pública de verificación para texto.
- La traducción reduce drásticamente la confianza del detector: así consta en la documentación de Google. Afecta directamente a los equipos que escriben en ucraniano y traducen al inglés.
- A los detectores de IA los cerraron hasta sus propios autores. OpenAI detuvo su propio clasificador, que acertaba en el 26% de los textos de IA y daba un 9% de falsos positivos en texto humano.
- Los detectores están sesgados contra los hablantes no nativos: más de la mitad de los textos de autores no nativos fue marcada como IA, mientras que con los nativos la precisión fue casi perfecta.
- C2PA se niega expresamente a juzgar la verdad. Confirma que los datos no fueron alterados y que el firmante es conocido, no que lo escrito corresponda a la realidad.
- El artículo 50(4) del AI Act tiene su propia excepción: la obligación de divulgar no se aplica si el contenido pasó por revisión humana y alguien asume la responsabilidad editorial. A la vez, el propio 50(4) se refiere a texto sobre asuntos de interés público: un blog de producto o un boletín no quedan automáticamente cubiertos por él.
La respuesta del proveedor cambió en dos semanas
El 5 de agosto de 2026, un desarrollador de la UE preguntó en el foro oficial de Google algo muy concreto: si el texto que devuelve la API de Gemini lleva marca de agua. La pregunta era práctica: necesitaba cumplir el requisito del artículo 50(2) del AI Act en su propio juego. Ese mismo día, un representante de Google respondió que no, y que no está prevista una marca de agua nativa para texto.
El 19 de agosto, el mismo representante volvió al hilo con una «corrección importante»: tras una verificación adicional con el equipo, resultó que el texto de la API de Gemini sí se marca con SynthID. Las preguntas que hicieron después otros participantes del hilo —si la marca se aplicó siempre o se introdujo en algún momento, y con qué herramienta comprobarlo— siguen sin respuesta a octubre de 2026. La documentación sigue sin decir nada al respecto.
No se puede apoyar una página de compliance en una respuesta de foro, ni en su primera versión ni en la segunda. Si el soporte oficial da dos veces en dos semanas respuestas opuestas sobre su propio producto, la marca de agua es una propiedad de la que te enteras por rumores. Sobre algo así no se construyen procesos.
Tres mecanismos que no son intercambiables
| Mecanismo | Quién lo aplica | Qué prueba técnicamente | Qué no prueba |
|---|---|---|---|
| Marca de agua (SynthID Text) | El proveedor del modelo, durante la generación | Que el texto proviene de un modelo concreto, para quien tiene el detector | Que tú puedas verificarlo |
| Detector de IA (de terceros) | Nadie; es un análisis a posteriori | Nada. Es una conjetura estadística sobre el estilo | Ni la procedencia ni la autoría |
| C2PA / Content Credentials | Quien publica, al firmar el archivo | Quién firmó y que los datos no cambiaron después de la firma | Que el contenido sea veraz |
La diferencia no es terminológica. Estas tres cosas responden a tres preguntas distintas, y una empresa normalmente quiere la respuesta a una cuarta: «¿puedo responder por esto?». A esa no responde ninguna de las tres.
La marca de agua: qué puede y qué no puede
SynthID Text no es una etiqueta añadida al texto ni un registro en los metadatos. Durante la generación desplaza las probabilidades de los tokens según una función pseudoaleatoria: el modelo elige palabras ligeramente distintas de las que habría elegido sin él, de modo que ese desplazamiento pueda detectarse estadísticamente después sin estropear el texto de forma perceptible. El método está descrito en un artículo de Nature (Dathathri, See et al., 23 de octubre de 2024), y Google publicó la implementación como código abierto.
Las limitaciones que se ven en la documentación y que casi nunca llegan a los resúmenes pesan más que el método en sí.
La marca funciona peor justamente en el texto fáctico. La documentación lo dice sin rodeos: en las respuestas fácticas hay menos margen para variar la redacción sin perjudicar la exactitud. Cuanto más se parece el texto a una ficha de datos escueta, más débil es la señal, y ese es exactamente el tipo de contenido que las empresas generan con más frecuencia.
La traducción desorienta al detector. La confianza baja mucho si el texto se reescribió a fondo o se tradujo a otro idioma; la robustez se mantiene solo frente al recorte de fragmentos, el cambio de unas pocas palabras y una paráfrasis leve. Para el ciclo típico de «borrador en ucraniano, luego versión en inglés para LinkedIn», esto significa que después de traducir ya no se puede confiar en la marca.
Quién puede verificar lo decide el proveedor. Hay tres modos: detector totalmente privado, semiprivado a través de una API y público. Para texto hoy no existe una vía pública. Es decir, aunque hayan incrustado una marca de agua en tu texto, no eres tú quien puede demostrarlo.
La marca de agua es una herramienta del proveedor para el proveedor. Funciona en una disputa en la que una de las partes es dueña del detector, y a ti, que eres quien publica, no te da ninguna forma de probar algo sobre tu propio contenido.
Detectores de IA: el único de los tres que no prueba nada
El detector suele verse como una versión ligera de la marca de agua. No tienen nada en común: la marca de agua busca una señal que alguien puso ahí a propósito; el detector mira un texto terminado y adivina por el estilo.
OpenAI cerró el suyo. El AI Text Classifier se lanzó en enero de 2023 y OpenAI lo retiró el 20 de julio del mismo año alegando su baja precisión. Las cifras las publicó la propia empresa: en un «challenge set» en inglés, el clasificador reconocía correctamente el 26% de los textos de IA y marcaba por error texto humano como IA en el 9% de los casos. Un nueve por ciento de falsos positivos equivale a uno de cada once textos escritos por una persona.
La segunda parte del problema golpea de lleno a los equipos ucranianos. Un estudio de la Universidad de Stanford, publicado en la revista Patterns en 2023, sometió textos de hablantes nativos y no nativos de inglés a siete detectores de uso extendido. Los detectores clasificaron como generadas por IA más de la mitad de las muestras escritas por no nativos, mientras que con los textos de nativos la precisión fue casi perfecta. Los autores también mostraron el mecanismo: los detectores reaccionan a un vocabulario más pobre y a una sintaxis más simple, y enriquecer el léxico reducía la proporción de falsos positivos. Ahí mismo se habla de la fiabilidad desde el otro lado: unas instrucciones simples al modelo bastaban para esquivar esos detectores.
La herramienta penaliza sistemáticamente a quienes escriben en su segunda lengua y deja pasar a quienes la esquivan a propósito.
Tanto el estudio como el cierre del clasificador datan de 2023; los proveedores de detectores de hoy declaran una precisión más alta. Pero son afirmaciones de quienes los venden: a septiembre de 2026 no he conseguido encontrar una verificación revisada por pares que refute el efecto sobre los no nativos. Mientras no exista, el veredicto de un detector sigue siendo una conjetura, y no se pueden basar en él decisiones de personal ni editoriales. Es la misma clase de error que en la métrica de evasión para la monitorización de agentes: el número existe y parece convincente, pero no responde a la pregunta que tú haces.
C2PA: prueba quién firmó, no la verdad
C2PA (Coalition for Content Provenance and Authenticity) llega desde el otro lado. En lugar de buscar rastros en el texto, añade al archivo un manifiesto firmado, el Content Credential: quién lo creó, con qué se editó, qué se hizo a partir de qué. La especificación no se limita a imágenes: entre los formatos que el manifiesto puede declarar también está text/plain.
En el documento explicativo del propio consorcio se dice sin rodeos: los Content Credentials no emiten juicios de valor sobre si un conjunto de datos de procedencia es «verdadero»; solo confirman que esa información está correctamente formada, no fue alterada y está firmada por alguien de una lista de confianza conocida.
Un informe falsificado con un manifiesto C2PA impecable sigue siendo un informe falsificado, solo que ahora se sabe con exactitud quién lo firmó. Eso no vuelve inútil el mecanismo: C2PA lleva la conversación de «¿esto lo escribió una IA?» a «¿quién responde por esto?», y la respuesta a la segunda pregunta se puede verificar.
Qué exige realmente la ley
El artículo 50 del AI Act se aplica desde el 2 de agosto de 2026.
Artículo 50(2): la obligación del proveedor. Los proveedores de sistemas que generan audio, imagen, vídeo o texto sintéticos deben garantizar que los resultados de salida estén marcados en un formato legible por máquina y puedan reconocerse como generados por IA. Luego viene la salvedad en la que vive la debilidad de la marca de agua en texto: las soluciones deben ser eficaces y fiables «en la medida en que sea técnicamente viable», teniendo en cuenta las limitaciones de los distintos tipos de contenido, el coste de aplicación y el estado de la técnica. Ahí mismo hay una excepción que suele olvidarse: la obligación no se aplica cuando la IA cumple una función de apoyo a la edición estándar o no altera sustancialmente los datos de entrada ni su semántica. La revisión ortográfica o la paráfrasis de un párrafo no requieren marcado legible por máquina.
Artículo 50(4): la obligación de quien publica. Quienes usan IA para crear o modificar texto publicado con el fin de informar al público sobre asuntos de interés público deben divulgar que el texto se generó o modificó de manera artificial. Y enseguida la excepción: la obligación no se aplica si el contenido pasó por revisión humana o control editorial y si una persona física o jurídica tiene la responsabilidad editorial de la publicación. El reglamento nombra expresamente la condición bajo la cual no hace falta etiquetar, y no es borrar el estilo de IA, ni «humanizar» el texto, ni pasar un detector.
Sobre el período transitorio: el Reglamento (UE) 2026/1744 (Digital Omnibus on AI) se publicó en el Diario Oficial el 24 de julio de 2026 y está en vigor desde el 27 de julio de 2026; añadió al AI Act el artículo 111(4): los sistemas introducidos en el mercado antes del 2 de agosto de 2026 deben adecuarse al artículo 50(2) a más tardar el 2 de diciembre de 2026. A los sistemas introducidos después del 2 de agosto esa prórroga no se les aplica, y el propio artículo 50(2) no se aplazó.
Qué hacer con esto
Deja de medir lo que no se puede medir. Pasar tu propio texto por un detector antes de publicarlo no da información. Da un número que para tu redactor no nativo será peor que para un nativo, haya escrito ahí una IA o no. Si ese indicador está en los KPI, hay que sacarlo de ahí; y por la misma razón no conviene prometerle al cliente un «texto sin huellas de IA».
Deja registrado quién lo leyó. La excepción del 50(4) suena a burocracia, pero describe el trabajo editorial corriente que la mayoría de los equipos ya hace y simplemente no ha formalizado: el nombre del editor junto al material, la fecha de la última revisión, los enlaces guardados a las fuentes de cada cifra. La diferencia entre «aquí lo mira un editor» y «tenemos responsabilidad editorial» son diez minutos para anotar quién exactamente lo miró.
Lleva un registro de fuentes, no un registro de prompts. Cuando llegue una reclamación, la pregunta será «¿de dónde salió esta cifra?». De qué modelo salió el texto no lo vas a poder probar; la fuente sí, si el enlace está guardado.
Pregúntale al proveedor por escrito en qué estado está la marca de agua. Que venga de la documentación o del account manager, con fecha. La historia de la API de Gemini muestra cuánto vale una respuesta verbal.
La lógica es la misma que en la seguridad del prompt de sistema: lo que protege es el mecanismo que puedes verificar y mostrar, no el que parece una protección. E igual que con llms.txt, alrededor de una etiqueta técnica crecieron más expectativas de las que es capaz de sostener.
La pregunta «¿esto lo escribió una IA?» va perdiendo sentido: no tiene una respuesta fiable y no la tendrá. La pregunta «¿quién verificó los hechos y quién responde si son falsos?» siempre tiene respuesta.
FAQ
¿Se puede comprobar si un texto tiene la marca de agua SynthID?
No hay una herramienta pública para texto. Google describe tres modelos de acceso al detector —totalmente privado, semiprivado a través de una API y público—, y la elección la hace el proveedor. Las vías de verificación de SynthID publicadas aceptan imágenes, vídeo y audio.
¿Está obligada una empresa a etiquetar el contenido de IA en la UE?
El artículo 50 del AI Act rige desde el 2 de agosto de 2026. Los proveedores de sistemas generativos deben hacer que la salida lleve un marcado legible por máquina (50(2)). Quienes publican texto de IA sobre asuntos de interés público deben divulgarlo (50(4)), pero no cuando el contenido pasó por revisión humana o control editorial y hay una persona con responsabilidad editorial sobre la publicación.
¿Basta con la leyenda «creado con ayuda de IA»?
Para el caso del artículo 50(4), el reglamento da una alternativa: la revisión humana más un responsable de la publicación con nombre y apellido levantan la obligación de divulgar. Para los proveedores de sistemas del 50(2), una leyenda visible no reemplaza el marcado legible por máquina: son requisitos distintos para actores distintos.
¿Qué hacer si un cliente exige la garantía de que el texto pasará un detector de IA?
Esa garantía no se puede dar sin engañar: el resultado de un detector es inestable y depende del idioma del autor más que de la forma en que se creó el texto. En su lugar conviene ofrecer lo que sí se puede verificar: fuentes cotejadas, autoría declarada y responsabilidad editorial sobre los hechos.
Publicado por Andrew Maryasov, consultor de IA, fundador de Auspex y Grow2.ai; las implantaciones las llevan Auspex (CRM) y Grow2.ai (agentes de IA).
Fuentes:
- Google AI for Developers: SynthID: Tools for watermarking and detecting LLM-generated Text (documentación, actualizada el 9 de abril de 2025)
- Dathathri S., See A., Ghaisas S. et al. «Scalable watermarking for identifying large language model outputs», Nature, 23 de octubre de 2024
- Hilo sobre la marca de agua en el texto de la API de Gemini, foro oficial de Google AI Developers, 5–19 de agosto de 2026
- OpenAI: New AI classifier for indicating AI-written text (enero de 2023, con una nota sobre el cierre en julio de 2023)
- Liang W., Yuksekgonul M., Mao Y., Wu E., Zou J. «GPT detectors are biased against non-native English writers», Patterns 4(7):100779, Stanford University, 2023
- C2PA: Content Credentials Explainer 2.3, §2 (de donde sale la cita sobre la ausencia de juicios de valor) y la especificación técnica 2.3 (donde
text/plainfigura entre los formatos del manifiesto) - Reglamento (UE) 2024/1689 (AI Act), artículo 50; directrices de la Comisión Europea sobre las obligaciones de transparencia
- Reglamento (UE) 2026/1744, publicado en el DO el 24 de julio de 2026, en vigor desde el 27 de julio de 2026 (Digital Omnibus on AI): artículo 111(4) del AI Act y período transitorio hasta el 2 de diciembre de 2026 para los sistemas introducidos en el mercado antes del 2 de agosto de 2026

Una carta sobre IA: 2–3 emails al mes
Ensayos personales sobre cómo la IA cambia nuestra forma de pensar y trabajar: qué probé yo mismo, qué funcionó y qué no. Al final, enlaces a lo mejor de lo que he leído.
Sin spam. Puedes darte de baja con un clic.