Водяні знаки в AI-тексті: що вони доводять, а що ні
Водяний знак, AI-детектор і C2PA-provenance — три різні механізми, які постійно плутають. Жоден не доводить того, що від нього очікують. Розбір із первинних джерел і того, чого насправді вимагає стаття 50 AI Act.
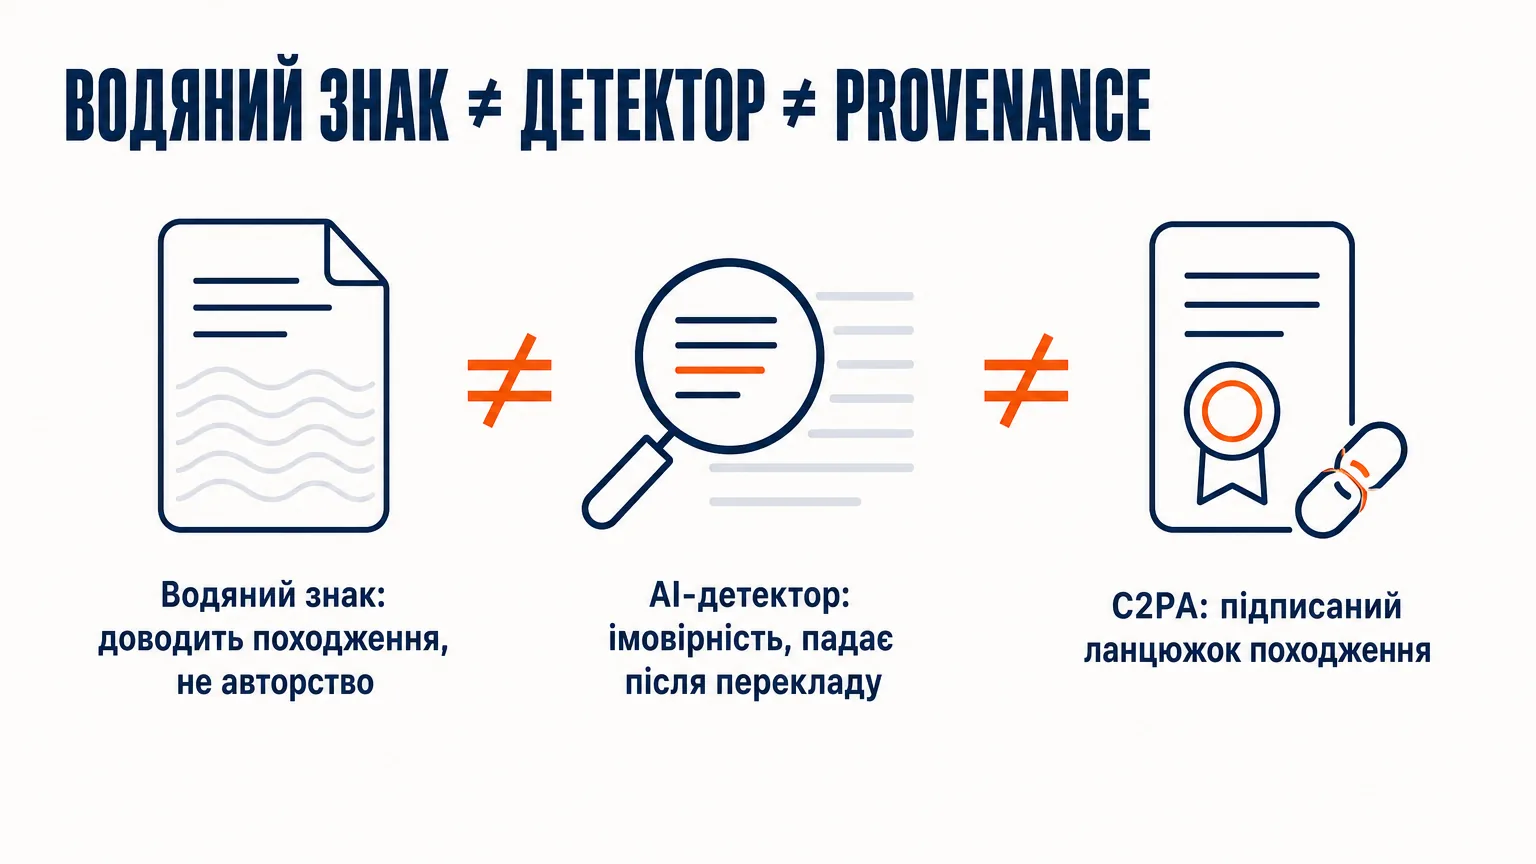
Andrew Maryasov, AI-консультант, засновник Auspex і Grow2.ai. У розмові про «AI написав цей текст» злипаються три різні механізми: водяний знак провайдера — статистичний слід у виборі токенів, який доводить походження з конкретної моделі тому, хто має детектор; AI-детектор — стороння вгадувалка, яка не доводить нічого і систематично помиляється на текстах неносіїв мови; C2PA-provenance — криптопідпис видавця, який доводить, хто підписав файл, але навмисно не судить про правдивість вмісту. Обов’язок, що з’явився в ЄС 2 серпня 2026 року, знімається не вичищенням AI-слідів, а наявністю людини з редакційною відповідальністю.
TL;DR (за 30 секунд)
- Водяний знак доводить походження, а не авторство. SynthID Text вбудовує сигнал у вибір токенів. Детекція ймовірнісна і має три результати, включно з «невизначено».
- Перевірити його ззовні найчастіше неможливо. Провайдер сам вирішує, чи відкривати детектор. Для тексту публічного маршруту перевірки немає.
- Google за два тижні дав дві протилежні відповіді про те, чи вотермаркиться текст із Gemini API. Документація досі мовчить.
- Переклад різко знижує впевненість детектора — це записано в документації Google. Для української команди, яка пише українською й перекладає англійською, це не деталь.
- AI-детектори закривали навіть їхні автори. OpenAI зупинив власний класифікатор із 26% правильних розпізнавань AI-тексту і 9% хибних спрацювань на людському.
- Детектори упереджені до неносіїв мови: понад половину текстів non-native авторів помічено як AI, тоді як на носіях точність була близька до ідеальної.
- C2PA прямо відмовляється судити про правду. Він підтверджує, що дані не підроблені й підписант відомий — не те, що написане відповідає дійсності.
- Стаття 50(4) AI Act має власний виняток: обов’язок маркувати не діє, якщо контент пройшов людський перегляд і хтось несе редакційну відповідальність за публікацію.
Два тижні, дві протилежні відповіді
5 серпня 2026 року розробник із ЄС поставив на офіційному форумі Google максимально конкретне питання. Він робить гру, сцени в якій генеруються через Gemini API, і йому треба закрити вимогу статті 50(2) AI Act — маркувати AI-контент у машиночитаному вигляді. Або, як дозволяють настанови Єврокомісії, спертися на маркування самого постачальника моделі.
Питання було просте: текст, який повертає API, — він вотермаркнутий чи ні?
Розробник зробив домашню роботу. Огляд SynthID згадує текстовий водяний знак тільки для застосунку та вебверсії Gemini. Документація для розробників описує SynthID Text як інструмент, який ви застосовуєте до власної моделі, а не як властивість API. Модельна картка Gemini 2.5 Flash-Lite про вотермарк не згадує взагалі. Опубліковані маршрути перевірки приймають зображення, відео й аудіо — текст ні. Він навіть перевірив живу відповідь generateContent: ні в заголовках, ні в тілі JSON немає жодних метаданих про походження.
Того ж дня представник Google — учасник форуму з фірмовою позначкою «Google» — відповів: текст з API не має водяного знака, машиночитаного сигналу походження немає, це працює лише для інших модальностей, і нативний вотермаркінг тексту наразі не планується.
За десять днів інший розробник уточнив, чи стосується це Google AI Studio та Antigravity. 19 серпня той самий представник повернувся в тред із «важливим виправленням»: після додаткової перевірки з командою виявилося, що текст, згенерований через Gemini API, усе-таки позначається SynthID. І це стосується також AI Studio та Antigravity.
Наступне питання в треді залишилося без відповіді. Його поставив той самий розробник: вотермарк застосовувався завжди чи його ввели в якийсь момент? І як це перевірити, якщо документація DeepMind про це не пише, а способу подивитися на сам текст у нас немає?
Тут варто бути точним. Відповідь на форумі — це не документація, і ставити на неї сторінку комплаєнсу не можна ні в першій, ні в другій редакції. Але сам епізод показовий: якщо офіційна підтримка провайдера двічі за два тижні дає протилежні відповіді про власний продукт, а документація мовчить, то «водяний знак» — це не та властивість, на якій будують процес. Це властивість, про яку ви дізнаєтесь із чуток.
Три механізми, які не взаємозамінні
| Механізм | Хто ставить | Що технічно доводить | Чого не доводить |
|---|---|---|---|
| Водяний знак (SynthID Text) | Провайдер моделі під час генерації | Що текст походить із конкретної моделі — для того, хто має детектор | Що ви зможете це перевірити |
| AI-детектор (сторонній) | Ніхто, це аналіз пост-фактум | Нічого. Це статистична здогадка про стиль | Ані походження, ані авторства |
| C2PA / Content Credentials | Видавець, підписуючи файл | Хто підписав і що дані не змінені після підпису | Що вміст правдивий |
Різниця не термінологічна. Ці три речі відповідають на три різні питання, і бізнес зазвичай хоче відповідь на четверте: «чи можу я за це відповідати». На нього не відповідає жоден із трьох.
Водяний знак: що це технічно
SynthID Text — це не мітка, дописана до тексту, і не запис у метаданих. Це logits processor: він втручається в генерацію після відсікання Top-K і Top-P і зміщує ймовірності токенів за псевдовипадковою функцією. Модель обирає трохи інші слова, ніж обрала б без нього, — так, щоб цей зсув можна було потім статистично виявити, помітно не зіпсувавши текст. Метод описаний у статті «Scalable watermarking for identifying large language model outputs» (Dathathri, See та ін., Nature, 23 жовтня 2024), а реалізацію Google відкрив: вона є в Hugging Face Transformers і окремим репозиторієм на GitHub.
Тепер обмеження, яких у переказах зазвичай немає.
Детекція ймовірнісна, і в неї три стани. Байєсів детектор повертає «є водяний знак», «немає» або «невизначено». Пороги налаштовує той, хто його запускає, — під потрібний рівень хибних спрацювань. Відповідь «невизначено» — штатний результат, а не збій.
Водяний знак гірше лягає саме на фактичний текст. Документація формулює це прямо: застосування менш ефективне на фактичних відповідях, бо там менше простору змінити формулювання, не зіпсувавши точність. Чим ближче текст до сухої довідки, тим слабший сигнал. Це рівно той тип контенту, який бізнес найчастіше й генерує.
Переклад і глибоке переписування збивають детектор. Знову цитата з документації: впевненість детектора може сильно знизитись, якщо AI-текст ретельно переписали або переклали іншою мовою. Стійкість зберігається до дрібнішого — обрізання шматків, заміни кількох слів, легкого перефразування.
Для української команди останній пункт вирішальний. Типовий робочий цикл — чернетка українською, потім англомовна версія на LinkedIn. Після перекладу покладатися на водяний знак уже не можна. Не тому, що хтось його «обходив», а тому, що так працює метод.
Хто може перевірити — вирішує провайдер. Документація описує три режими: повністю приватний детектор, напівприватний через API і публічний. Вибір за провайдером. Для тексту публічного маршруту перевірки сьогодні немає — а отже, навіть якщо вотермарк у ваш текст вбудували, ви не той, хто може це показати.
Водяний знак — інструмент провайдера для провайдера. Він може довести походження в спорі, де однією зі сторін є власник детектора, і не дає вам як видавцю жодного способу щось довести про власний контент.
AI-детектори: єдиний із трьох, який не доводить нічого
Це найпоширеніша плутанина: детектор сприймають як полегшену версію водяного знака. Спільного між ними немає нічого. Водяний знак шукає сигнал, який туди навмисне поклали. Детектор дивиться на готовий текст і вгадує за стилістикою.
OpenAI закрив власний детектор. AI Text Classifier запустили в січні 2023-го й зупинили 20 липня того ж року з формулюванням про низьку точність. Числа компанія опублікувала сама: на англомовному «challenge set» класифікатор правильно розпізнавав 26% AI-текстів і при цьому помилково позначав людський текст як AI у 9% випадків.
Дев’ять відсотків хибних спрацювань — це кожен одинадцятий текст, написаний людиною.
Друга частина проблеми серйозніша, і вона б’є точно по українських командах. Дослідження Стенфордського університету, опубліковане в журналі Patterns у 2023 році, прогнало через сім поширених детекторів тексти носіїв і неносіїв англійської. Результат: понад половину зразків, написаних неносіями, детектори віднесли до AI-згенерованих, тоді як на текстах носіїв точність була близька до ідеальної. Автори показали й механізм — детектори реагують на бідніший словниковий запас і простіший синтаксис. Коли лексику в текстах неносіїв штучно збагачували, частка хибних спрацювань падала; коли тексти носіїв спрощували — зростала.
Там же — і про надійність з іншого боку: прості інструкції моделі дозволяли обійти ці детектори.
Інструмент систематично штрафує тих, хто пише другою мовою, і пропускає тих, хто свідомо його обходить. Страждає сумлінний автор-неносій, а не той, хто грає проти системи.
Чесне застереження: дослідження й закриття класифікатора датуються 2023 роком і стосуються детекторів того покоління. Сьогоднішні вендори заявляють вищу точність. Але це заяви самих продавців: публічно доступної рецензованої перевірки, яка спростувала б цей ефект на неносіях, станом на серпень 2026 року знайти не вдалося. Поки її немає, вердикт детектора лишається здогадкою, і будувати на ньому кадрові чи редакційні рішення не можна.
Це той самий клас помилки, який я розбирав у тексті про метрику ухиляння в моніторингу агентів: число існує, виглядає переконливо, але відповідає не на те питання, яке ви ставите.
C2PA: доводить підписанта, а не правду
C2PA (Coalition for Content Provenance and Authenticity) заходить з іншого боку. Замість шукати сліди в тексті він додає до файлу підписаний маніфест — Content Credential: хто створив, чим редагували, що з чого зроблено. Це та сама технологія, що стоїть за позначками походження в фотоінструментах Adobe.
Специфікація не обмежена картинками: серед форматів, які маніфест може декларувати, є й text/plain.
У власному пояснювальному документі консорціуму сказано прямо. Content Credentials не дають оціночних суджень про те, чи є набір даних про походження «правдивим», — вони лише підтверджують, що ця інформація коректно сформована, не підроблена, валідна й довірена в тому сенсі, що підписант є у відомому списку довіри.
Підпис каже: «цей файл підписала ось ця організація, і після підпису його не змінювали». Він не каже, що цифри в тексті правильні, джерела реальні, а висновок обґрунтований. Підроблений звіт із бездоганним C2PA-маніфестом лишається підробленим звітом — просто тепер точно відомо, хто його підписав.
Що не робить його марним. C2PA переводить розмову з «чи це писав AI» на «хто за це відповідає» — а на друге питання відповідь можна перевірити.
Чого насправді вимагає закон
Тут абстрактна розмова стає календарною. Стаття 50 AI Act застосовується з 2 серпня 2026 року — тобто вже майже три тижні як діє.
Стаття 50(2) — обов’язок постачальника. Постачальники систем, що генерують синтетичний звук, зображення, відео або текст, мають забезпечити, щоб вихідні дані були позначені в машиночитаному форматі й розпізнавалися як згенеровані AI. Далі — застереження, яке пояснює половину сказаного вище: рішення мають бути ефективними, сумісними, надійними «наскільки це технічно можливо», з урахуванням специфіки й обмежень різних типів контенту, вартості впровадження та загальновизнаного стану технології.
Саме в цьому застереженні живе слабкість текстового вотермаркінгу. Для зображення мітка вбудовується надійно. Для тексту — з усіма обмеженнями, які Google перелічив у власній документації.
Там же, у 50(2), є ще один виняток, про який зазвичай забувають: обов’язок не діє в тій частині, де AI виконує допоміжну функцію для стандартного редагування або не змінює істотно вхідні дані чи їхній зміст. Тобто перевірка орфографії й перефразування абзацу — це не те, що треба машиночитано маркувати.
Стаття 50(4) — обов’язок того, хто публікує. Ті, хто застосовує AI-систему для створення чи зміни тексту, опублікованого з метою інформування суспільства з питань суспільного інтересу, мають розкрити, що текст згенеровано або змінено штучно. І одразу виняток: обов’язок не діє, якщо AI-контент пройшов процес людського перегляду або редакційного контролю і якщо фізична чи юридична особа несе редакційну відповідальність за публікацію.
Регламент прямо називає умову, за якої маркувати не треба. Це не вичищення AI-стилістики, не «гуманізація» тексту й не проходження детектора. Це людський перегляд плюс названий відповідальний.
Два уточнення, щоб не перебільшити. По-перше, 50(4) стосується тексту з питань суспільного інтересу — продуктовий блог чи розсилка автоматично під це не підпадають, межу визначатимуть настанови й практика. По-друге, у постачальників є перехідний період, і це вже чинна норма, а не проєкт: Регламент (ЄС) 2026/1744 від 8 липня 2026 року (Digital Omnibus on AI) додав до AI Act статтю 111(4) — системи, випущені на ринок до 2 серпня 2026 року, мають привести себе у відповідність до статті 50(2) до 2 грудня 2026 року. На системи, випущені після 2 серпня, ця відстрочка не поширюється, а сама стаття 50(2) не відкладалась.
Що з цього робити
Практичний висновок неприємний для тих, хто шукав технічну кнопку, і зручний для тих, хто вже працює нормально.
Перестаньте вимірювати те, що не вимірюється. Прогін власного тексту через детектор перед публікацією не дає інформації. Він дає число, яке для тексту вашого англомовного копірайтера-неносія буде гіршим, ніж для тексту носія, — незалежно від того, писав там AI чи ні. Якщо цей показник у вас десь у KPI, його треба звідти прибрати. І з тієї ж причини не варто обіцяти клієнту «текст без AI-слідів»: це обіцянка не пройти тест, який нічого не вимірює, і ви не можете її ні перевірити, ні гарантувати.
Зафіксуйте, хто читав. Виняток у 50(4) звучить як бюрократія, але описує звичайну редакційну роботу: людина перевірила факти, людина відповідає за публікацію.
Більшість команд цю умову вже виконують — просто не оформили. Ім’я редактора біля матеріалу, дата останньої перевірки, збережені посилання на джерела під кожною цифрою, коротка нотатка «звіряв такий-то, такого числа». Нічого з цього не купується як софт і не потребує окремого бюджету. Різниця між «у нас редактор дивиться» і «у нас є редакційна відповідальність» — це десять хвилин на те, щоб записати, хто саме дивився.
Що логічно веде до наступного: ведіть журнал джерел, а не журнал промптів. Коли претензія прилетить, питання буде не «якою моделлю це згенеровано», а «звідки взято цю цифру». Перше ви не доведете, друге — доведете, якщо посилання збережене.
І окремо для тих, у кого генерація вбудована в продукт: статус вотермаркінгу перевіряйте у постачальника письмово. Не з форуму, а з документації або від акаунт-менеджера, з датою. Історія з Gemini API показує, чого варта усна відповідь.
Загальна логіка та сама, що й у безпеці системного промпта: захищає не механізм, який виглядає як захист, а той, який ви можете перевірити й показати. І так само, як у випадку з llms.txt, навколо технічної мітки виросло більше очікувань, ніж вона здатна витримати.
Питання «чи писав це AI» поступово втрачає сенс, бо на нього немає надійної відповіді й не буде. Питання «хто перевірив факти й хто відповідає, якщо вони хибні» відповідь має завжди. Регулятор, що характерно, питає саме друге.
Якщо у вашій компанії хтось прописав «текст має проходити AI-детектор» у брифі підряднику або в KPI редакції — перешліть йому цей розбір, особливо частину про 9% хибних спрацювань. А тому, хто підписує публікації, — секцію про статтю 50(4): саме йому доведеться бути тією особою з редакційною відповідальністю.
FAQ
Чи можна перевірити, чи є в тексті водяний знак SynthID? Публічного інструменту для тексту немає. Google описує три моделі доступу до детектора — повністю приватну, напівприватну через API і публічну, — і вибір робить провайдер. Опубліковані маршрути перевірки SynthID приймають зображення, відео й аудіо.
Чи зникає водяний знак після редагування? Частково. Документація Google вказує, що знак стійкий до обрізання фрагментів, заміни кількох слів і легкого перефразування, але впевненість детектора сильно знижується при ретельному переписуванні або перекладі іншою мовою.
Чи можна довіряти AI-детекторам? Як доказу — ні. OpenAI закрив власний класифікатор через низьку точність: на англомовному тестовому наборі 26% правильних розпізнавань AI-тексту при 9% хибних спрацювань на людському. Стенфордське дослідження 2023 року показало, що детектори помилково відносять до AI понад половину текстів, написаних неносіями англійської.
Чим C2PA відрізняється від водяного знака? Водяний знак вбудовує провайдер у момент генерації, і він говорить про походження з моделі. C2PA — підписаний видавцем маніфест про історію файлу, він говорить про те, хто підписав і що дані не змінені після підпису. Консорціум прямо зазначає, що Content Credentials не оцінюють правдивість вмісту.
Чи зобов’язаний бізнес маркувати AI-контент в ЄС? Стаття 50 AI Act діє з 2 серпня 2026 року. Постачальники генеративних систем мають робити вихід машиночитано позначеним (50(2)). Ті, хто публікує AI-текст із питань суспільного інтересу, мають це розкривати (50(4)) — але не тоді, коли контент пройшов людський перегляд чи редакційний контроль і є особа з редакційною відповідальністю за публікацію.
Чи достатньо приписки «створено за допомогою AI»? Для випадку зі статті 50(4) регламент дає альтернативу: людський перегляд плюс названий відповідальний за публікацію знімають обов’язок розкриття. Для постачальників систем із 50(2) видима приписка не замінює машиночитану позначку — це різні вимоги до різних учасників.
Що робити, якщо клієнт вимагає гарантію, що текст не пройде AI-детектор? Таку гарантію не можна дати чесно: результат детектора нестабільний і залежить від мови автора більше, ніж від способу створення тексту. Замість неї варто пропонувати те, що перевіряється, — звірені джерела, назване авторство й редакційну відповідальність за факти.
Опубліковано Andrew Maryasov, AI-консультантом, засновником Auspex і Grow2.ai.
Джерела:
- Google AI for Developers — SynthID: Tools for watermarking and detecting LLM-generated Text (документація, оновлена 09.04.2025)
- Dathathri S., See A., Ghaisas S. та ін. «Scalable watermarking for identifying large language model outputs», Nature, 23.10.2024
- Тред про вотермаркінг тексту в Gemini API, офіційний форум Google AI Developers, 5–19.08.2026
- OpenAI — New AI classifier for indicating AI-written text (січень 2023, з приміткою про закриття в липні 2023)
- Liang W., Yuksekgonul M., Mao Y., Wu E., Zou J. «GPT detectors are biased against non-native English writers», Patterns 4(7):100779, Stanford University, 2023
- C2PA — Content Credentials Explainer 2.3, §2 (звідки цитата про відсутність оціночних суджень) і технічна специфікація 2.3 (де
text/plainсеред форматів маніфеста) - Регламент (ЄС) 2024/1689 (AI Act), стаття 50; настанови Європейської Комісії щодо зобов’язань прозорості
- Регламент (ЄС) 2026/1744 від 08.07.2026 (Digital Omnibus on AI) — стаття 111(4) AI Act і перехідний період до 02.12.2026 для систем, випущених на ринок до 02.08.2026
Лист про AI — 2–3 листи на місяць
Особисті есе про те, як AI змінює мислення й роботу: що я спробував сам, що спрацювало, а що ні. Наприкінці — посилання на найкраще за останній час.
Без спаму. Відписатися можна в один клік.