llms.txt: por qué el archivo casi no influye en las citas de IA
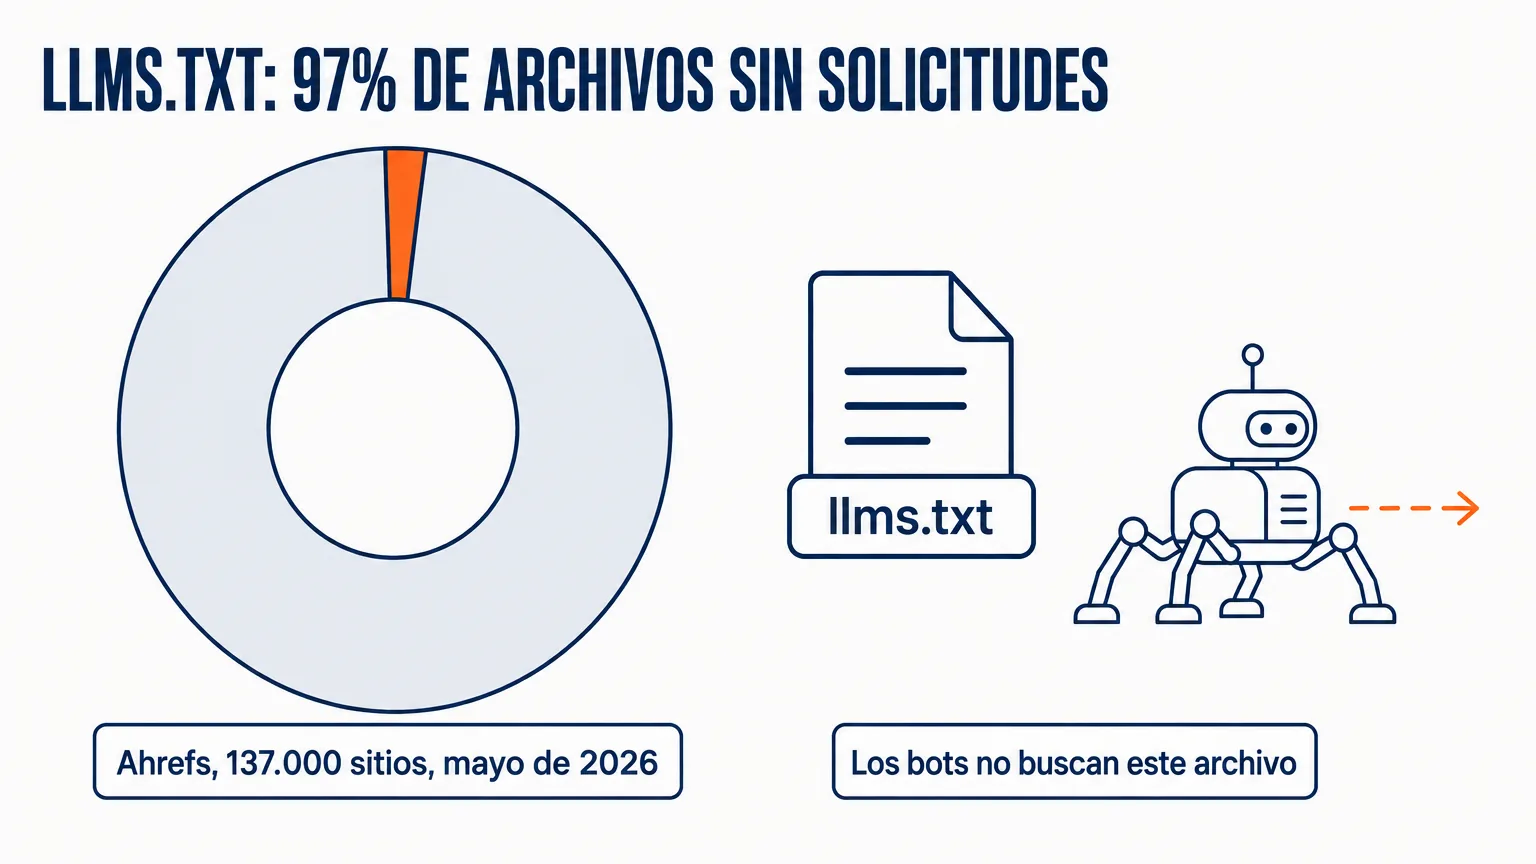
Ahrefs revisó 137 mil sitios: el 97% de los archivos llms.txt no recibió ni una solicitud. Google dice que no hacen falta. Datos, mecanismo y experiencia propia.
Andrew Maryasov, consultor de IA. En junio de 2026 puse
llms.txten cuatro de mis sitios: me llevó media hora. Ahrefs había revisado los logs de servidor de mayo de 2026 en 137 mil dominios: el 97% de esos archivos no recibió ni una sola solicitud. Google, en su propia guía, los llamó innecesarios para aparecer en las respuestas de IA.llms.txtno hace que un sitio sea más visible para la IA, porque los bots no lo buscan. La visibilidad la dan el acceso del crawler, la indexación y la profundidad del contenido.
TL;DR (en 30 segundos)
- Nadie solicitó el 97% de los archivos
llms.txtdurante mayo de 2026: Ahrefs, muestra de 137 000 dominios con logs de servidor. - A los
llms.txtinexistentes no llegó ninguna solicitud en absoluto. Los bots no buscan este archivo; no existe un mecanismo de búsqueda. - SE Ranking, sobre ~300 000 dominios, no encontró relación entre tener el archivo y la frecuencia de citas. Cuando quitaron la variable del modelo, su precisión aumentó.
- Google tomó las dos posturas en una misma semana: Search Central escribe en la sección «mythbusting» que los archivos legibles por máquina no hacen falta, y Lighthouse añade la auditoría de
llms.txta la categoría «Agentic Browsing» y activa esa categoría por defecto. - Entre los lectores de IA del archivo, los bots de búsqueda van muy por detrás. Encabezan la lista GPTBot, un crawler de entrenamiento, y Claude Code, un agente de desarrollador; otro 12% de las solicitudes viene de herramientas de GEO que revisan justamente ese archivo.
- Vale la pena ponerlo en media hora, como comodidad para los agentes que ya llegaron. No vale la pena contar con él.
Treinta minutos que no cambiaron nada
El 13 de junio me puse a repartir llms.txt por cuatro dominios: auspex.company, grow2.ai, amaryasov.expert y aelo.cloud. El archivo es simple: un mapa del sitio en markdown para los modelos de lenguaje. De paso añadí un encabezado Link según RFC 8288 con rel="describedby", para que el bot recibiera un puntero al archivo en cada respuesta HTTP en lugar de adivinar la ruta. Ingeniería ordenada, treinta minutos de trabajo.
Antes del deploy decidí comprobar lo obvio: si los crawlers siquiera llegan a mis sitios. Un solo comando:
curl -sI -A "OAI-SearchBot/1.0" https://amaryasov.expert/HTTP/2 403. «Your request was blocked.»
Lo mismo con GPTBot, ClaudeBot y PerplexityBot. Un user-agent normal de navegador recibía un tranquilo 200. Y eso que robots.txt dejaba pasar a todos: lo escribí yo mismo, y lo escribí con hospitalidad. El bloqueo estaba un nivel más abajo, en Cloudflare: en ese dominio en particular estaba activado «Block AI bots». En auspex.company y grow2.ai no lo estaba, así que pasé medio año convencido de que todo estaba en orden.
Es decir, mi sitio personal —el centro de toda la estrategia de entidad, el lugar donde vive el esquema Person— era completamente invisible para ChatGPT, Perplexity, Claude y Gemini. Y yo, en ese momento, dejaba ahí con cuidado una nota para la IA.
Lo corregí ese mismo día, en cinco minutos en el panel. llms.txt salió a producción a la mañana siguiente. Y después pasé un mes leyendo estudios que explicaron que, de esas dos acciones, solo la primera importaba.
Qué muestran los datos
En los últimos seis meses han salido cuatro mediciones independientes. Miran cosas distintas —la correlación con las citas y las solicitudes reales en los logs—, pero coinciden en una.
| Estudio | Muestra | Hallazgo |
|---|---|---|
| Ahrefs, junio de 2026 | 137 000 dominios, logs de servidor | 97% de los archivos: cero solicitudes en mayo |
| SE Ranking, finales de 2025 | ~300 000 dominios | Sin relación significativa con las citas |
| Limy.AI, log de 90 días | 500+ millones de visitas de bots de IA | 408 solicitudes a llms.txt |
| Otterly.AI, log de servidor de 90 días | 62 100+ visitas de bots de IA | 84 solicitudes al archivo (0,1%) |
Los detalles del estudio de Ahrefs merecen atención aparte, porque son logs de solicitudes, no una encuesta ni un modelo de correlación.
El archivo lo publica el 28% de los dominios de la muestra. La cifra es más alta que la media de la web: la muestra tiene un sesgo técnico, son usuarios de Ahrefs Web Analytics, es decir, gente que ya hace SEO de forma profesional. La muestra más amplia de SE Ranking da algo más cercano al 10%.
Del 3% de archivos que alguien llegó a solicitar, el 19,5% de las solicitudes vino de herramientas de IA identificadas por nombre. El primero de la lista es GPTBot y el segundo, Claude Code, y ambos superan a cualquier bot de búsqueda con IA o asistente. Otro 12% de las solicitudes lo generaron plataformas de GEO y AEO, verificadores de llms.txt e investigadores. La industria, en buena medida, se estudia a sí misma. La auditoría de Chrome Lighthouse aportó aproximadamente una solicitud de cada mil.
SE Ranking lo abordó desde otro lado y puso a prueba la relación estadística entre tener el archivo y la frecuencia de citas en las respuestas de IA. No apareció relación ni en la regresión ni en el clasificador XGBoost. Más aún: cuando quitaron llms.txt de la lista de variables, la precisión de la predicción mejoró: la variable aportaba ruido, no señal.
Simplemente no hay mecanismo
A los llms.txt inexistentes no llegó ni una solicitud. Los bots no vienen a revisar /llms.txt al azar, como sí hacen con /robots.txt o /sitemap.xml.
Ahí está la diferencia que las newsletters de marketing se esmeran en desdibujar. robots.txt funciona porque se solicita por convención, antes de la primera página. sitemap.xml funciona porque robots.txt apunta a él y los motores de búsqueda acordaron leerlo. Detrás de llms.txt no hay ni una convención de solicitud ni un acuerdo entre proveedores. Ninguno de los grandes —OpenAI, Anthropic, Google, Meta, Mistral— se comprometió a usarlo como señal de cita.
Un archivo que nadie solicita no puede influir en la respuesta. No es un «efecto débil» que vaya a aparecer en una muestra más grande. Es un canal que no existe.
Mi encabezado Link con rel="describedby" en teoría cierra justo ese hueco: le dice al bot dónde está el archivo, sin adivinar. El encabezado está en los cuatro dominios, se envía en cada respuesta, y eso no hizo que el archivo le resultara más necesario a nadie. En mis sitios mantengo llms.txt como una comodidad para los agentes, no como táctica de visibilidad. La respuesta correcta a una pregunta que nadie hizo sigue siendo correcta e innecesaria.
Google tomó las dos posturas en una semana
En mayo de 2026 Google publicó una guía de optimización para las funciones de IA generativa. En la sección llamada literalmente «mythbusting» dice: los archivos legibles por máquina como llms.txt no hacen falta para aparecer en la búsqueda con IA generativa.
A los pocos días salió Lighthouse 13.3 y activó en la configuración por defecto la categoría «Agentic Browsing», la misma a la que una versión antes le habían añadido la auditoría de presencia de llms.txt.
Son dos consumidores distintos, y no una confusión. El equipo de Search describe el retrieval: cómo decide el sistema qué sitio traer a la respuesta. Lighthouse mira al agente que ya llegó al sitio y tiene que moverse por él.
John Mueller, de Google, lo formuló en el episodio de Search Off the Record del 15 de junio: llms.txt no le da al modelo ninguna forma de decidir qué sitio mostrar ante una consulta concreta. Un archivo autodeclarado no distingue un sitio de otro: cualquiera puede escribir sobre sí mismo que es la mejor fuente de su nicho. Ya en 2025 Mueller comparaba este planteamiento con la metaetiqueta keywords, y la comparación es exacta: una autodescripción sin verificar, fácil de manipular, deja pronto de ser una señal. El archivo tiene un papel, dice Mueller, pero es acotado y empieza cuando el agente ya está en el sitio.
Quién necesita de verdad el archivo
De los datos de Ahrefs sale una conclusión inesperadamente útil. llms.txt sí tiene lectores, solo que no son los bots de búsqueda.
Junto al crawler de entrenamiento de OpenAI, GPTBot, en lo más alto de la lista está Claude Code, un agente de desarrollador. Como Cursor, Copilot, navegadores agénticos. Un agente así ya está en tu dominio y quiere encontrar la descripción de la API sin abrirse paso entre doscientos kilobytes de HTML con navegación, banner de cookies y footer. El mapa en markdown le ahorra un paso.
De ahí la regla con la que vivo ahora. Si tu documentación supera las cincuenta páginas, pon llms.txt y llms-full.txt: tienen lectores medibles. Si es un sitio corporativo, un blog o una tienda pequeña, ponlo en media hora, cuando tengas un rato libre, y olvídate; es la última prioridad.
Lo que no conviene hacer en absoluto: presentárselo al cliente como «SEO para IA». Es fácil de vender, imposible de demostrar, y un año después habrá que explicar por qué no pasó nada.
Qué funciona en su lugar
Esto es lo que va primero en cualquier caso, y no es una alternativa al archivo. El orden sigue la fuerza de la evidencia, no la moda.
Lo primero y lo más burdo es el acceso del crawler. Ahí me quemé, por eso lo pongo a la cabeza de la lista. Un 403 significa que todo el resto del trabajo no tiene sentido: ni el contenido, ni el schema, ni los archivos existen para quien no pasó la puerta. El bloqueo hay que buscarlo a nivel de CDN, no en robots.txt, porque es ahí donde vive (y, a juzgar por mi caso, a veces se activa solo, junto con algún interruptor de seguridad «recomendado»).
Lo segundo es SSR o HTML estático. GPTBot, ClaudeBot y PerplexityBot no ejecutan JavaScript, así que el contenido que se termina de dibujar en el cliente, para ellos, simplemente no está.
Lo tercero es la indexación. ChatGPT Search saca sus candidatos de un índice de búsqueda; un sitio fuera del índice no aparecerá en la respuesta, por más mapas en markdown que pongas en la raíz.
Lo cuarto es la consistencia de la entidad: un solo nombre canónico en todas partes, @id en el esquema Organization, sameAs recíprocos hacia Wikidata y LinkedIn. Aquí tengo que frenar con las promesas. Schema App, en un estudio controlado con once páginas de prueba, obtuvo +46% de impresiones en consultas sin marca en 85 días; eso sí, junto con sameAs añadieron otras dos propiedades, así que no se puede atribuir el efecto solo a sameAs. Ahrefs, con una muestra de 75 mil marcas, obtuvo una correlación de las menciones con Google AI Overviews de 0,66, frente a 0,22 de los backlinks. Son correlaciones sobre datos observacionales, no causalidad demostrada, y no aconsejo convertirlas en una promesa al cliente.
Lo quinto es la profundidad del contenido, la única parte de GEO con respaldo revisado por pares. El Princeton GEO paper (KDD 2024) midió nueve tácticas: las estadísticas en el texto dan cerca de +41% de visibilidad del fragmento, las citas textuales +37–43%, las referencias a fuentes aproximadamente +30%. La salvedad la anotaron los propios autores: probaron sobre un proxy de Bing Chat y midieron el efecto solo entre páginas que ya estaban en el top 5. El SEO clásico aquí no «murió»: es el requisito previo.
También tengo cifras propias, y no demuestran nada. El 14 de junio pasé doce prompts por Perplexity: en total 10 puntos de 36, y las consultas comerciales de discovery dieron un cero rotundo de siete. La medición se hizo al día siguiente del deploy, antes de cualquier reindexación. Es el punto A, no un resultado. Desde entonces no he vuelto a tomar un corte comparable con el mismo método. En septiembre medí de otra forma —dieciocho prompts a través de las API de Claude, OpenAI y Gemini, dos ejecuciones por cada uno— y las consultas comerciales de categoría volvieron a dar cero en los tres motores. Las metodologías son distintas, así que no comparo los números entre sí; lo único que coincide es la conclusión: en las consultas comerciales no existo.
Tres comandos que te dirán más que llms.txt
Ejecútalos en tu dominio. Lleva un minuto.
# 1. ¿El CDN deja pasar a los crawlers de IA? 403 → el resto del trabajo es inútil
curl -sI -A "OAI-SearchBot/1.0" https://example.com/ | head -n 1

# 2. ¿Hay contenido en el HTML crudo? Los bots no ejecutan JavaScript
curl -s -A "GPTBot" https://example.com/ | grep -c "<h1"

# 3. Qué les permite realmente robots.txt a los bots de live-retrieval
curl -s https://example.com/robots.txt
Si el primer comando devolvió 403, acabas de encontrar la razón por la que no apareces en las respuestas de IA. Yo la encontré exactamente así, y me llevó medio año.
FAQ
¿Hace falta llms.txt para aparecer en las respuestas de IA?
No. Google lo dice directamente en la sección «mythbusting» de su guía: los archivos legibles por máquina no hacen falta para eso. Ningún gran proveedor de IA ha confirmado que use llms.txt como señal de cita.
¿Hace daño llms.txt?
No, siempre que no le dediques semanas. El archivo no bloquea nada ni rompe nada. El único daño: se come el presupuesto de atención que debía ir al acceso del crawler y al contenido.
Entonces, ¿por qué lo ponen las grandes empresas?
Sobre todo por los agentes de desarrollador. Cursor, Claude Code y los navegadores agénticos leen el archivo por convención de su propia herramienta. Para sitios con mucha documentación es una comodidad medible, no una táctica de búsqueda.
¿Cambiará esto pronto?
Puede ser. Lighthouse ya audita el archivo de cara a la navegación agéntica. Si el tráfico de agentes crece y los proveedores acuerdan una convención de solicitud, el canal aparecerá. Hoy no existe.
¿En qué se diferencia llms.txt de robots.txt?
robots.txt se solicita por convención, antes de la primera página, y controla el acceso. llms.txt no lo solicita nadie por defecto y no controla nada: es una autodescripción.
¿Qué hago primero si hay poco presupuesto para GEO?
Comprobar con curl y un user-agent de IA que el CDN no devuelva un 403. Cuesta cero y cierra el error más caro.
¿Cuánto cuesta poner llms.txt?
Media hora. Justo por eso la discusión a su alrededor es tan ruidosa: el coste del error es bajo en ambos sentidos, así que los dos bandos pueden discutir eternamente.
Ejecuta los tres comandos de arriba en tu dominio. Si el primero dio 403, escríbeme y vemos dónde está el bloqueo: en Cloudflare, en el WAF o en el propio robots.txt.
Análisis parecidos: cómo evalúo una herramienta de IA nueva, sobre cómo separar los datos del hype, y por qué me equivoqué con los precios de la IA, sobre revisar las afirmaciones propias cuando aparecen las cifras.
Escrito por Andrew Maryasov, consultor de IA, fundador de Auspex y Grow2.ai. Analizo agentes de IA y automatización para empresas: consultoría.
Fuentes:
- Ahrefs: llms.txt study: 137 000 dominios, logs de servidor, mayo de 2026
- Ahrefs: brand mentions and AI Overviews: muestra de 75 000 marcas, correlaciones de 0,664 y 0,218
- SE Ranking: llms.txt: ~300 000 dominios
- Limy.AI: llms.txt in 2026: log de 90 días, 500+ millones de visitas
- Otterly.AI: the llms.txt experiment: 62 100+ visitas de bots, 84 solicitudes al archivo
- Search Off the Record, episodio sobre Markdown y HTML: 15 de junio de 2026, la postura de John Mueller
- Google says llms.txt is comparable to the keywords meta tag: Search Engine Journal, resumen del comentario de Mueller de 2025
- Lighthouse v13.3.0 release notes: la categoría «Agentic Browsing» en la configuración por defecto
- Google: AI features and your website: sección mythbusting
- Schema App: measurable impact of scaling entity linking: +46% de impresiones en consultas sin marca en 85 días
- GEO: Generative Engine Optimization: Princeton, KDD 2024

Una carta sobre IA: 2–3 emails al mes
Ensayos personales sobre cómo la IA cambia nuestra forma de pensar y trabajar: qué probé yo mismo, qué funcionó y qué no. Al final, enlaces a lo mejor de lo que he leído.
Sin spam. Puedes darte de baja con un clic.