Водяные знаки в AI-тексте: что они доказывают, а что нет
Водяной знак, AI-детектор и C2PA-provenance — три разных механизма, которые постоянно путают. Ни один не доказывает того, чего от него ждут. Разбор по первоисточникам и по тому, чего на деле требует статья 50 AI Act.
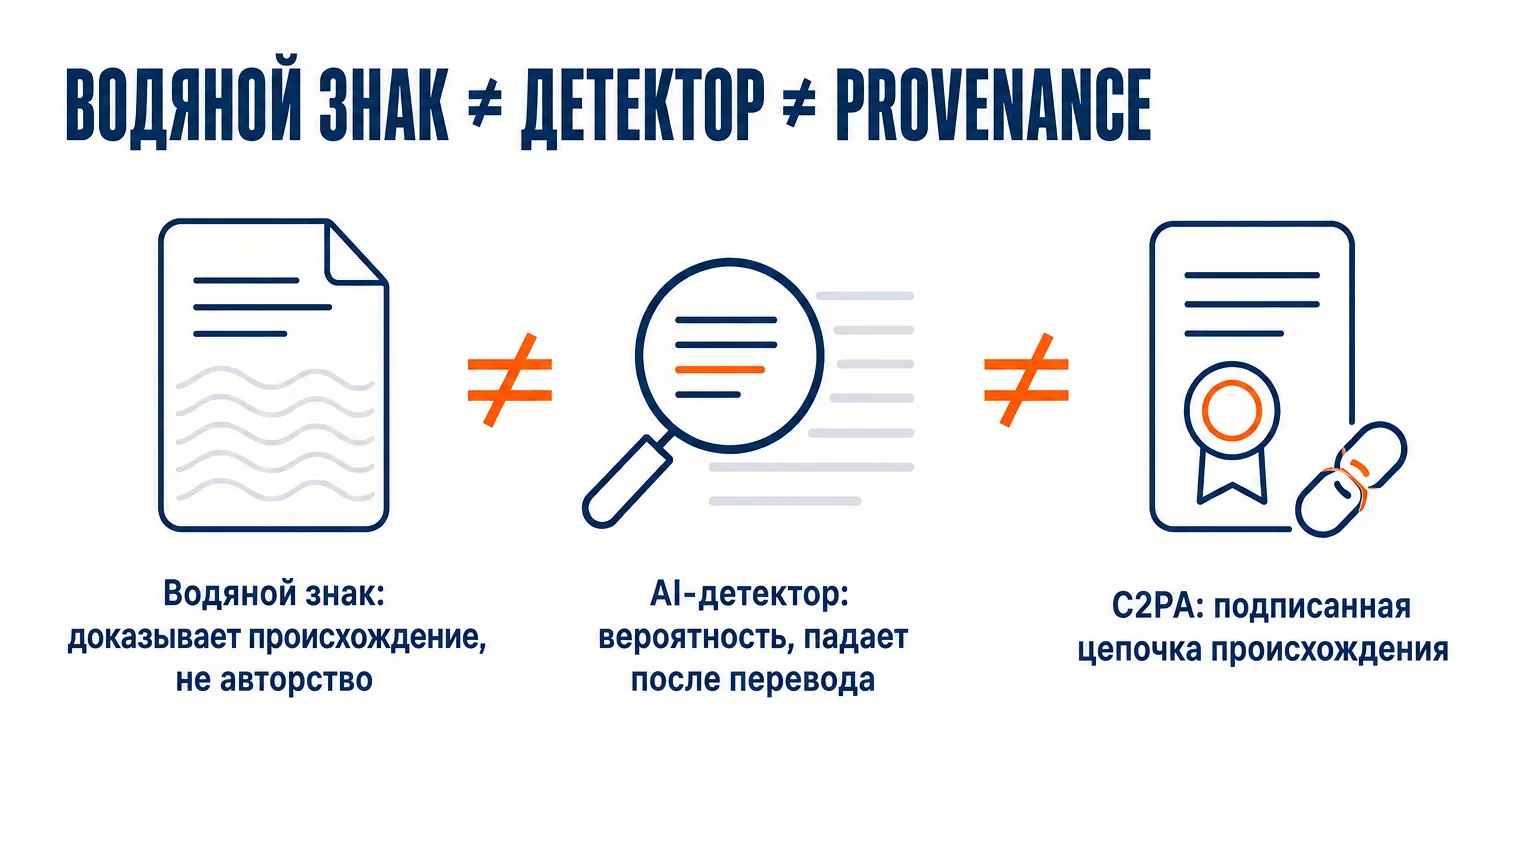
Андрей Марьясов, AI-консультант, основатель Auspex и Grow2.ai. Этот разбор — для тех, у кого в KPI редакции или в брифе подрядчику стоит слово «AI-детектор», и для юриста, которому подписывать страницу комплаенса. В разговоре про «этот текст написал AI» слипаются три разных механизма: водяной знак провайдера — статистический след в выборе токенов, который доказывает происхождение из конкретной модели тому, у кого есть детектор; AI-детектор — сторонняя угадайка, которая не доказывает ничего и систематически ошибается на текстах тех, для кого язык неродной; C2PA-provenance — криптоподпись издателя, которая доказывает, кто подписал файл, но намеренно не судит о правдивости содержимого. Обязанность, появившуюся в ЕС 2 августа 2026 года, снимают проверка человеком и названный ответственный, а не вычищение AI-следов.
TL;DR (за 30 секунд)
- Водяной знак доказывает происхождение, а не авторство. SynthID Text встраивает сигнал в выбор токенов; детекция вероятностная, и у неё три состояния, включая «неопределённо». Публичного маршрута проверки для текста нет.
- Перевод резко снижает уверенность детектора — это записано в документации Google. Напрямую касается команд, которые пишут на украинском и переводят на английский.
- AI-детекторы закрывали даже их авторы. OpenAI остановил собственный классификатор с 26% правильных распознаваний AI-текста и 9% ложных срабатываний на человеческом.
- Детекторы предвзяты к тем, для кого язык неродной: больше половины текстов non-native авторов помечено как AI, тогда как на носителях точность была близка к идеальной.
- C2PA прямо отказывается судить об истине. Он подтверждает, что данные не подделаны и подписант известен, — а не то, что написанное соответствует действительности.
- У статьи 50(4) AI Act есть собственное исключение: обязанность раскрывать не действует, если контент прошёл проверку человеком и кто-то несёт редакционную ответственность. При этом сама 50(4) касается текста по общественно значимым вопросам — продуктовый блог или рассылка под неё автоматически не подпадают.
Ответ провайдера изменился за две недели
5 августа 2026 года разработчик из ЕС задал на официальном форуме Google предельно конкретный вопрос: есть ли водяной знак в тексте, который возвращает Gemini API. Вопрос прикладной — ему нужно было закрыть требование статьи 50(2) AI Act в собственной игре. В тот же день представитель Google ответил, что нет и что нативный вотермаркинг текста не планируется.
19 августа тот же представитель вернулся в тред с «важным исправлением»: после дополнительной проверки с командой выяснилось, что текст из Gemini API всё-таки помечается SynthID. Следующие вопросы других участников треда — применялся ли знак всегда или его ввели в какой-то момент и каким инструментом это проверить — на октябрь 2026 года остаются без ответа. Документация об этом молчит до сих пор.
Строить страницу комплаенса на ответе с форума нельзя ни в первой его редакции, ни во второй. Если официальная поддержка дважды за две недели даёт противоположные ответы о собственном продукте, водяной знак — это свойство, о котором вы узнаёте по слухам. Процессы на таком не строят.
Три механизма, которые не взаимозаменяемы
| Механизм | Кто ставит | Что технически доказывает | Чего не доказывает |
|---|---|---|---|
| Водяной знак (SynthID Text) | Провайдер модели во время генерации | Что текст сгенерирован конкретной моделью — для того, у кого есть детектор | Что вы сможете это проверить |
| AI-детектор (сторонний) | Никто, это анализ постфактум | Ничего. Это статистическая догадка о стиле | Ни происхождения, ни авторства |
| C2PA / Content Credentials | Издатель, подписывая файл | Кто подписал и что данные не изменены после подписи | Что содержимое правдиво |
Разница не терминологическая. Эти три вещи отвечают на три разных вопроса, а бизнес обычно хочет ответ на четвёртый: «могу ли я за это отвечать». На него не отвечает ни один из трёх.
Водяной знак: что он может и чего не может
SynthID Text — не метка, дописанная к тексту, и не запись в метаданных. Во время генерации он смещает вероятности токенов по псевдослучайной функции: модель выбирает чуть другие слова, чем выбрала бы без него, причём так, чтобы этот сдвиг потом можно было обнаружить статистически, а текст заметно не испортился. Метод описан в статье в Nature (Dathathri, See и др., 23 октября 2024), код реализации Google открыл.
Ограничения, которые видны из документации и почти не попадают в пересказы, значат больше самого метода.
Знак хуже ложится именно на фактологический текст. Документация формулирует это прямо: в фактологических ответах меньше простора менять формулировки, не испортив точность. Чем ближе текст к сухой справке, тем слабее сигнал — а это ровно тот тип контента, который бизнес чаще всего и генерирует.
Перевод сбивает детектор. Уверенность сильно снижается, если текст тщательно переписали или перевели на другой язык; устойчивость сохраняется только к обрезанию фрагментов, замене нескольких слов и лёгкому перефразированию. Для типового цикла «черновик на украинском, потом англоязычная версия в LinkedIn» это значит, что после перевода полагаться на знак уже нельзя.
Кто может проверить — решает провайдер. Режимов три: полностью приватный детектор, полуприватный через API и публичный. Для текста публичного маршрута сегодня нет. То есть даже если вотермарк в ваш текст встроили, показать это можете не вы.
Водяной знак — инструмент провайдера для провайдера. Он работает в споре, где одна из сторон — владелец детектора, и не даёт вам как издателю никакого способа что-то доказать о собственном контенте.
AI-детекторы: единственный из трёх, который не доказывает ничего
Детектор часто воспринимают как облегчённую версию водяного знака. Общего у них нет ничего: водяной знак ищет сигнал, который туда намеренно положили, детектор смотрит на готовый текст и угадывает по стилистике.
OpenAI закрыл собственный. AI Text Classifier запустили в январе 2023-го и остановили 20 июля того же года, объяснив это низкой точностью. Цифры компания опубликовала сама: на англоязычном «challenge set» классификатор правильно распознавал 26% AI-текстов и ошибочно помечал человеческий текст как AI в 9% случаев. Девять процентов ложных срабатываний — это каждый одиннадцатый текст, написанный человеком.
Вторая часть проблемы бьёт точно по украинским командам. Исследование Стэнфордского университета, опубликованное в журнале Patterns в 2023 году, прогнало через семь распространённых детекторов тексты носителей английского и тех, для кого он неродной. Больше половины образцов, написанных неносителями, детекторы отнесли к сгенерированным AI, тогда как на текстах носителей точность была близка к идеальной. Механизм авторы тоже показали: детекторы реагируют на более бедный словарный запас и более простой синтаксис, и обогащение лексики снижало долю ложных срабатываний. Там же — о надёжности с другой стороны: простые инструкции модели позволяли эти детекторы обойти.
Инструмент систематически штрафует тех, кто пишет на втором языке, и пропускает тех, кто сознательно его обходит.
И исследование, и закрытие классификатора датируются 2023 годом; сегодняшние вендоры заявляют более высокую точность. Но это заявления самих продавцов: рецензируемой проверки, которая опровергла бы эффект на неносителях, по состоянию на сентябрь 2026 года найти не удалось. Пока её нет, вердикт детектора остаётся догадкой, и строить на нём кадровые или редакционные решения нельзя. Это ошибка того же класса, что и с метрикой уклонения для мониторинга агентов: число существует, выглядит убедительно, но отвечает не на тот вопрос, который вы задаёте.
C2PA: доказывает подписанта, а не истину
C2PA (Coalition for Content Provenance and Authenticity) заходит с другой стороны. Вместо того чтобы искать следы в тексте, он добавляет к файлу подписанный манифест — Content Credential: кто создал, чем редактировали, что из чего сделано. Спецификация не ограничена картинками: среди форматов, которые манифест может декларировать, есть и text/plain.
В собственном пояснительном документе консорциума сказано прямо: Content Credentials не дают оценочных суждений о том, является ли набор данных о происхождении «правдивым», — они лишь подтверждают, что эта информация корректно сформирована, не подделана и подписана кем-то из известного списка доверия.
Поддельный отчёт с безупречным C2PA-манифестом остаётся поддельным отчётом — просто теперь точно известно, кто его подписал. Бесполезным механизм от этого не становится: C2PA переводит разговор с «писал ли это AI» на «кто за это отвечает», а ответ на второй вопрос можно проверить.
Чего на самом деле требует закон
Статья 50 AI Act применяется со 2 августа 2026 года.
Статья 50(2) — обязанность поставщика. Поставщики систем, генерирующих синтетический звук, изображения, видео или текст, должны обеспечить, чтобы выходные данные были помечены в машиночитаемом формате и распознавались как сгенерированные AI. Дальше — оговорка, в которой и живёт слабость текстового вотермаркинга: решения должны быть эффективными и надёжными «насколько это технически возможно», с учётом ограничений разных типов контента, стоимости внедрения и состояния технологии. Там же есть исключение, о котором обычно забывают: обязанность не действует там, где AI выполняет вспомогательную функцию для стандартного редактирования либо существенно не меняет входные данные или их смысл. Проверка орфографии или перефразирование абзаца машиночитаемой маркировки не требуют.
Статья 50(4) — обязанность того, кто публикует. Те, кто применяет AI для создания или изменения текста, опубликованного, чтобы информировать общество по общественно значимым вопросам, должны раскрыть, что текст сгенерирован или изменён искусственно. И сразу исключение: обязанность не действует, если контент прошёл проверку человеком или редакционный контроль и если физическое или юридическое лицо несёт редакционную ответственность за публикацию. Регламент прямо называет условие, при котором маркировать не нужно, и это не вычищение AI-стилистики, не «гуманизация» текста и не прохождение детектора.
О переходном периоде: Регламент (ЕС) 2026/1744 (Digital Omnibus on AI) опубликован в Официальном журнале 24 июля 2026 года, действует с 27 июля 2026 года; он добавил в AI Act статью 111(4) — системы, выпущенные на рынок до 2 августа 2026 года, должны быть приведены в соответствие со статьёй 50(2) до 2 декабря 2026 года. На системы, выпущенные после 2 августа, эта отсрочка не распространяется, а сама статья 50(2) не откладывалась.
Что с этим делать
Перестаньте измерять то, что не измеряется. Прогон собственного текста через детектор перед публикацией не даёт информации. Он даёт число, которое у вашего копирайтера, пишущего на неродном языке, будет хуже, чем у носителя, независимо от того, писал там AI или нет. Если этот показатель стоит в KPI, его надо оттуда убрать; и по той же причине не стоит обещать клиенту «текст без AI-следов».
Зафиксируйте, кто читал. Исключение в 50(4) звучит как бюрократия, но описывает обычную редакционную работу, которую большинство команд уже делают и просто не оформили: имя редактора рядом с материалом, дата последней проверки, сохранённые ссылки на источники под каждой цифрой. Разница между «у нас редактор смотрит» и «у нас есть редакционная ответственность» — это десять минут на то, чтобы записать, кто именно смотрел.
Ведите журнал источников, а не журнал промптов. Когда прилетит претензия, вопрос будет «откуда взята эта цифра». Происхождение из модели вы не докажете, а источник — докажете, если ссылка сохранена.
Статус вотермаркинга запрашивайте у поставщика письменно. Из документации или от аккаунт-менеджера, с датой. История с Gemini API показывает, чего стоит устный ответ.
Логика та же, что и в безопасности системного промпта: защищает механизм, который вы можете проверить и показать, а не тот, который выглядит как защита. И точно так же, как с llms.txt, вокруг технической метки выросло больше ожиданий, чем она способна выдержать.
Вопрос «писал ли это AI» постепенно теряет смысл: надёжного ответа на него нет и не будет. У вопроса «кто проверил факты и кто отвечает, если они неверны» ответ есть всегда.
FAQ
Можно ли проверить, есть ли в тексте водяной знак SynthID?
Публичного инструмента для текста нет. Google описывает три модели доступа к детектору — полностью приватную, полуприватную через API и публичную, — и выбор делает провайдер. Опубликованные маршруты проверки SynthID принимают изображения, видео и аудио.
Обязан ли бизнес маркировать AI-контент в ЕС?
Статья 50 AI Act действует со 2 августа 2026 года. Поставщики генеративных систем должны снабжать выходные данные машиночитаемой пометкой (50(2)). Те, кто публикует AI-текст по общественно значимым вопросам, должны это раскрывать (50(4)) — но не тогда, когда контент прошёл проверку человеком или редакционный контроль и есть лицо с редакционной ответственностью за публикацию.
Достаточно ли приписки «создано с помощью AI»?
Для случая из статьи 50(4) регламент даёт альтернативу: проверка человеком плюс названный ответственный за публикацию снимают обязанность раскрытия. Для поставщиков систем из 50(2) видимая приписка не заменяет машиночитаемую пометку — это разные требования к разным участникам.
Что делать, если клиент требует гарантию, что текст пройдёт AI-детектор?
Такую гарантию нельзя дать без обмана: результат детектора нестабилен и зависит от языка автора больше, чем от способа создания текста. Вместо неё стоит предлагать то, что проверяется, — сверенные источники, названное авторство и редакционную ответственность за факты.
Опубликовал Андрей Марьясов, AI-консультант, основатель Auspex и Grow2.ai; внедрения ведут Auspex (CRM) и Grow2.ai (AI-агенты).
Источники:
- Google AI for Developers — SynthID: Tools for watermarking and detecting LLM-generated Text (документация, обновлена 09.04.2025)
- Dathathri S., See A., Ghaisas S. и др. «Scalable watermarking for identifying large language model outputs», Nature, 23.10.2024
- Тред о вотермаркинге текста в Gemini API, официальный форум Google AI Developers, 5–19.08.2026
- OpenAI — New AI classifier for indicating AI-written text (январь 2023, с примечанием о закрытии в июле 2023)
- Liang W., Yuksekgonul M., Mao Y., Wu E., Zou J. «GPT detectors are biased against non-native English writers», Patterns 4(7):100779, Stanford University, 2023
- C2PA — Content Credentials Explainer 2.3, §2 (откуда цитата об отсутствии оценочных суждений) и техническая спецификация 2.3 (где
text/plainсреди форматов манифеста) - Регламент (ЕС) 2024/1689 (AI Act), статья 50; руководящие указания Европейской комиссии по обязательствам прозрачности
- Регламент (ЕС) 2026/1744, опубликован в OJ 24.07.2026, действует с 27.07.2026 (Digital Omnibus on AI) — статья 111(4) AI Act и переходный период до 02.12.2026 для систем, выпущенных на рынок до 02.08.2026

Письмо об AI — 2–3 письма в месяц
Личные эссе о том, как AI меняет мышление и работу: что я попробовал сам, что сработало, а что нет. В конце — ссылки на лучшее за последнее время.
Без спама. Отписаться можно в один клик.