Почему AI-агент ошибается: виноват поиск, а не модель
Stanford и Together AI проверили шесть чат-ботов на 2100 вопросах: больше 70% ошибок даёт поиск, а не рассуждение. Что это значит для вашего RAG-пайплайна.
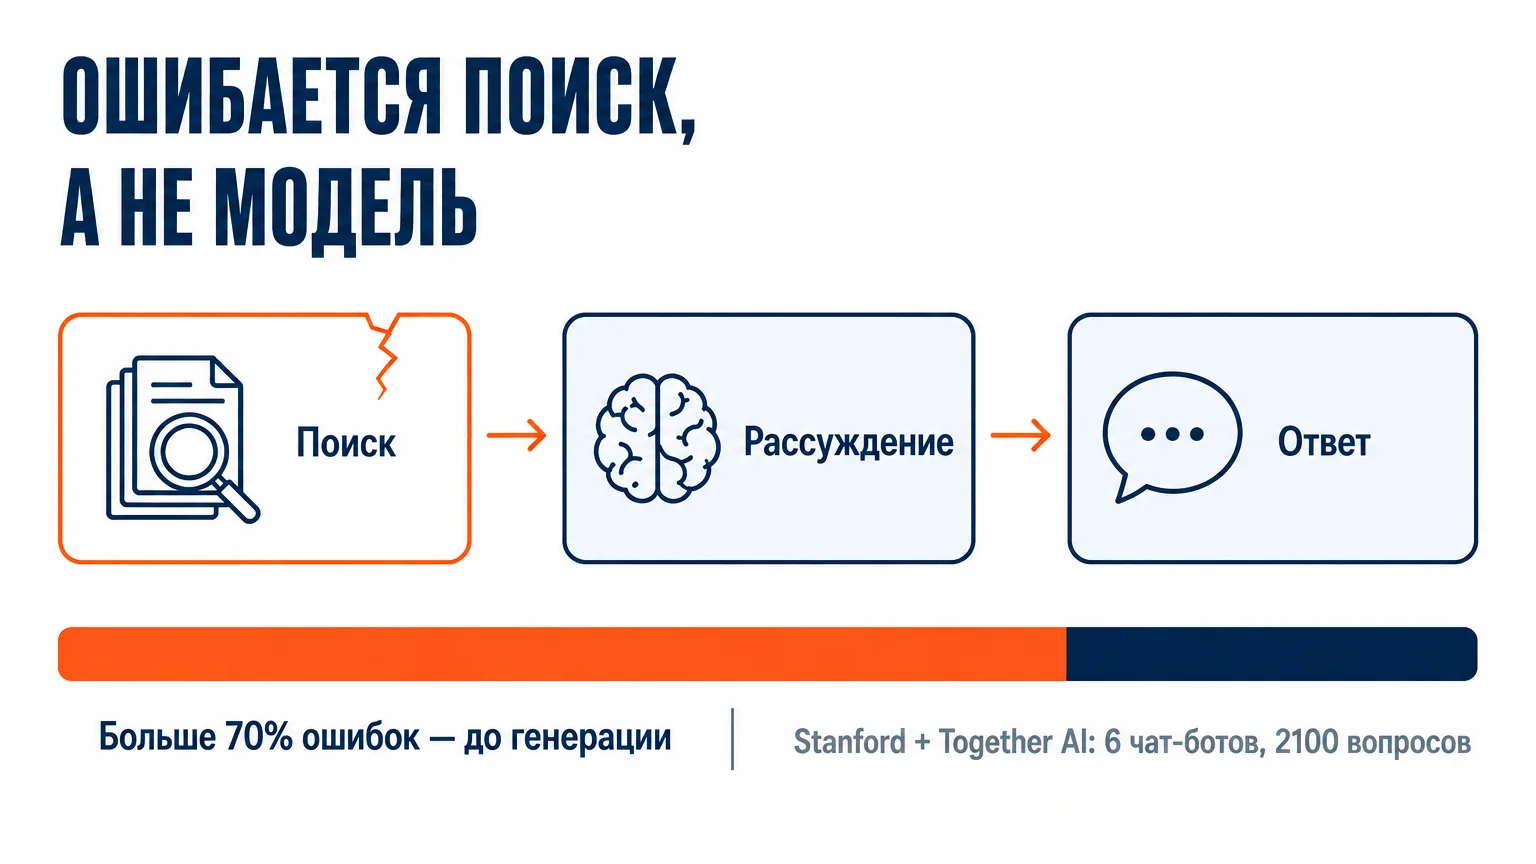
Андрей Марьясов, AI-консультант, основатель Auspex и Grow2.ai. Когда агент даёт неправильный ответ, первая реакция бизнеса — взять модель поумнее. Исследование Stanford и Together AI на 2100 вопросах показало другое: больше 70% ошибок возникают на шаге поиска, а не рассуждения. Когда модель находит правильный источник, она почти всегда правильно извлекает из него факт. Вся сложность — вообще попасть на нужный документ.
Сразу два слова, которые дальше встречаются часто. Retrieval — шаг, на котором система ищет и подкладывает агенту документы, прежде чем тот начнёт отвечать. RAG — вся конструкция «сначала найди в базе, потом отвечай по найденному».
TL;DR (за 30 секунд)
- Ошибка агента чаще всего случается до генерации. Агенту принесли не тот документ, и он добросовестно на нём отработал.
- Stanford вместе с Together AI прогнали шесть коммерческих чат-ботов через 2100 вопросов по свежим новостям BBC в течение 14 дней. Формулировка авторов: retrieval, а не reasoning, даёт больше 70% всех ошибок.
- Разбивка причин: провал поиска — 38,8%, найденное «на ту же тему, но не о том» — 32,7%.
- Лучшие системы дают больше 90% на вопросах с вариантами ответа. В свободной форме точность проседает на 11–13 процентных пунктов, по всей когорте — на 16–17.
- Самая низкая точность — на хинди: по данным исследования, в среднем 79% против 89–91% на других языках, формат тот же, с вариантами. Причина не в языковых способностях модели, а в перекосе индекса: в ответ на запросы на хинди модели цитируют англоязычную «Википедию» чаще, чем любое новостное издание на хинди.
- Стоит подбросить в запрос одну ложную предпосылку — и точность, по данным той же работы, падает с 88–96% до 19–70%, даже когда системе прямо разрешали ответить «недостаточно информации». Самая уязвимая модель принимала выдуманный факт на веру в 64% случаев.
- Практический вывод: прежде чем платить за модель подороже, потратьте тот же бюджет на поиск. Он окупается лучше.
2100 вопросов, шесть чат-ботов, четырнадцать дней
В мае 2026 года группа Мирача Сузгуна из Stanford вместе с Together AI выложила работу «Evaluating Commercial AI Chatbots as News Intermediaries» (arXiv:2605.22785). В июле её разобрал The Batch под заголовком Web Retrieval Flusters LLMs.
Дизайн простой и прозрачный. Четырнадцать дней подряд, с 9 по 22 февраля 2026 года, авторы брали свежие материалы BBC News из шести региональных служб и генерировали по ним вопросы о событиях, которые произошли буквально несколько часов назад. Получилось 2100 вопросов. Дальше шесть чат-ботов с включённым веб-поиском пытались на них ответить; состав когорты в исследовании такой: Gemini 3 Flash и Pro, Grok 4, Claude 4.5 Sonnet, GPT‑5 и GPT‑4o mini.
Тест на свежих новостях закрывает главную лазейку. Модель не могла знать ответ из обучающих данных: событие произошло уже после обучения. Единственный путь к правильному ответу — найти нужный материал и извлечь из него факт. Это ровно та конфигурация, в которой работает любой ваш агент на корпоративных данных, только вместо BBC там ваша база договоров.
Первый результат выглядит успокаивающе. На вопросах с пятью вариантами ответа результаты исследования такие: Gemini 3 Flash дал 95,6%, Grok 4 — 95,0%, Gemini 3 Pro — 93,7%, Claude 4.5 Sonnet — 90,4%. GPT‑5 набрал 85%, GPT‑4o mini — 69%.
Но потом авторы убрали варианты ответов и попросили ответить своими словами. Лучшие системы потеряли 11–13 процентных пунктов, по всей когорте просадка составила 16–17. То есть заметная часть тех «девяноста с лишним процентов» держалась на угадывании правильного варианта из списка — примерно тем же занимается школьник на тесте, когда знает материал приблизительно.
Главная цифра: больше 70% ошибок — это поиск
Дальше авторы классифицировали причины неправильных ответов. Каждый провал разбирали по категориям: не нашёл, нашёл не то, не понял, перепутал хронологию.
Формулировка из аннотации статьи звучит так: retrieval, а не reasoning, даёт больше 70% всех ошибок. Когда модели удаётся достать правильный источник, она в подавляющем большинстве случаев правильно извлекает из него ответ. Вся сложность — вообще попасть на нужный источник.
The Batch приводит разбивку по двум самым крупным категориям:
| Причина ошибки | Доля |
|---|---|
| Провал поиска — нужный материал не нашли вообще | 38,8% |
| Нашли источник по теме, но с другими деталями — он не отвечает на конкретный вопрос | 32,7% |
| Остальные причины вместе — понимание, хронология и прочее (получено вычитанием, в источнике отдельно не приведено) | ~28,5% |
Вторая категория — это не «ничего не нашёл». Это «нашёл что-то разумное и релевантное, только не то». Авторы называют ответы, собранные из таких источников, «smart wrong» — умные, но неправильные. Снаружи ответ выглядит обоснованным: агент цитирует реальный документ, документ действительно по теме, в нём действительно есть цифры. Просто цифры относятся к другому периоду, другому региону или другому объекту.
Именно эта категория обходится бизнесу дороже всего, потому что она не выглядит как ошибка. Пустой ответ ловит любая проверка, а вот уверенный ответ с живой ссылкой не на тот документ человеческий глаз пропускает без сопротивления.
Почему «возьмём модель поумнее» не срабатывает
Стандартная реакция на ошибку агента: модель глупая, берём старшую. Данные статьи говорят, что эти деньги по большей части уйдут мимо проблемы.
Логика тут почти арифметическая. Ответ агента на вопрос, которого не было в его обучающих данных, держится на трёх шагах: получить нормально сформулированный вопрос, найти релевантный документ, извлечь из него факт. Модель отвечает за третий шаг и немного за первый. Больше 70% ошибок сидят на втором.
Апгрейд модели улучшает то, что и так работает на 90+ процентов, и не трогает то, что ломается.
Авторы делают из этого прямой вывод: улучшение поиска, скорее всего, даст больший прирост качества, чем наращивание параметров модели — по крайней мере там, где запросы касаются актуальной информации. Три направления, которые они называют: полнота индекса (какие документы вообще попадают в поиск), ранжирование источников (в каком порядке найденное ложится перед моделью) и обработка запросов не на английском.
История с хинди тут показательна. На тех же вопросах с вариантами ответа каждая модель показала худшую точность именно на хинди: по данным той же работы, в среднем 79% против 89–91% на других языках. При этом, отвечая на запросы на хинди, модели цитировали англоязычную «Википедию» чаще, чем любое новостное издание на хинди. Это не «модель хуже знает хинди». Это индекс, собранный англоязычным миром для англоязычного мира, и поиск, который на неанглийском запросе соскальзывает на англоязычный источник. Абсолютно та же механика сработает на вашей базе документов на любом языке, кроме английского, если векторная модель и поисковый стек настроены по умолчанию.
Пять способов принести агенту не тот документ
Дальше — режимы отказа, которые я регулярно вижу в рабочих пайплайнах. Первый и пятый прямо ложатся на категории из исследования, остальные три — из практики построения retrieval-контуров.
1. Нашёл релевантное, но не нужное
Та самая категория на 32,7%. Агент ищет условие договора о сроках оплаты, а индекс отдаёт общую страницу раздела «Условия сотрудничества». Тема совпадает, конкретики нет. Или спросили о материале, а нашёлся профиль его автора: слова те же, объект другой.
Механизм простой: релевантность теме и релевантность вопросу — разные вещи, а большинство поисковых конфигураций по умолчанию оптимизирует первую.
2. Перепутанная сущность
Одно название может одновременно быть компанией, продуктом и проектом. Агент достаёт абсолютно корректные данные — только о другом объекте. Внутри одного клиента это случается постоянно: тариф и одноимённая услуга, юрлицо и бренд, название проекта и название папки.
Эту ошибку труднее всего поймать при просмотре, потому что в тексте всё правда — кроме привязки.
3. Семантическое сходство вместо точного совпадения
Самая типичная инженерная ловушка. Векторный поиск по своему устройству ищет «о том же», а не «именно то». На разговорном запросе это преимущество, на точном идентификаторе — источник ошибок.
Артикул, номер заказа, версия документа, номер нормы, название тарифа, дата — это ровно те сущности, где семантически близкий результат и есть неправильный результат. И это ровно те сущности, где цена ошибки самая высокая. Сходство по смыслу побеждает точное совпадение, и агент уверенно берёт соседнюю строку.
4. Источник устарел
Документ когда-то был правильным. Политику переписали, тариф изменили, регламент обновили — а старая версия осталась в индексе без какого-либо штрафа за давность. Поиск добросовестно отдаёт самый релевантный фрагмент, и релевантным оказывается прошлогодний.
Тут есть и вторая часть проблемы: источник обновили, а переиндексацию не сделали. Формально данные свежие, в поиске — старая копия.
5. Нет состояния «не нашёл»
Самая архитектурная из пяти. Если в системе не предусмотрено разрешение сказать «доказательств недостаточно», она оптимизируется под завершённость ответа, а не под его достоверность.
В исследовании этот эффект измеряли отдельно: в запросы подбрасывали одну ложную предпосылку — неправильную фамилию, сдвинутую дату, выдуманную деталь — и добавляли вариант «недостаточно информации для ответа». По данным исследования, точность упала с 88–96% до 19–70% в зависимости от модели. Самая уязвимая принимала выдуманный факт на веру в 64% случаев. То есть в двух третях случаев система не заметила, что вопрос построен на неправде, и добросовестно искала подтверждение тому, чего не было.
Авторы заметили ещё и отдельную странность, которую назвали detection-accuracy paradox: лучший детектор ложных предпосылок оказался лишь вторым по способности всё-таки дать правильный ответ. Заметить подвох в вопросе и выбраться из него — это, похоже, две разные способности, и одна не тянет за собой другую.
Агент, который не умеет отказываться отвечать, опаснее того, кто отказывается лишний раз. Похожая механика работает и в других контурах — я разбирал её на примере того, как агент ломает собственную метрику, когда система вознаграждает факт завершения работы, а не её качество.
Что с этим делать
Порядок ниже — от самого дешёвого к самому дорогому во внедрении.
Разделить поиск и ответ. Сначала агент возвращает структурированный результат поиска: какие документы найдены, с какой датой, из какого источника. Только после этого — генерация по этим фрагментам. Пока два шага слиты в один вызов, вы не можете сказать, где именно сломалось, и любое «улучшение промпта» стреляет вслепую.
Проверять соответствие фрагмента вопросу, а не теме. Между «этот текст о сроках оплаты» и «этот текст содержит ответ на вопрос о сроке оплаты по договору №» — пропасть. Реранкер, который оценивает именно второе, снимает большую часть категории «smart wrong».
Hybrid retrieval вместо чистых embeddings. Разложите нагрузку: keyword-поиск (BM25 — классический алгоритм ранжирования по совпадению слов) берёт точные идентификаторы, коды, названия и версии; векторный — разговорные и перефразированные запросы; реранкер упорядочивает кандидатов; фильтры по метаданным отсекают чужого клиента, не тот период и не ту версию. Это не «улучшенные эмбеддинги», это распределение рисков между механизмами, каждый из которых силён там, где другой слеп.
Дальше идут две дешёвые вещи, которые почему-то делают последними. Свежесть должна быть отдельным сигналом ранжирования: recency scoring плюс политика устаревания, потому что документ без даты индексации — это документ без срока годности. А provenance — паспорт фрагмента: источник, версия, время индексации, позиция в файле — нужен на каждом фрагменте: ответ без валидной ссылки просто не должен доходить до пользователя. Это самый дешёвый способ превратить невидимую ошибку в видимую, и его почти всегда откладывают «на потом».
Тестировать retrieval отдельно от генерации. Заведите набор реальных запросов, для каждого зафиксируйте, какой документ — правильный ответ, и измеряйте одну вещь: попадает ли этот документ в top-k, то есть в ту горсть результатов, которую поиск реально отдаёт агенту. Не «хорош ли ответ агента» — именно нашёлся ли нужный файл. Тридцати запросов достаточно, чтобы увидеть картину, поэтому это работа на полдня, а не на квартал.
Эта метрика вообще не зависит от модели, поэтому только она показывает в чистом виде эффект от изменений в чанкинге (том, как длинный документ режут на фрагменты), индексации и ранжировании. И она же отвечает на вопрос, есть ли смысл в следующем апгрейде: если нужный документ не доезжает до контекста в трети случаев, самая умная модель на рынке эту треть не спасёт.
Логика та же, что и в самообучении агента: пока результат нельзя проверить автоматически, улучшениям не от чего отталкиваться.
Последнее — явное состояние «не нашёл достаточно доказательств» и маршрут эскалации на человека. Это уже часть ответа на вопрос, какой blast radius у вашего агента: система, которая умеет остановиться, ограничивает последствия собственной ошибки.
Самая дешёвая проверка, с которой стоит начать завтра: возьмите пять последних жалоб на агента и посмотрите, какие документы ему дали, а не что он ответил. Если за агента у вас отвечает отдельный человек — этот абзац для него, и просить нужно именно логи контекста, а не примеры плохих ответов.
Цепочка, в которой ломается
Если свести всё к одной схеме, путь от данных до ответа выглядит так:
Источник → Извлечение → Нормализация → Хранение → Индексация → Поиск → Реранкинг → Ответ
Модель отвечает за последнее звено. Исследование говорит, что большинство ошибок сидит в двух предпоследних. А в моей практике чаще всего виноваты первые три: в векторную базу заливают сырой дамп неструктурированных файлов, атомарную единицу индексации выбирают наугад, обновление источника не тянет за собой переиндексацию. Данные вроде бы есть, только агент не может их надёжно достать.
Поэтому диагностика начинается с вопроса «что именно легло агенту в контекст, когда он ошибся», и только потом доходит до выбора модели. Ответ на него почти всегда есть в логах — если вы их пишете. Примерно по той же логике я оцениваю и новые AI-инструменты: сначала смотрю, что система показывает о собственной работе, а уже потом — насколько умно она говорит.
RAG не снимает проблему, а переносит её
Агент, который ошибся, чаще всего не «плохо подумал». Он открыл не ту страницу и добросовестно пересказал её содержимое. Модель поумнее в этом сценарии меняет только качество формулировок — и именно поэтому апгрейд так часто разочаровывает: те же ошибки, изложенные профессиональнее.
Сам RAG тоже не спасает, он меняет характер ошибки. Вместо «модель выдумала» вы получаете «модель уверенно пересказала не тот документ». Вторую хотя бы можно проследить до конкретного файла, но только если в системе есть provenance, даты и отдельные метрики поиска. Без них вы всё так же смотрите на гладкий абзац и не можете проверить, откуда он взялся.
Мой опыт говорит, что большинство разборов «почему агент ошибся» заканчивается в трёх строках лога о том, какой файл попал в контекст.
FAQ
Решает ли RAG проблему галлюцинаций?
Нет, RAG меняет её природу. Вместо выдуманного факта вы получаете реальный факт из неправильного документа. Это лучше, потому что ошибку можно проследить до источника, но только при условии, что у каждого фрагмента есть provenance — ссылка, версия и дата.
Как понять, что проблема именно в retrieval, а не в модели?
Возьмите несколько десятков запросов, на которых агент ошибся, и посмотрите, какой контекст ему фактически передали. Если нужный документ в контексте был, а ответ неправильный — это модель. Если документа не было или был не тот — это поиск. В исследовании Stanford и Together AI второе составило больше 70% случаев.
Что такое hybrid retrieval и почему одних embeddings недостаточно?
Это сочетание keyword-поиска (BM25) для точных совпадений, векторного — для смысла, реранкера — для упорядочивания кандидатов и фильтров по метаданным. Чистый векторный поиск по своему устройству находит «о том же», а не «именно то», поэтому проигрывает на артикулах, номерах, версиях и датах — там, где цена ошибки самая высокая.
Что дешевле: улучшить поиск или взять модель подороже?
Авторы исследования прямо пишут, что улучшение retrieval, скорее всего, даст больший прирост точности, чем наращивание параметров модели — по крайней мере для запросов об актуальной информации. Дополнительный аргумент: результат от смены модели вы не контролируете, а изменения в индексе, ранжировании и метаданных остаются вашими.
Можно ли заменить retrieval большим контекстным окном?
Если весь полезный корпус помещается в контекст — да, и это часто проще пайплайна. Границу стоит определять измерением: прогнать одну и ту же задачу на 10, 50, 200 и 500 тысячах токенов и найти точку, где качество начинает падать. Именно она показывает, когда retrieval действительно нужен.
Что делать, если запрос пользователя содержит ложную предпосылку?
Предусмотреть явный вариант «недостаточно данных» и научить систему им пользоваться. В исследовании моделям давали вопросы с одной неверной деталью и при этом добавляли ответ «недостаточно информации» — точность на таком наборе падала с 88–96% до 19–70%, а самая уязвимая модель принимала выдуманный факт на веру в 64% случаев. Без разрешения отказаться система оптимизируется под завершённость ответа, а не под его правдивость.
Как тестировать retrieval отдельно от генерации?
Соберите набор реальных запросов с заранее известными правильными документами и измеряйте, попадает ли нужный документ в top-k выдачи. Эта метрика не зависит от модели, поэтому показывает в чистом виде эффект от изменений в индексации, чанкинге и ранжировании.
Источники: Suzgun M., Shen E., Bianchi F., Spangher A., Icard T., Ho D. E., Jurafsky D., Zou J. «Evaluating Commercial AI Chatbots as News Intermediaries», arXiv:2605.22785, 21.05.2026; разбор The Batch, «Web Retrieval Flusters LLMs», 24.07.2026.
Опубликовал Андрей Марьясов, AI-консультант, основатель Auspex и Grow2.ai; внедрения ведут Auspex (CRM) и Grow2.ai (AI-агенты).

Письмо об AI — 2–3 письма в месяц
Личные эссе о том, как AI меняет мышление и работу: что я попробовал сам, что сработало, а что нет. В конце — ссылки на лучшее за последнее время.
Без спама. Отписаться можно в один клик.