Локальные AI-модели: когда данные не покидают офис
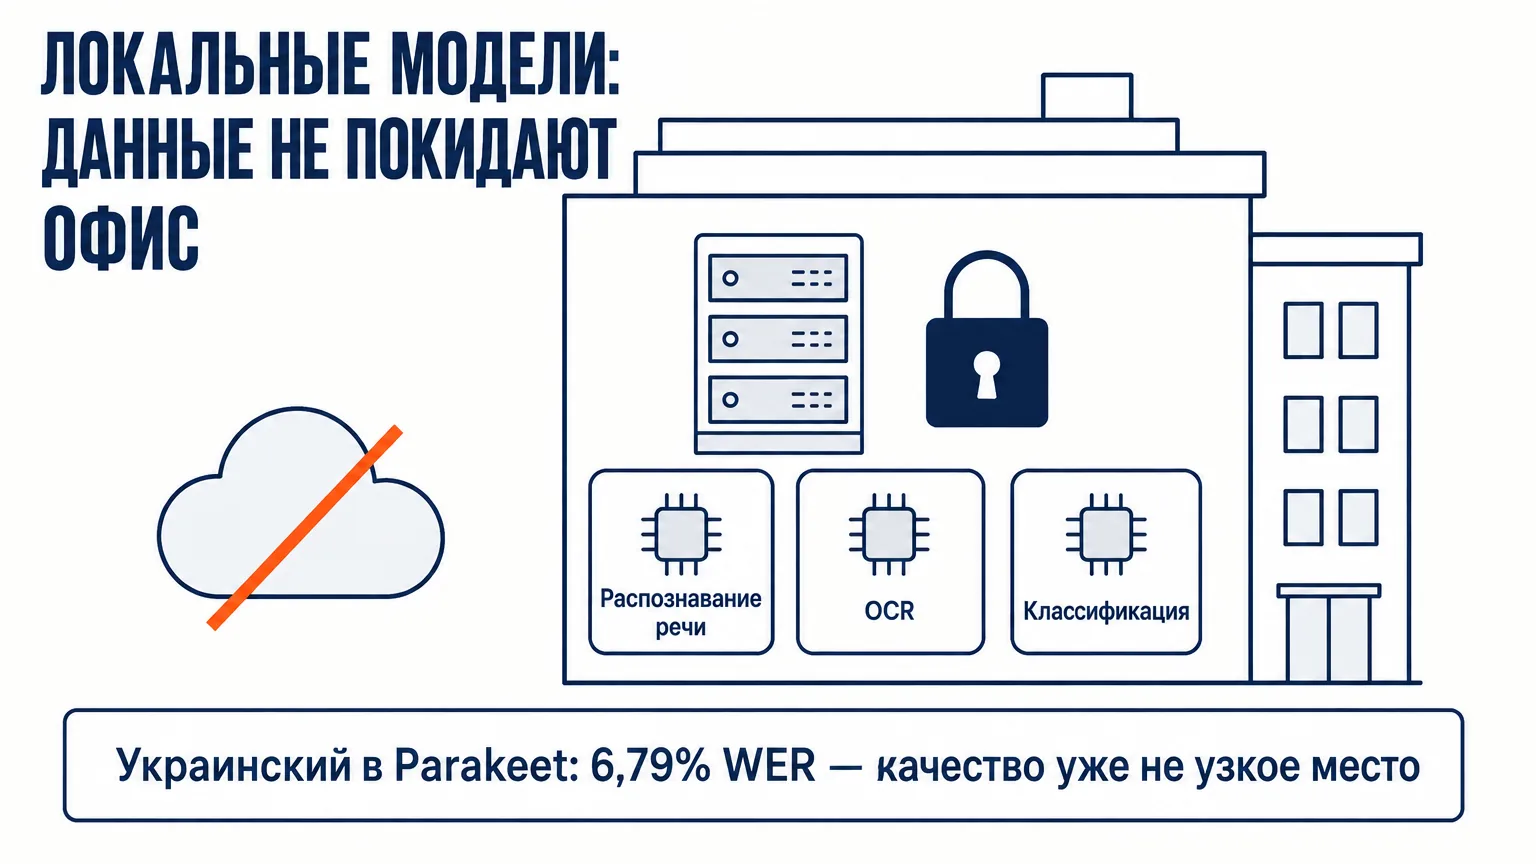
Для распознавания речи, OCR и классификации локальная модель даёт достаточное качество: украинский в Parakeet — 6,79% WER. Но компромисс переехал в рантайм.
Андрей Марьясов, AI-консультант, основатель Auspex и Grow2.ai. Локальная AI-модель — это модель, которая работает на вашем железе, без сетевого вызова к внешнему провайдеру. Для трёх задач — распознавания речи, OCR документов и классификации изображений — она уже даёт качество, достаточное для продакшена: украинский язык в Parakeet-TDT-0.6B-v3 показывает 6,79% WER на Fleurs при среднем по языкам 11,97%. Компромисс при этом никуда не делся. Он просто переехал из качества модели в её эксплуатацию: одна и та же модель на 258 миллионов параметров обрабатывает документ за шесть секунд или за двадцать минут — смотря каким движком вы её запустили.
TL;DR (за 30 секунд)
- Качество уже не узкое место в трёх узких задачах: транскрибация, извлечение данных из документов, классификация изображений. Это не «почти как облако» — это рабочие числа.
- Украинский поддерживается напрямую.
parakeet-tdt-0.6b-v3(NVIDIA, 600M, лицензия CC BY 4.0) распознаёт 25 европейских языков с автоопределением. WER для украинского: 6,79% на Fleurs, 5,10% на CoVoST. - «Средний WER» ничего не говорит о вашем языке. В той же модели словенский даёт 24,03% на Fleurs. Разница с украинским — в 3,5 раза.
- Компромисс переместился в рантайм. Пользователи
granite-docling-258Mсообщают о 15–20 минутах на документ при наивном запуске на CPU, а черезllama-serverс bf16 GGUF другой пользователь обработал свой файл за ~6 секунд. - Юридически исчезает не «риск», а целый класс вопросов. Нет трансграничной передачи — нет главы V GDPR. Нет нового субподрядчика — нет соглашения по статье 28.
- Регуляторная неопределённость продлится дольше, чем планировали. Digital Omnibus — Регламент (ЕС) 2026/1744 — действует с 27 июля 2026 года: обязательства для высокорисковых систем сдвинуты на 2 декабря 2027 и 2 августа 2028.
Шесть секунд или двадцать минут
granite-docling-258M — модель IBM Research для конвертации документов, выпущенная в сентябре 2025 под лицензией Apache 2.0. Двести пятьдесят восемь миллионов параметров. По меркам 2026 года это почти ничего: в сто раз меньше, чем модели, которые вы запускаете через API.
В трекере проекта Docling висит issue №2348, где инженер описывает оценку модели на CPU: генерация вывода для документа занимает пятнадцать-двадцать минут. В обсуждении №37 к карточке модели на Hugging Face другой пользователь жалуется, что даже на RTX 6000 Ada с 48 гигабайтами видеопамяти одна страница обрабатывается недопустимо долго. Ещё один участник ветки добавляет ремарку, от которой становится неловко: модели на несколько миллиардов параметров в LM Studio отдают токены заметно быстрее этой 258-миллионной.
В той же ветке третий участник задаёт правильный вопрос: а что именно вы измеряете? И показывает свой замер на одном файле. Полный пайплайн через докер-UI — около 35 секунд. Та же модель через llama-server с bf16-квантизацией в формате GGUF — 6 секунд. Причём ответ из «простого», непайплайнового вызова оказался точнее.
Одна модель, разные движки, разброс в два порядка.
Вопрос «достаточно ли хороша локальная модель» для целого класса задач уже закрыт. Вопрос «сможете ли вы её нормально эксплуатировать» остаётся открытым, и обжигаются именно на нём.
Три задачи, где локальной модели уже достаточно
Общая черта этих трёх задач: модель ничего не выдумывает, она превращает один вид сигнала в другой — звук в текст, пиксели в структуру, изображение в метку. Это узкие, детерминированные, массовые операции, и именно их маленькие модели вытягивают.
Распознавание речи: украинский внутри
NVIDIA выпустила parakeet-tdt-0.6b-v3 — модель автоматического распознавания речи на 600 миллионов параметров. Предшественница, v2, понимала только английский. Третья версия расширена до 25 европейских языков, и украинский в этом списке есть, рядом с польским, чешским, румынским, литовским.
Числа из карточки модели, WER (процент ошибок по словам, меньше — лучше):
| Язык | Fleurs | CoVoST |
|---|---|---|
| Украинский | 6,79% | 5,10% |
| Русский | 5,51% | 3,00% |
| Португальский | 4,76% | 3,96% |
| Шведский | 15,08% | 20,16% |
| Словенский | 24,03% | 31,80% |
| Среднее по языкам | 11,97% | 11,98% |
У украинского результат заметно лучше среднего. Модель сама определяет язык аудио — подсказывать не нужно. Она расставляет пунктуацию и заглавные буквы, отдаёт таймкоды на уровне слов и сегментов, держит аудио до 24 минут с полным вниманием и до трёх часов с локальным. Лицензия CC BY 4.0 — коммерческое использование разрешено.
Шестьсот миллионов параметров. Это не тот вес, под который покупают сервер.
Обратите внимание на нижние строки таблицы. Словенский в той же модели даёт 24%, почти каждое четвёртое слово. Если ваша аудитория говорит по-словенски, предыдущий абзац к вам не относится: среднее число в карточке модели не описывает ваш язык. Смотрите свою строку.
OCR документов: структура, а не просто текст
Классический OCR отдаёт вам текст и теряет всё остальное — где была таблица, где формула, где подпись под рисунком. Для RAG-пайплайна это потеря, которую потом никак не восстановить.
granite-docling-258M устроен иначе. Под капотом архитектура Idefics3, в которой IBM заменила визуальный энкодер на siglip2-base-patch16-512, а языковую часть — на Granite 165M. Модель сохраняет разметку: таблицы остаются таблицами, формулы формулами, код кодом, а вывод ложится в DoclingDocument — структуру, из которой удобно чанковать для поиска.
Apache 2.0. Можно брать, можно модифицировать, можно ставить внутрь продукта.
И тут же — та самая ловушка с рантаймом, с которой началась статья. Модель маленькая, но это полноценная визуально-языковая модель: она генерирует вывод токен за токеном на каждую страницу. Наивный запуск через transformers на процессоре превращает это в двадцатиминутное ожидание. Тот же файл весов под правильным движком — секунды.
Классификация и зрение: то, что уже у вас в кармане
Apple опубликовала FastVLM — визуально-языковую модель, представленную на CVPR 2025, с открытым репозиторием. Главное в ней — задержка до первого токена, а не точность: FastVLM-0.5B отдаёт первый токен в 85 раз быстрее, чем LLaVA-OneVision, а её визуальный энкодер в 3,4 раза меньше. Старшая FastVLM-7B на Qwen2 — в 7,9 раза быстрее Cambrian-1-8B при сопоставимой точности. Демо работает прямо в браузере через WebGPU.
Восьмого июня 2026 Apple показала третье поколение Apple Foundation Models — пять моделей, от тех, что живут на устройстве, до серверных на Private Cloud Compute. На уровне фреймворка это выглядит буднично: в iOS 26 приложение получает сессию с трёхмиллиардной моделью на устройстве, и сети в пути вызова просто нет.
Это важный сигнал не потому, что Apple сделала что-то уникальное. А потому, что «модель на устройстве» перестала быть исследовательским жанром и стала элементом операционной системы, который каждый пользователь покупает вместе с телефоном.
Где локальная модель ломается
Граница есть, и проходит она в трёх местах.
Язык, которого нет в вашей строке таблицы. Мы уже посмотрели на словенский. Общее правило: качество маленькой модели распределено неравномерно, и это распределение никак не коррелирует с тем, насколько язык важен вам. Перед внедрением возьмите двести минут собственного аудио — не бенчмарк, своё — и измерьте.
Рантайм, который тихо деградирует. 27 марта 2026 года в трекере Docling появился issue №3202, автор которого утверждает: в TableStructureModel зашит безусловный откат с MPS на CPU, из-за чего ускорение на Apple Silicon молча выключается. Его замеры: 145,9 секунды на CPU против 10,4 на MPS и 715,4 секунды против 41,1 после перехода на MLX — ускорение в 14–17 раз. На октябрь 2026 года issue до сих пор открыт.
Меня в этой истории занимает слово «молча». Модель не падает. Логи чистые. Вы просто получаете производительность в пятнадцать раз хуже возможной и списываете это на «ну, локально же медленнее». Это тот же класс проблем, что и с blast radius AI-агента: дороже всего обходится не то, что сломалось громко.
Задачи, где нужно рассуждать. Транскрибация, извлечение, классификация — это преобразование. Генерация текста, многошаговый анализ, длинный контекст, работа с неоднозначностью — это другое. Здесь маленькая локальная модель проигрывает, и проигрывает не чуть-чуть. Не пытайтесь заменить ею тот вызов, в котором вам нужна именно сильная модель.
Какой класс вопросов исчезает
Когда вы отправляете скан паспорта клиента во внешний API, вы совершаете не одно действие, и каждое тянет за собой юридический хвост. Вы передаёте персональные данные обработчику, а значит, вам нужно соглашение об обработке по статье 28 GDPR. Если обработчик за пределами ЕС — включается глава V о трансграничной передаче со всем, что к ней прилагается. Если обработка масштабная или чувствительная — нужна оценка воздействия по статье 35.
Локальная модель не делает вас «соответствующими GDPR». Она делает нечто более узкое и практичное: убирает из уравнения целое слагаемое. Нет передачи — нет главы V. Нет нового субподрядчика — нет ещё одного соглашения по статье 28. Данные клиента не покидают периметр, в котором они и так законно лежали.
Это не юридическая консультация, и ваш юрист всё равно должен посмотреть на конкретную схему. Но «мы уменьшили риск» и «мы убрали основание для вопроса» — разные предложения.
Второй слой — регуляторный. Европейская комиссия опубликовала Digital Omnibus по AI 19 ноября 2025. Европарламент одобрил согласованный текст 17 июня 2026 голосами 423 против 57 при 174 воздержавшихся. Совет ЕС дал финальный зелёный свет 29 июня 2026. Текст опубликован в Официальном журнале 24 июля 2026 как Регламент (ЕС) 2026/1744; в силу он вступил 27 июля 2026.
Что это значит по датам: обязательства для высокорисковых систем из Приложения III сдвинуты на 2 декабря 2027, а для AI, встроенного в регулируемые продукты из Приложения I, — на 2 августа 2028. Изначальным дедлайном было 2 августа 2026.
Сдвиг дедлайнов не означает, что можно расслабиться: он означает, что неопределённость продлится ещё полтора-два года. Архитектура, в которой персональные данные физически не покидают ваш периметр, устойчива к тому, какой именно текст в итоге выйдет в Официальном журнале. Архитектура, построенная вокруг конкретного пункта конкретной редакции регламента, устойчивой не будет.
Сколько это стоит на самом деле
Локальная модель — это не «бесплатно вместо подписки». Вы меняете одну статью расходов на другую: вместо оплаты за токен, которая растёт линейно с объёмом, вы получаете железо, которое покупают один раз, и инженерное время, которое тратят постоянно.
Посчитайте вторую часть полностью: выбрать движок, измерить, а не предположить, заметить, что ускорение тихо выключилось, обновить модель, когда выйдет следующая версия. Это сопровождение, а не разовая работа.
Арифметика склоняется в пользу локального в двух случаях. Первый — объём: когда один и тот же тип документа проходит через систему тысячами в месяц, per-token цена перестаёт быть мелочью. Второй — когда внешняя передача данных либо дорого обходится вам юридически, либо вообще неприемлема для клиента.
Если у вас триста документов в месяц и нет персональных данных — оставайтесь на API. Так будет дешевле и проще. О том, как я вообще решаю, брать ли новый инструмент, есть отдельный разбор.
Правило маршрутизации
Практический вывод, к которому я пришёл, пока строил для клиентов пайплайны извлечения данных из PDF и сканов, звучит так.
Маршрутизируйте не по секретности задачи, а по тому, что именно пересекает периметр.
Сырой документ, живой звук, лицо на фото — остаются внутри. Локальная модель превращает их в производные: текст без имён, вектор признаков, метку класса, структурированную таблицу. Дальше, если для следующего шага действительно нужна сильная модель, наружу уходит уже производная, в которой персональных данных нет.
Распознавание, извлечение, классификация — вниз, на своё железо. Рассуждение, генерация, длинный контекст — наверх, в облако. Граница проходит между преобразованием и мышлением, а вовсе не между «важным» и «неважным».
Три года назад это деление было теоретическим, потому что локальная половина не вытягивала по качеству. Сейчас вытягивает. Платят за это не худшим результатом, а обязанностью разобраться, как оно у вас запускается. Что из локального я держу у себя каждый день, я расписывал в своём AI-стеке.
Шесть секунд или двадцать минут. Разница не в модели.
FAQ
Поддерживают ли локальные AI-модели украинский язык?
Да. Модель parakeet-tdt-0.6b-v3 от NVIDIA распознаёт украинский среди 25 европейских языков с автоматическим определением языка. Показатель WER для украинского — 6,79% на бенчмарке Fleurs и 5,10% на CoVoST, что лучше среднего значения по всем поддерживаемым языкам (11,97% на Fleurs). Лицензия CC BY 4.0 разрешает коммерческое использование.
Означает ли локальная модель соответствие GDPR?
Нет. Локальная модель не делает обработку данных автоматически законной — основание для обработки, минимизация данных и сроки хранения остаются вашей ответственностью. Она снимает отдельные юридические вопросы: если данные не передаются внешнему обработчику, не нужны ни соглашение по статье 28 GDPR, ни механизмы трансграничной передачи из главы V. Конкретную схему должен оценить юрист.
Какое железо нужно для локальной OCR-модели?
Размер модели значит меньше, чем движок. У granite-docling-258M 258 миллионов параметров, но при наивном запуске через transformers на CPU пользователи сообщают о 15–20 минутах на документ, тогда как через llama-server с bf16 GGUF другой пользователь обработал файл за секунды. Перед закупкой железа измерьте свой пайплайн на своих документах.
Когда локальная модель хуже облачной?
В трёх случаях: когда ваш язык плохо представлен в модели (в Parakeet словенский даёт 24,03% WER против 6,79% у украинского); когда задача требует рассуждения, генерации или длинного контекста; когда объём мал и стоимость инженерного времени на сопровождение превышает счёт за API.
Что изменилось в сроках AI Act?
Пакет Digital Omnibus Европарламент одобрил 17 июня 2026, Совет ЕС дал финальный зелёный свет 29 июня, а 24 июля 2026 текст вышел в Официальном журнале как Регламент (ЕС) 2026/1744 и 27 июля вступил в силу. Обязательства для высокорисковых систем из Приложения III перенесены на 2 декабря 2027, для AI в регулируемых продуктах из Приложения I — на 2 августа 2028. Изначальным дедлайном было 2 августа 2026.
Можно ли запустить AI-модель на телефоне?
Да. Apple FastVLM работает на iPhone и даже в браузере через WebGPU, а FastVLM-0.5B отдаёт первый токен в 85 раз быстрее, чем LLaVA-OneVision. С iOS 26 приложения получают доступ к трёхмиллиардной модели на устройстве через фреймворк Foundation Models — сетевого вызова на этом пути нет.
С чего начать переход на локальные модели?
Возьмите одну задачу из трёх — транскрибация, OCR, классификация — и измерьте на собственных данных, а не на бенчмарке. Сначала качество на вашем языке и ваших документах, потом скорость под конкретным движком. Если оба числа устраивают, переносите эту одну задачу, а остальной пайплайн оставьте как есть.
Что дальше
Вопрос «можно ли доверять локальной модели» в 2026 году распадается на два. Достаточно ли она точна на ваших данных — это измеряется за полдня, и чаще всего ответ «да». Сумеете ли вы эксплуатировать её так, чтобы она не работала в двести раз медленнее возможного, — это уже вопрос к вашей команде, а не к модели.
Если в вашей компании сейчас решают, отдавать ли документы клиентов во внешний API, перешлите им этот текст до того, как решение примут. А если пайплайн уже работает и вы не знаете, что именно из него уходит наружу, приходите на discovery-сессию — за час обычно видно, какие данные пересекают периметр и есть ли для этого основание.
Смотрите также:
- Blast radius AI-агента: чем измерять риск вместо токенов — о том, что креденшел определяет масштаб ущерба.
- Как оценить AI-инструмент за 20 минут: мой фреймворк — сначала критерий, потом демо.
- Мой AI-стек 2026: что я реально использую каждый день — что из инструментов реально живёт в ежедневной работе.
- Какие автоматизации внедрять первыми: 5 шагов по порядку — с чего начинать, чтобы было что измерять.
Источники:
- parakeet-tdt-0.6b-v3 — карточка модели NVIDIA: 25 языков, WER по языкам, лицензия CC BY 4.0.
- Docling issue #3202 — откат MPS→CPU в
TableStructureModel, бенчмарки ускорения 14–17×, 27.03.2026. - IBM Granite-Docling: End-to-end document understanding — анонс IBM, сентябрь 2025.
- FastVLM: Efficient Vision Encoding for Vision Language Models — Apple Machine Learning Research, CVPR 2025.
- Introducing the Third Generation of Apple’s Foundation Models — Apple, 8 июня 2026.
- Council gives final green light to simplify and streamline AI rules — Совет ЕС, 29 июня 2026.
- Регламент (ЕС) 2026/1744 (Digital Omnibus on AI) — EUR-Lex, публикация в OJ 24 июля 2026, действует с 27 июля 2026.
Опубликовал Андрей Марьясов, AI-консультант, основатель Auspex и Grow2.ai; внедрения ведут Auspex (CRM) и Grow2.ai (AI-агенты).

Письмо об AI — 2–3 письма в месяц
Личные эссе о том, как AI меняет мышление и работу: что я попробовал сам, что сработало, а что нет. В конце — ссылки на лучшее за последнее время.
Без спама. Отписаться можно в один клик.