llms.txt: почему файл почти не влияет на AI-цитирование
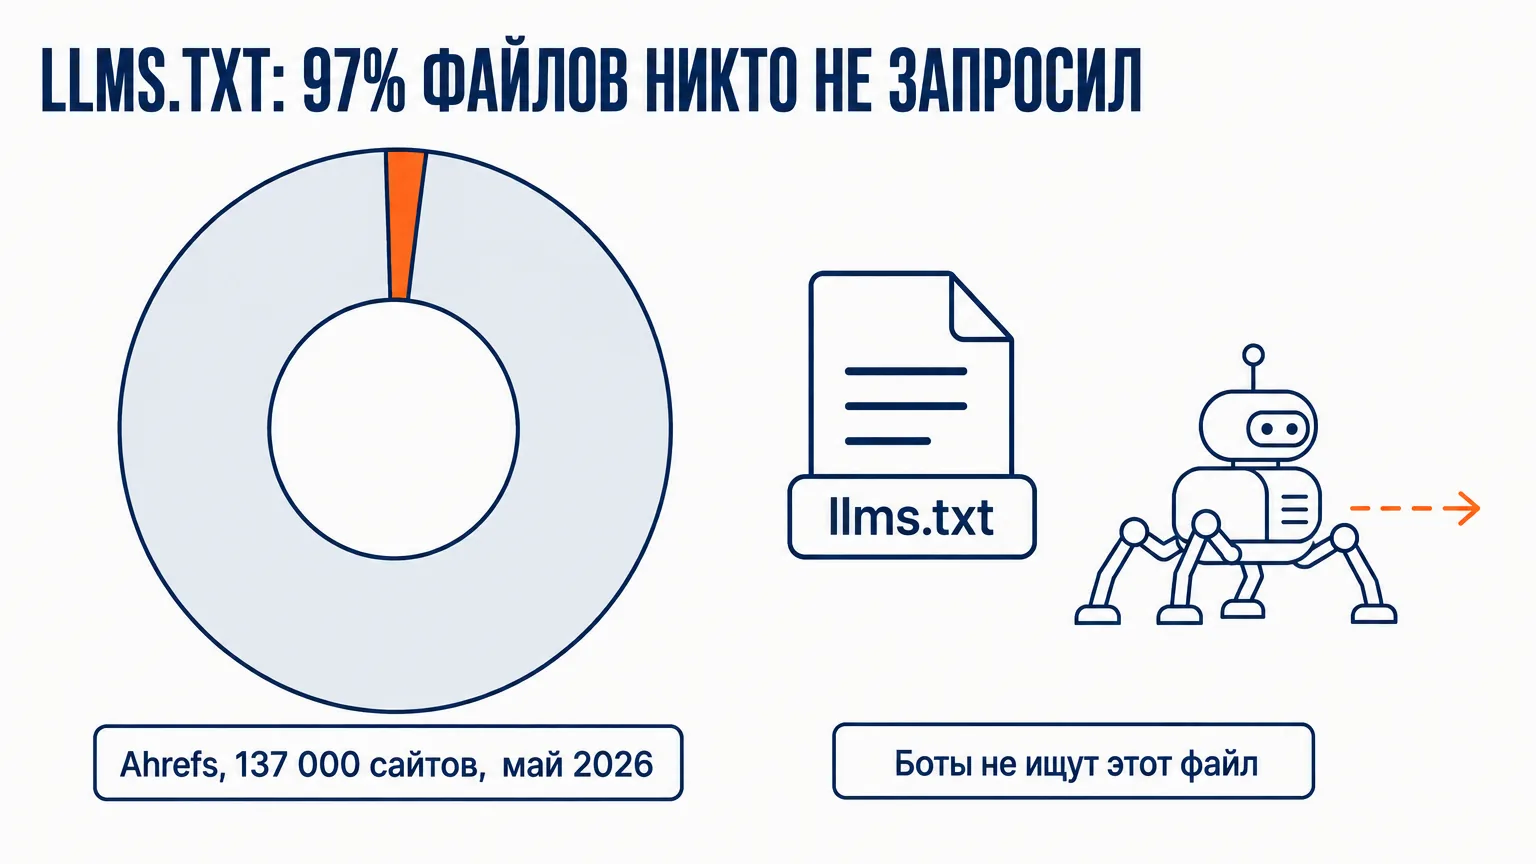
Ahrefs проверил 137 тысяч сайтов: 97% файлов llms.txt не получили ни одного запроса. Google называет файл ненужным. Данные, механизм и собственный опыт.
Андрей Марьясов, AI-консультант. В июне 2026 я поставил
llms.txtна четыре своих сайта — это заняло полчаса. Ahrefs проверил серверные логи 137 тысяч доменов за май 2026 года: 97% таких файлов не получили ни одного запроса. Google в собственном гайде назвал их ненужными для попадания в AI-ответы.llms.txtне делает сайт заметнее для AI, потому что боты его не ищут. Видимость дают доступ краулера, индексация и глубина контента.
TL;DR (за 30 секунд)
- 97% файлов
llms.txtникто не запросил за май 2026 — Ahrefs, выборка 137 000 доменов с серверными логами. - К отсутствующим
llms.txtне пришло вообще ни одного запроса. Боты не ищут этот файл, механизма поиска не существует. - SE Ranking на ~300 000 доменах не нашёл связи между наличием файла и частотой цитирования. Когда переменную убрали из модели, её точность выросла.
- Google за одну неделю занял обе позиции: Search Central в разделе «mythbusting» пишет, что машиночитаемые файлы не нужны, а Lighthouse добавляет аудит
llms.txtв категорию «Agentic Browsing» и включает её по умолчанию. - Среди AI-читателей файла поисковые боты — в хвосте. Список возглавляют обучающий краулер GPTBot и агент разработчика Claude Code; ещё 12% запросов приходит от GEO-инструментов, которые этот самый файл и проверяют.
- Поставить стоит за полчаса, как удобство для агентов, которые уже пришли. Рассчитывать на него не стоит.
Тридцать минут, которые ничего не изменили
13 июня я взялся разложить llms.txt по четырём доменам: auspex.company, grow2.ai, amaryasov.expert и aelo.cloud. Файл простой — markdown-карта сайта для языковых моделей. Заодно добавил Link-заголовок по RFC 8288 с rel="describedby", чтобы бот получал указатель на файл в каждом HTTP-ответе, а не угадывал путь. Аккуратная инженерия, тридцать минут работы.
Перед деплоем решил проверить очевидное: а доходят ли краулеры до моих сайтов вообще. Одна команда:
curl -sI -A "OAI-SearchBot/1.0" https://amaryasov.expert/HTTP/2 403. «Your request was blocked.»
То же самое на GPTBot, ClaudeBot и PerplexityBot. Обычный браузерный user-agent получал спокойные 200. При этом robots.txt пускал всех — я писал его сам и писал гостеприимно. Блокировка сидела уровнем ниже, в Cloudflare: на этом конкретном домене был включён «Block AI bots». На auspex.company и grow2.ai его не было, поэтому я полгода жил в уверенности, что всё в порядке.
То есть мой личный сайт — центр всей entity-стратегии, место, где живёт Person-схема, — был полностью невидим для ChatGPT, Perplexity, Claude и Gemini. А я в этот момент аккуратно клал туда записку для AI.
Исправил в тот же день, за пять минут в дашборде. llms.txt уехал в прод на следующее утро. А потом я месяц читал исследования, которые объяснили, что из этих двух действий значение имело только первое.
Что показывают данные
За последние полгода вышло четыре независимых замера. Они смотрят на разное — на корреляцию с цитированием и на реальные обращения в логах, — но сходятся в одном.
| Исследование | Выборка | Находка |
|---|---|---|
| Ahrefs, июнь 2026 | 137 000 доменов, серверные логи | 97% файлов — ноль запросов за май |
| SE Ranking, конец 2025 | ~300 000 доменов | Значимой связи с цитированием нет |
| Limy.AI, 90-дневный лог | 500+ млн визитов AI-ботов | 408 обращений к llms.txt |
| Otterly.AI, 90-дневный серверный лог | 62 100+ визитов AI-ботов | 84 обращения к файлу (0,1%) |
Детали исследования Ahrefs заслуживают отдельного внимания, потому что это логи обращений, а не опрос и не корреляционная модель.
Файл публикуют 28% доменов выборки. Цифра выше средней по вебу: выборка технически смещена, это пользователи Ahrefs Web Analytics, то есть люди, которые уже занимаются SEO профессионально. Более широкая выборка SE Ranking даёт ближе к 10%.
Из тех 3% файлов, которые вообще кто-то запросил, 19,5% обращений пришли от именованных AI-инструментов. Первый в списке — GPTBot, второй — Claude Code, и оба опережают любого бота AI-поиска или ассистента. Ещё 12% запросов сгенерировали GEO- и AEO-платформы, чекеры llms.txt и исследователи. Индустрия в заметной степени изучает саму себя. Аудит Chrome Lighthouse дал примерно одно обращение из тысячи.
SE Ranking зашёл с другой стороны и проверил статистическую связь между наличием файла и частотой цитирования в AI-ответах. Связи не нашлось ни в регрессии, ни в XGBoost-классификаторе. Более того: когда llms.txt убрали из списка признаков, точность предсказания улучшилась — переменная вносила шум, а не сигнал.
Механизма просто нет
К отсутствующим llms.txt не пришло ни одного запроса. Боты не приходят наугад проверять /llms.txt, как они это делают с /robots.txt или /sitemap.xml.
Здесь и прячется разница, которую маркетинговые рассылки старательно размывают. robots.txt работает, потому что его запрашивают по конвенции, до первой страницы. sitemap.xml работает, потому что на него указывает robots.txt, а поисковые системы договорились его читать. За llms.txt не стоит ни конвенции запроса, ни договорённости вендоров. Никто из крупных — OpenAI, Anthropic, Google, Meta, Mistral — не обязался использовать его как сигнал цитирования.
Файл, который никто не запрашивает, не может повлиять на ответ. Это не «слабый эффект», который проявится на большей выборке. Это отсутствующий канал.
Мой Link-заголовок с rel="describedby" теоретически закрывает именно эту дыру: он говорит боту, где лежит файл, без угадывания. Заголовок стоит на всех четырёх доменах, отдаётся в каждом ответе, и от этого файл никому не стал нужнее. На своих сайтах я держу llms.txt как удобство для агентов, а не как тактику видимости. Правильный ответ на вопрос, который никто не задал, остаётся правильным и ненужным.
Google за неделю занял обе позиции
В мае 2026 Google опубликовал гайд по оптимизации под генеративные AI-функции. В разделе, который буквально называется «mythbusting», написано: машиночитаемые файлы вроде llms.txt не нужны, чтобы появиться в генеративном AI-поиске.
Через несколько дней вышел Lighthouse 13.3 и включил в конфигурацию по умолчанию категорию «Agentic Browsing» — ту самую, куда версией раньше добавили аудит наличия llms.txt.
Это два разных потребителя, а вовсе не путаница. Search-команда описывает retrieval: как система решает, какой сайт подтянуть в ответ. Lighthouse смотрит на агента, который на сайт уже пришёл и должен по нему двигаться.
Джон Мюллер из Google сформулировал это в эпизоде Search Off the Record 15 июня: llms.txt не даёт модели никакого способа решить, какой сайт показать по конкретному запросу. Файл, который сайт пишет о себе сам, не отличает один сайт от другого — кто угодно напишет о себе, что он лучший источник в нише. Ещё в 2025-м Мюллер сравнивал эту конструкцию с мета-тегом keywords, и сравнение точное: незаверенное самоописание, которым легко манипулировать, быстро перестаёт быть сигналом. Роль у файла есть, говорит Мюллер, но узкая, и начинается она после того, как агент уже на сайте.
Кому файл действительно нужен
Из данных Ahrefs следует неожиданно полезный вывод. Читатели у llms.txt есть, просто это не поисковые боты.
Рядом с обучающим краулером OpenAI GPTBot на вершине списка стоит Claude Code — агент разработчика. Как и Cursor, Copilot, агентные браузеры. Такой агент уже стоит на вашем домене и хочет найти описание API, не продираясь сквозь двести килобайт HTML с навигацией, cookie-баннером и футером. Markdown-карта экономит ему шаг.
Отсюда правило, с которым я теперь живу. Если у вас документация больше пятидесяти страниц — ставьте llms.txt и llms-full.txt, у них есть измеримые читатели. Если корпоративный сайт, блог или небольшой магазин — поставьте за полчаса, когда руки свободны, и забудьте; приоритет последний.
Чего не стоит делать вообще: подавать это клиенту как «SEO для AI». Продать легко, доказать невозможно, а через год придётся объяснять, почему ничего не произошло.
Что работает вместо него
Это то, что в любом случае идёт первым, и файлу оно не альтернатива. Порядок — по силе доказательств, а не по модности.
Первое и самое грубое — доступ краулера. Я на нём обжёгся, поэтому ставлю его во главу списка. 403 означает, что вся остальная работа бессмысленна: ни контент, ни schema, ни файлы не существуют для того, кто не прошёл в дверь. Искать блокировку нужно на уровне CDN, а не в robots.txt, потому что живёт она именно там (и, судя по моему случаю, иногда включается сама, вместе с каким-нибудь «рекомендованным» тумблером безопасности).
Второе — SSR или статический HTML. GPTBot, ClaudeBot и PerplexityBot не выполняют JavaScript, так что контент, который дорисовывается на клиенте, для них просто отсутствует.
Третье — индексация. ChatGPT Search берёт кандидатов из поискового индекса; сайт вне индекса не появится в ответе, сколько бы markdown-карт вы ни положили в корень.
Четвёртое — согласованность сущности: одно каноническое имя везде, @id в Organization-схеме, взаимные sameAs на Wikidata и LinkedIn. Здесь я должен притормозить с обещаниями. Schema App в контролируемом исследовании на одиннадцати тестовых страницах получила +46% показов по небрендовым запросам за 85 дней — правда, вместе с sameAs туда добавляли ещё два свойства, так что приписывать эффект одному sameAs нельзя. Ahrefs на выборке 75 тысяч брендов получил корреляцию упоминаний с Google AI Overviews 0,66 против 0,22 у бэклинков. Это корреляции на наблюдательных данных, а не доказанная причинность, и превращать их в обещание клиенту я не советую.
Пятое — глубина контента, единственная часть GEO, у которой есть рецензируемое подтверждение. Princeton GEO paper (KDD 2024) измерял девять тактик: статистика в тексте даёт около +41% к видимости фрагмента, прямые цитаты +37–43%, ссылки на источники примерно +30%. Оговорку авторы записали сами: тестировали на прокси Bing Chat, а эффект измеряли только среди страниц, которые уже были в топ-5. Классическое SEO здесь не «умерло», оно — предпосылка.
Собственные цифры у меня тоже есть, и они ничего не доказывают. 14 июня я прогнал двенадцать промптов через Perplexity: в сумме 10 баллов из 36, коммерческие discovery-запросы дали чистый ноль из семи. Замер сделан на следующий день после деплоя, до какой-либо переиндексации. Это точка А, не результат. Сопоставимого среза тем же методом я с тех пор не снимал. В сентябре измерял иначе — восемнадцать промптов через API Claude, OpenAI и Gemini, по два прогона на каждый, — и категорийные коммерческие запросы снова дали ноль на всех трёх движках. Методики разные, поэтому числа между собой не сравниваю; совпадает только вывод: на коммерческих запросах меня не существует.
Три команды, которые скажут больше, чем llms.txt
Прогоните на своём домене. Займёт минуту.
# 1. Пускает ли CDN AI-краулеров. 403 → остальная работа бесполезна
curl -sI -A "OAI-SearchBot/1.0" https://example.com/ | head -n 1

# 2. Есть ли контент в сыром HTML. Боты не выполняют JavaScript
curl -s -A "GPTBot" https://example.com/ | grep -c "<h1"

# 3. Что на самом деле разрешает robots.txt ботам live-retrieval
curl -s https://example.com/robots.txt
Если первая команда вернула 403 — вы только что нашли причину, по которой вас нет в AI-ответах. Я нашёл её именно так, и мне на это понадобилось полгода.
FAQ
Нужен ли llms.txt, чтобы попасть в AI-ответы?
Нет. Google прямо пишет в разделе «mythbusting» своего гайда, что машиночитаемые файлы для этого не нужны. Ни один крупный AI-вендор не подтвердил, что использует llms.txt как сигнал цитирования.
Вредит ли llms.txt?
Нет, если вы не тратите на него недели. Файл ничего не блокирует и ничего не портит. Вред один: он съедает бюджет внимания, который должен был пойти на доступ краулера и контент.
Почему тогда его ставят крупные компании?
В основном из-за агентов разработчика. Cursor, Claude Code и агентные браузеры читают файл по конвенции своего инструмента. Для сайтов с большой документацией это измеримое удобство, а не поисковая тактика.
Изменится ли это в ближайшее время?
Может. Lighthouse уже проверяет файл в аудите под агентный браузинг. Если агентный трафик вырастет, а вендоры договорятся о конвенции запроса, канал появится. Сегодня его нет.
Чем llms.txt отличается от robots.txt?
robots.txt запрашивают по конвенции, до первой страницы, и он управляет доступом. llms.txt по умолчанию никто не запрашивает, и он ничем не управляет — это самоописание.
Что делать первым, если бюджет на GEO небольшой?
Проверить через curl с AI-user-agent, не отдаёт ли CDN 403. Это стоит ноль и закрывает самую дорогую ошибку.
Сколько стоит поставить llms.txt?
Полчаса. Именно поэтому спор вокруг него такой громкий: цена ошибки низкая в обе стороны, так что обе стороны могут спорить вечно.
Прогоните три команды выше на своём домене. Если первая дала 403 — напишите мне, разберём, где сидит блокировка: в Cloudflare, в WAF или в самом robots.txt.
Похожие разборы: как я оцениваю новый AI-инструмент — о том, как отделять данные от хайпа, и почему я ошибался насчёт цен на AI — о пересмотре собственных утверждений, когда появляются цифры.
Написал Андрей Марьясов, AI-консультант, основатель Auspex и Grow2.ai. Разбираю AI-агентов и автоматизацию для бизнеса — консультации.
Источники:
- Ahrefs: llms.txt study — 137 000 доменов, серверные логи, май 2026
- Ahrefs: brand mentions and AI Overviews — выборка 75 000 брендов, корреляции 0,664 и 0,218
- SE Ranking: llms.txt — ~300 000 доменов
- Limy.AI: llms.txt in 2026 — 90-дневный лог, 500+ млн визитов
- Otterly.AI: the llms.txt experiment — 62 100+ визитов ботов, 84 обращения к файлу
- Search Off the Record, эпизод о Markdown и HTML — 15.06.2026, позиция Джона Мюллера
- Google says llms.txt is comparable to the keywords meta tag — Search Engine Journal, пересказ реплики Мюллера 2025 года
- Lighthouse v13.3.0 release notes — категория «Agentic Browsing» в конфигурации по умолчанию
- Google: AI features and your website — раздел mythbusting
- Schema App: measurable impact of scaling entity linking — +46% показов по небрендовым запросам за 85 дней
- GEO: Generative Engine Optimization — Princeton, KDD 2024

Письмо об AI — 2–3 письма в месяц
Личные эссе о том, как AI меняет мышление и работу: что я попробовал сам, что сработало, а что нет. В конце — ссылки на лучшее за последнее время.
Без спама. Отписаться можно в один клик.