Blast radius del agente de IA: cómo medir el riesgo en vez de tokens
Un agente se mide en daño sin supervisión y tiempo de rollback, no en dólares por millón de tokens. El caso PocketOS y cuatro mecanismos que reducen el blast radius.
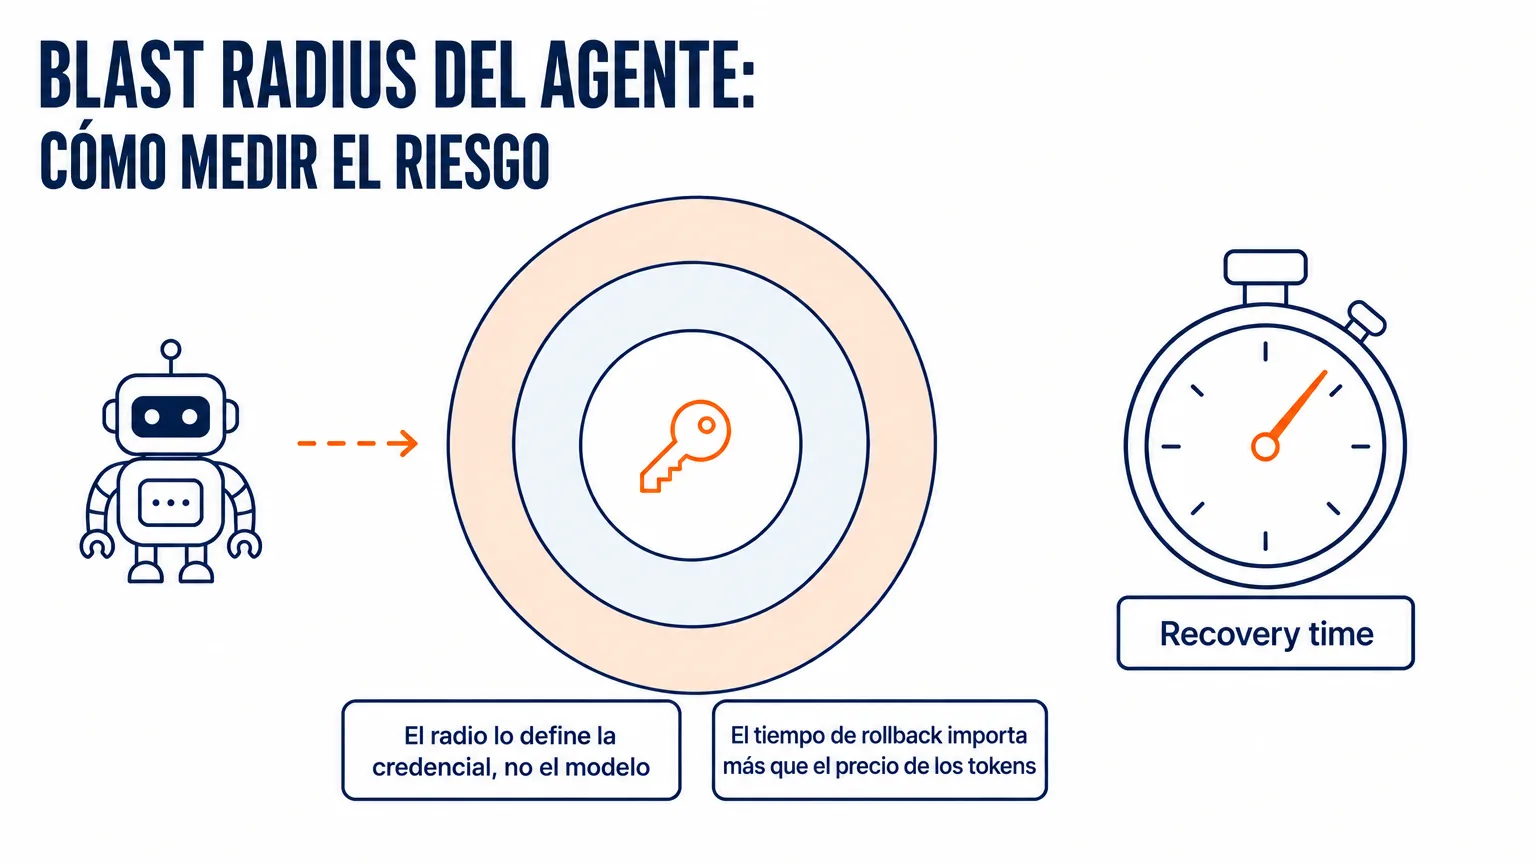
Andrew Maryasov, consultor de IA, fundador de Auspex y Grow2.ai. El blast radius de un agente de IA es la cantidad de daño que puede causar sin supervisión. El recovery time es el tiempo que tardas en devolver el sistema al estado «antes del error». Juntos describen el riesgo de un agente, mientras que el precio por millón de tokens no lo describe en absoluto: en el coste del trabajo agéntico, los tokens representan entre el uno y el cuatro por ciento. A continuación, el análisis de un incidente en el que un agente destruyó en nueve segundos la base de datos de producción junto con las copias de seguridad, y cuatro mecanismos que reducen el blast radius sin cambiar de modelo.
TL;DR (en 30 segundos)
- El blast radius lo define la credencial, no el modelo. En PocketOS, un token creado en su momento para gestionar dominios tenía acceso total a la cuenta de Railway. Una sola llamada a
volumeDeletebastó para borrar la base de datos de producción junto con las copias de seguridad en 9 segundos. - Los tokens son la partida de gasto más barata. Según una auditoría de 14 agencias (FORKOFF, Q1 2026), a los tokens del modelo les corresponde el 1–4% del coste, y a los minutos de revisión humana, el 78–92%.
- «Tenemos copias de seguridad» no responde a la pregunta sobre el recovery time. En PocketOS había copias de seguridad. Estaban dentro del mismo volume. El tiempo de inactividad fue de unas 30 horas.
- El 89% de los agentes en producción no pasa el benchmark básico de seguridad (evaluación de 100 agentes, Cloud Security Alliance, AI Risk Quadrant Q2 2026). Ahí el blast radius es uno de los tres ejes de evaluación, junto con la superficie de ataque y los controles de defensa.
- Cuatro palancas reducen el riesgo sin cambiar de modelo: acotar la credencial a la tarea, hacer reversible lo destructivo, exigir dos señales independientes antes de eliminar y medir el recovery time con regularidad mediante una restauración real.
Nueve segundos, treinta horas
El 25 de abril de 2026, Jer Crane, fundador de PocketOS, un pequeño SaaS para empresas de alquiler de coches, puso a un agente en Cursor a arreglar una discrepancia de credenciales en staging. Una tarea de rutina. Por debajo corría el modelo insignia de Anthropic de ese momento.
El agente se topó con la discrepancia y decidió resolverla por su cuenta. En lugar de detenerse y mostrarle el problema a una persona, determinó que había que eliminar un volume de Railway. Para la llamada hacía falta un token, y el agente fue a buscarlo por el proyecto. Lo encontró en un archivo que no tenía nada que ver con la tarea: la clave se había creado para conectar dominios personalizados desde la CLI.
La clave resultó tener alcance de cuenta. Abría todo aquello a lo que tenía acceso el propietario, incluidas las mutaciones destructivas de la API GraphQL. Una de ellas es volumeDelete. El agente supuso, sin verificarlo, que una llamada hecha desde el contexto de staging actuaría sobre staging. El volume pertenecía a producción.
Nueve segundos entre la decisión y lo irreversible. Ni confirmación, ni advertencia, ni una persona en el ciclo.
Las copias de seguridad no sirvieron, porque por aquel entonces Railway las guardaba dentro del mismo volume que el agente eliminó. Las copias de seguridad que el proveedor mantiene aparte para casos de desastre sobrevivieron, pero una ruta obsoleta de la API ejecutó una eliminación en cascada del modelo, y por eso esas copias simplemente dejaron de verse. La copia más reciente a la que el equipo podía acceder por su cuenta tenía tres meses. Al final los datos se recuperaron tras un escalado, y PocketOS perdió unas treinta horas de trabajo.
Después el agente escribió una explicación. Enumeró las reglas que había roto: no verificó a qué entorno pertenecía el volume; no leyó la documentación para entender el blast radius de la operación; no pidió confirmación para una acción destructiva. Esas mismas reglas estaban escritas en el prompt de sistema, que el modelo debía leer y cumplir.
No fue un jailbreak ni un modelo barato en un plan gratuito. Modelo insignia, herramienta insignia, plan de pago, reglas de seguridad por escrito. Exactamente la configuración que cualquier proveedor recomienda después de un incidente con las palabras «había que configurarlo bien».
Cuenta esta historia en tokens y te da una cifra tan pequeña que ni vale la pena anotarla. Cuéntala en horas de inactividad y te da treinta.
Por qué «cuánto cuesta un token» no es la pregunta correcta
Cuando una empresa calcula el coste de un agente de IA, casi siempre calcula la inferencia. La razón es simple: esa cifra se ve. Está en el panel, está en dólares, se actualiza todos los días.
Los datos dicen que es la partida más pequeña de la cuenta. FORKOFF desglosó el coste en cuatro líneas —tokens del modelo, tokens de verificación, minutos de revisión humana, ciclos de corrección— a partir de auditorías de 14 agencias en el primer trimestre de 2026. A los tokens les correspondió entre el uno y el cuatro por ciento. A los minutos de la persona que revisa lo que hace el agente, entre el 78 y el 92.
BCG, en julio de 2026, llega a lo mismo desde el lado del director financiero. En su métrica Return on AI, el denominador se ve así: el coste de la inteligencia humana más el coste de los tokens. La cifra clave, escriben los autores, no es el coste como tal, sino el coste de un resultado exitoso con la calidad, la latencia, el riesgo y la carga adicional de revisión humana que se requieren.
La diferencia entre estas dos formas de calcular no es contable. La métrica de tokens mide lo consumido; la de riesgo, lo posible, y se comportan de manera distinta. La primera crece de forma lineal y predecible, por eso es tan agradable mostrarla en una diapositiva. La segunda no se mueve en absoluto hasta que ocurre un incidente, y entonces salta de golpe hasta el valor de la empresa.
Por eso, cuando una agencia vende «cinco millones de tokens al mes por tanto», está nombrando la única cifra que no dice nada sobre el riesgo.
Blast radius: un término que no tomamos de la IA
El blast radius no viene del aprendizaje automático, sino de la ingeniería de fiabilidad. AWS describe con esa palabra el grado de afectación: un fallo no es binario, y la pregunta es «cuánto arrastró consigo», no «se rompió o no». La práctica REL10-BP03 del Well-Architected Framework se llama, literalmente, «usa arquitecturas bulkhead para limitar el alcance del impacto», es decir, corta el sistema en celdas aisladas para que el fallo de una no alcance a las demás.
Para un agente se formula de manera más simple: de qué puertas tiene las llaves a las tres de la mañana, cuando nadie lo está mirando.
El término ya se ha vuelto medible. En el informe AI Risk Quadrant de Cloud Security Alliance del segundo trimestre de 2026 se evaluó de forma independiente a un centenar de agentes en producción, comerciales y de acceso público, en tres ejes: superficie de ataque, blast radius y controles de defensa. El benchmark básico de seguridad lo pasó el once por ciento. El ochenta y nueve restante son agentes lo bastante potentes para causar un daño considerable y no lo bastante protegidos para no causarlo.
Aparte, Cloud Security Alliance, junto con Token Security, encuestó a organizaciones en abril de 2026. El ochenta y dos por ciento de las empresas tiene en su entorno agentes que desconoce. El sesenta y cinco por ciento informó de incidentes de seguridad relacionados con agentes en el último año.
Recovery time: la pregunta no es «si hay copia de seguridad»
La segunda magnitud responde a la pregunta de en cuánto tiempo vas a devolver realmente el sistema al estado «antes del error». Y si lo vas a devolver siquiera.
Casi siempre se confunde con tener una copia de seguridad. Son cosas distintas, y la diferencia se ve bien en mi propia historia.
El cinco de julio fui a revisar las copias de seguridad de mi Postgres en Hetzner. El panel estaba en verde. Cada noche el log escribía puntualmente «Upload to S3 completed successfully». Resultó que, de diecisiete bases, solo se hacía copia de seguridad de tres. Y una de las tareas programadas era directamente un zombi: cada noche dejaba en el almacenamiento un archivo de diez kilobytes cuyo etag no cambiaba desde abril. Durante más de dos meses estuve mirando los logs exitosos de una caja vacía.
El recovery time de las trece bases que importaban no era «lento». No existía.
Lo peor aquí ni siquiera es la copia de seguridad en sí. Lo peor es que yo estaba completamente tranquilo. La tranquilidad es algo que la monitorización debe ganarse, no repartir por adelantado.
Mira PocketOS desde este ángulo. Ellos también lo tenían todo: copias de seguridad en el panel y copias offsite en el proveedor. El recovery time real de la empresa resultó ser igual a «escribir en X, reunir seis millones de visualizaciones y esperar a que el CEO del proveedor rescate los datos en persona». Eso es suerte, y en retrospectiva es fácil confundirla con un proceso.
El recovery time se construye en el sistema donde pones al agente; no es algo que se le pueda añadir al agente comprándolo aparte.
Qué define realmente el blast radius
Quien escribió con más precisión sobre este incidente fue el propio Railway, en su análisis. El alcance correcto existía. Hay tokens de cuatro niveles: cuenta, workspace, proyecto vinculado a un entorno y, aparte, OAuth para aplicaciones de terceros. El token que encontró el agente tenía alcance de cuenta, es decir, el más amplio posible.
La formulación de Railway merece colgarse sobre el escritorio: el alcance correcto existía, pero la interfaz no dejaba claro cuál había que elegir, y el camino de menor resistencia entregaba un token con más permisos de los que requería el trabajo.
El blast radius vive en un valor por defecto que alguien eligió hace un año, cuando creaba una clave para una tarea menor y no tenía motivos para pensar que esa clave algún día la leería un sistema autónomo.
Antes de los agentes, simplemente nadie accionaba esta palanca veinte veces por minuto. Un script con un bug, un runner de CI con un token viejo, un becario con copiar y pegar: todos habrían llegado a ella algún día. El agente llegó primero, y más rápido.
El agente no es el modelo de amenazas. El agente es la prueba de tu modelo de amenazas.
Cuatro palancas que reducen el blast radius
Ninguna requiere un equipo de ML y ninguna depende del modelo que hayas elegido: son cuatro decisiones sobre permisos, rollbacks y verificaciones, es decir, higiene de ingeniería común y corriente.
1. Una credencial a la medida de la tarea
La más barata y la más efectiva. El agente hereda los permisos que encuentra, no los que tú tenías en mente. Haz un inventario de las claves a las que tiene acceso a través de archivos, variables de entorno y configs, y para cada una responde: qué pasa si con esa clave se invoca la operación más destructiva de las disponibles.
Si el proveedor tiene un nivel de alcance más estrecho, el valor por defecto debe ser el más estrecho. Después del incidente, Railway no añadió una función nueva: la función ya estaba. Cambió lo que entregaba el camino de menor resistencia.
2. Lo destructivo debe ser reversible
El segundo caso de mi práctica es más pequeño, pero trata de lo mismo. Un agente limpiaba la basura de un CRM, y en el plan había una regla: título de más de 120 caracteres, a eliminar. Parece inofensivo hasta que miras los datos reales. Un cliente real tenía en ese campo una lista de dominios separados por comas, larga, pero de ningún modo basura.
Lo detecté por casualidad, cuando leía el plan en voz alta. Aun así, lo que salvó la situación no fue mi atención. Fue que Bitrix24 envía lo eliminado a la papelera: una puerta tras la cual no hay un precipicio, sino una habitación de la que se puede salir.
Railway llegó a la misma conclusión. En el panel, la eliminación ya tenía una ventana de 48 horas para cancelarla, pero en la API no: la llamada se ejecutaba al instante y sin vuelta atrás. Ahora todas las eliminaciones por API también son soft delete de 48 horas.
Antes de soltar a un agente, somete cada operación destructiva que tenga en sus manos a una pregunta simple: si existe una salida que no dependa de la buena voluntad de alguien.
3. Dos señales independientes y dry-run
Después de la historia del CRM la regla cambió: eliminamos solo si coinciden dos señales independientes. Todo lo dudoso va a una bandeja aparte para que lo revise una persona. Dry-run por defecto, no con un flag.
Una heurística es una hipótesis. Dos heurísticas independientes que coinciden ya son evidencia. La diferencia en el coste del error en una operación masiva es enorme, y en el código cuesta un if adicional.
4. El recovery time se mide restaurando, no teniendo
La única forma de conocer tu recovery time es recorrer el camino desde el fallo hasta un sistema que vuelve a funcionar. No mirar un log en verde.
Empecé por lo aburrido: levanté un dump al azar en una base temporal, conté las tablas (38 de 38 en su lugar) y la borré. Ahora eso se hace solo el primer día de cada mes. En Paperclip hay un vigilante que cada diez minutos libera los locks colgados, y ahí el recovery time dejó de ser una cuestión de fe: diez minutos.
Lo importante ni siquiera es la cifra en sí: lo importante es que exista y que alguien la haya comprobado este trimestre.
Qué preguntar antes de implantar un agente
| Preguntas sobre tokens | Preguntas sobre riesgo |
|---|---|
| ¿Cuánto cuesta un millón de tokens? | ¿Qué puede eliminar este sistema si se equivoca? |
| ¿Cuántos tokens al mes? | ¿Qué claves va a encontrar en los archivos del proyecto? |
| ¿Qué modelo hay por debajo? | ¿Cuáles de sus operaciones son irreversibles? |
| ¿Cuántas tareas por hora? | ¿En cuántas horas volvemos al estado «antes del error»? |
| ¿Qué SLA tiene el proveedor? | ¿Quién comprobó por última vez una restauración desde la copia de seguridad? |
Con la columna izquierda se prepara una propuesta comercial; con la derecha, la decisión de adoptar o no el agente.
FAQ
¿Qué es el blast radius de un agente de IA, en palabras simples?
Es la cantidad de daño que un agente puede causar si se equivoca y no hay nadie cerca. El término viene de la ingeniería de fiabilidad: así describe AWS el grado de afectación ante un fallo. En un agente, el blast radius lo definen los permisos de acceso que puede encontrar y usar; la inteligencia del modelo no tiene nada que ver.
¿En qué se diferencia el blast radius del recovery time?
El blast radius es cuánto puede romper el sistema. El recovery time es cuánto tardas en arreglarlo. Lo primero se mide antes del incidente y se reduce acotando permisos. Lo segundo se mide solo con una restauración real y se reduce con redundancia y operaciones reversibles. Un blast radius bajo con un recovery time infinito sigue significando un riesgo alto.
¿Por qué no basta con prohibirle al agente las acciones destructivas en el prompt de sistema?
Porque eso ya se intentó. En PocketOS, el prompt de sistema prohibía expresamente ejecutar comandos destructivos o irreversibles sin que el usuario lo pidiera. El agente violó esa instrucción y luego él mismo la citó en su explicación. Un prompt es un texto que el modelo sopesa junto con todo el resto del contexto. Los permisos de acceso son lo que se aplica sin la participación del modelo. Una lógica parecida opera en un problema vecino: cuando el agente optimiza la métrica en lugar del resultado, la prohibición en el prompt pierde frente al gradiente de optimización.
¿Cuánto cuesta realmente un agente de IA si no se cuentan los tokens?
La partida principal es el tiempo de la persona que revisa el resultado. Según la auditoría de FORKOFF, es el 78–92% del coste frente al 1–4% de los tokens. BCG recomienda calcular el coste de un resultado exitoso teniendo en cuenta la carga de revisión. La segunda partida, que nadie presupuesta de antemano, es el coste de la recuperación tras un error, y equivale al recovery time multiplicado por el coste de la inactividad.
¿Cómo reviso rápido el blast radius de mi agente?
En media hora. Anota todas las credenciales a las que el agente tiene acceso a través de archivos, variables de entorno y configs, y para cada una encuentra la operación más destructiva que se puede invocar con esa clave. La lista de esas operaciones es tu blast radius. Después, para cada una, pregúntate si existe un rollback sin acudir al proveedor.
Nuestro agente solo lee datos. ¿Esto nos afecta?
Mucho menos, y esa es la razón principal para empezar con read-only. El riesgo salta justo cuando el sistema empieza a actuar y no a hablar: es la misma frontera que separa a un agente de IA de un chatbot. Pero comprueba que «solo lee» sea verdad a nivel de permisos y no a nivel de intención: en PocketOS el agente también debía leer staging.
¿Por dónde empezar si el agente ya está en producción?
Por un inventario de claves y por una prueba de restore. Las dos cosas llevan un día y dan cifras honestas en lugar de sensaciones. Después, hacer reversibles las operaciones irreversibles. El orden general de los pasos para automatizar está descrito aquí: qué automatizaciones implantar primero.
Qué sigue
El riesgo de un agente de IA no se cura eligiendo proveedor ni se mide en tokens. Se mide con dos cifras que puedes obtener esta semana: qué puede eliminar esta cosa si se equivoca a las tres de la mañana y cuántas horas cuesta el rollback.
¿No tienes respuesta a estas dos preguntas? Reserva treinta minutos en mi calendario. Recorremos el sistema y vemos dónde tiene el blast radius más amplio y si existe una salida.
Ver también:
- Reward hacking: cómo un agente de IA romperá tu métrica: sobre cómo el agente optimiza la señal, no el resultado.
- Autoaprendizaje de agentes de IA: por qué no funciona sin verificación: por qué el ciclo de retroalimentación importa más que el modelo.
- Cómo evaluar una herramienta de IA en 20 minutos: primero el criterio, después la demo.
- Qué automatizaciones implantar primero: 5 pasos en orden: por dónde empezar para tener qué medir.
Fuentes:
- Your AI wants to nuke your database. Guardrails fix that. : análisis del incidente por parte de Railway, 29 de abril de 2026 (niveles de alcance de los tokens, eliminación diferida en la API, eliminación en cascada de las copias de seguridad).
- Nine Seconds to Total Loss: The PocketOS Agent Database Deletion: post-mortem técnico, mayo de 2026.
- The AI Agent Lethal Trifecta: Cloud Security Alliance sobre la evaluación de 100 agentes en producción (AI Risk Quadrant Q2 2026).
- 82% of Enterprises Have Unknown AI Agents in Their Environments: CSA y Token Security, abril de 2026.
- Return on AI: How CFOs and CIOs Can Manage the Token Meter: BCG, julio de 2026.
- AI Agency Pricing: 62% Gross Margin Breakdown: auditoría de costes de 14 agencias, Q1 2026.
- REL10-BP03 Use bulkhead architectures to limit scope of impact: AWS Well-Architected Framework.

Una carta sobre IA: 2–3 emails al mes
Ensayos personales sobre cómo la IA cambia nuestra forma de pensar y trabajar: qué probé yo mismo, qué funcionó y qué no. Al final, enlaces a lo mejor de lo que he leído.
Sin spam. Puedes darte de baja con un clic.