Por qué se equivoca un agente de IA: falla la búsqueda, no el modelo
Stanford y Together AI probaron seis chatbots con 2100 preguntas: más del 70% de los errores son de búsqueda, no de razonamiento. Qué implica para tu pipeline RAG.
Andrew Maryasov, consultor de IA, fundador de Auspex y Grow2.ai. Cuando un agente da una respuesta incorrecta, la primera reacción de la empresa es pasarse a un modelo más inteligente. Un estudio de Stanford y Together AI con 2100 preguntas mostró otra cosa: más del 70% de los errores surgen en el paso de búsqueda, no en el de razonamiento. Cuando el modelo encuentra la fuente correcta, casi siempre extrae bien el dato. Toda la dificultad está en llegar siquiera al documento indicado.
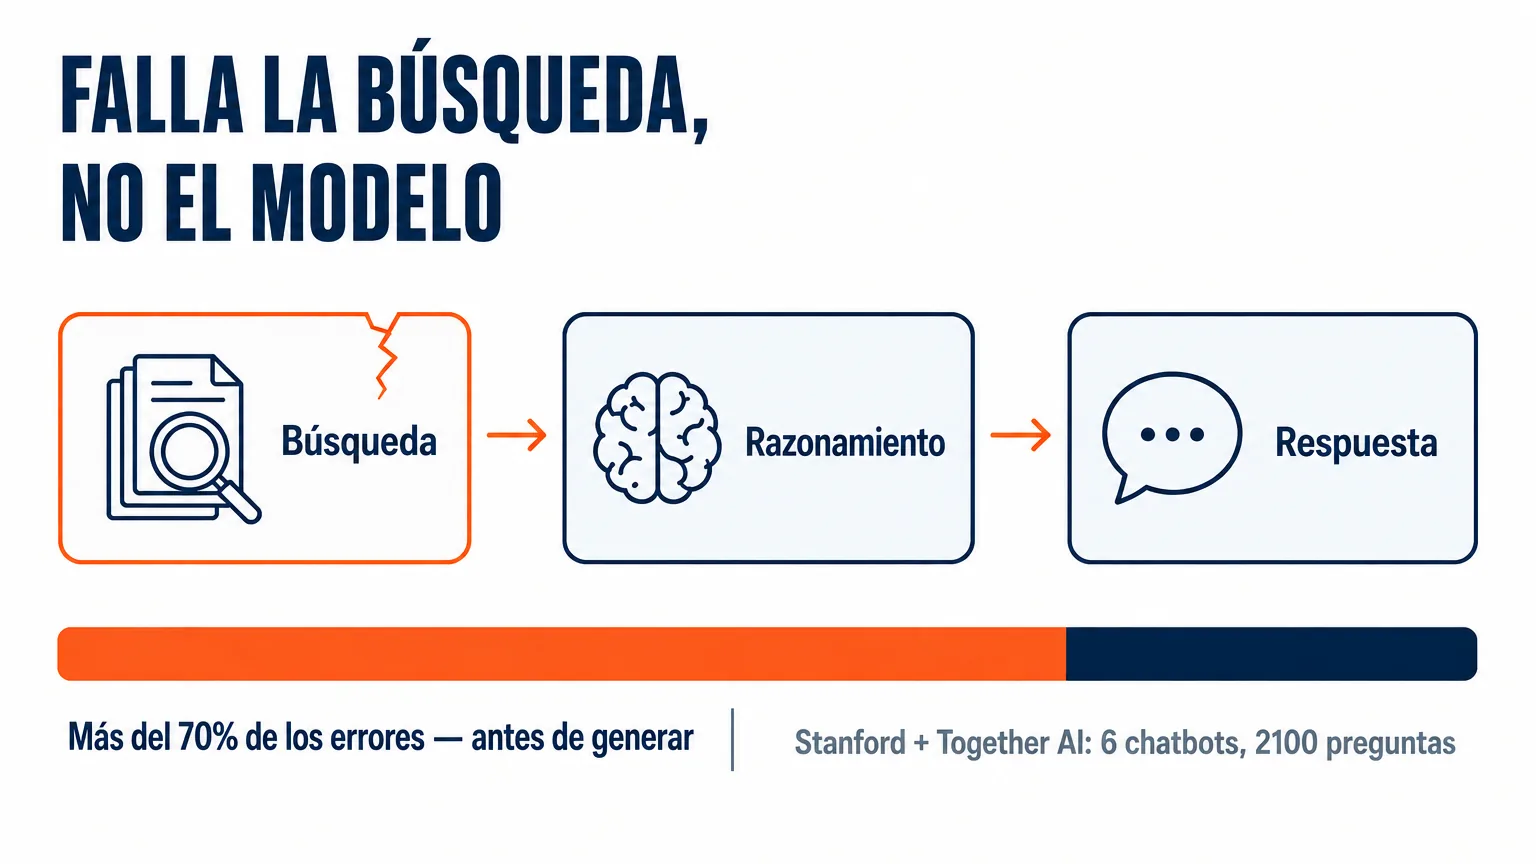
De entrada, dos términos que aparecen a menudo más abajo. Retrieval es el paso en el que el sistema busca documentos y se los entrega al agente antes de que este empiece a responder. RAG es toda la construcción «primero busca en la base, después responde con lo que encontraste».
TL;DR (en 30 segundos)
- El error del agente ocurre la mayoría de las veces antes de la generación. Al agente le trajeron el documento equivocado y trabajó sobre él con toda diligencia.
- Stanford y Together AI pasaron seis chatbots comerciales por 2100 preguntas sobre noticias recientes de la BBC durante 14 días. La formulación de los autores: el retrieval, y no el reasoning, origina más del 70% de todos los errores.
- Desglose de causas: fallo de búsqueda, 38,8%; lo encontrado era «del mismo tema, pero no de eso», 32,7%.
- Los mejores sistemas superan el 90% en preguntas con opciones de respuesta. En formato libre la precisión cae 11–13 puntos porcentuales, y en toda la cohorte, 16–17.
- La precisión más baja se da en hindi: según el estudio, un 79% de media frente al 89–91% en los demás idiomas, con el mismo formato de opciones. La causa no está en la capacidad lingüística del modelo, sino en el sesgo del índice: ante consultas en hindi, los modelos citan la Wikipedia en inglés más que cualquier medio informativo en hindi.
- Basta con colar una premisa falsa en la consulta para que la precisión, según el mismo trabajo, caiga del 88–96% al 19–70%, incluso cuando al sistema se le permitía expresamente responder «información insuficiente». El modelo más vulnerable dio por cierto el dato inventado en el 64% de los casos.
- Conclusión práctica: antes de pagar por un modelo más caro, gasta ese mismo presupuesto en la búsqueda. Rinde más.
2100 preguntas, seis chatbots, catorce días
En mayo de 2026, el grupo de Mirac Suzgun en Stanford, junto con Together AI, publicó el trabajo «Evaluating Commercial AI Chatbots as News Intermediaries» (arXiv:2605.22785). En julio lo analizó The Batch bajo el título Web Retrieval Flusters LLMs.
El diseño es simple y transparente. Durante catorce días seguidos, del 9 al 22 de febrero de 2026, los autores tomaron noticias recientes de BBC News de seis servicios regionales y generaron a partir de ellas preguntas sobre hechos ocurridos apenas unas horas antes. Salieron 2100 preguntas. Después, seis chatbots con la búsqueda web activada intentaron responderlas; la cohorte del estudio fue esta: Gemini 3 Flash y Pro, Grok 4, Claude 4.5 Sonnet, GPT‑5 y GPT‑4o mini.
La prueba con noticias recientes cierra el principal resquicio. El modelo no podía conocer la respuesta por sus datos de entrenamiento: el hecho ocurrió después del entrenamiento. El único camino a la respuesta correcta es encontrar la noticia indicada y extraer de ella el dato. Es exactamente la configuración en la que trabaja cualquier agente tuyo sobre datos corporativos, solo que en lugar de la BBC ahí está tu base de contratos.
El primer resultado parece tranquilizador. En las preguntas con cinco opciones de respuesta, los resultados del estudio son estos: Gemini 3 Flash obtuvo un 95,6%; Grok 4, un 95,0%; Gemini 3 Pro, un 93,7%; Claude 4.5 Sonnet, un 90,4%. GPT‑5 llegó al 85% y GPT‑4o mini, al 69%.
Pero después los autores quitaron las opciones y pidieron responder con palabras propias. Los mejores sistemas perdieron 11–13 puntos porcentuales; en toda la cohorte la caída fue de 16–17. Es decir, una parte notable de esos «noventa y tantos por ciento» se sostenía en adivinar la opción correcta de la lista: más o menos lo que hace un estudiante en un examen cuando se sabe la materia a medias.
La cifra principal: más del 70% de los errores son de búsqueda
Luego los autores clasificaron las causas de las respuestas incorrectas. Cada fallo se analizó por categorías: no encontró, encontró otra cosa, no entendió, confundió la cronología.
La formulación del resumen del artículo dice así: el retrieval, y no el reasoning, origina más del 70% de todos los errores. Cuando el modelo logra dar con la fuente correcta, en la gran mayoría de los casos extrae bien la respuesta. Toda la dificultad está en llegar siquiera a la fuente indicada.
The Batch ofrece el desglose de las dos categorías más grandes:
| Causa del error | Proporción |
|---|---|
| Fallo de búsqueda: el material necesario no se encontró en absoluto | 38,8% |
| Se encontró una fuente sobre el tema, pero con otros detalles: no responde a la pregunta concreta | 32,7% |
| El resto de las causas en conjunto: comprensión, cronología, etc. (por resta; la fuente no lo da por separado) | ~28,5% |
La segunda categoría no es «no encontró nada». Es «encontró algo razonable y relevante, pero no lo que hacía falta». Los autores llaman a las respuestas construidas a partir de esas fuentes «smart wrong»: inteligentes, pero equivocadas. Desde fuera la respuesta parece fundamentada: el agente cita un documento real, el documento sí trata del tema, sí contiene cifras. Solo que las cifras corresponden a otro período, a otra región o a otro objeto.
Justamente esta categoría es la más cara para un negocio, porque no parece un error. Una respuesta vacía la detecta cualquier control; en cambio, una respuesta segura con un enlace vivo al documento equivocado pasa ante los ojos de una persona sin encontrar resistencia.
Por qué «pasémonos a un modelo más inteligente» no funciona
La reacción estándar ante un error del agente: el modelo es tonto, subamos al siguiente. Los datos del artículo dicen que ese dinero, en su mayor parte, pasará de largo sin tocar el problema.
La lógica aquí es casi aritmética. La respuesta del agente a una pregunta que no estaba en sus datos de entrenamiento se sostiene en tres pasos: recibir una pregunta bien formulada, encontrar un documento relevante, extraer de él el dato. El modelo se encarga del tercer paso y, un poco, del primero. Más del 70% de los errores están en el segundo.
Subir de modelo mejora lo que ya funciona al 90+ por ciento y no toca lo que se rompe.
Los autores sacan de ahí una conclusión directa: mejorar la búsqueda probablemente dará un mayor salto de calidad que aumentar los parámetros del modelo, al menos allí donde las consultas se refieren a información actual. Las tres direcciones que mencionan: cobertura del índice (qué documentos entran siquiera en la búsqueda), ranking de las fuentes (en qué orden queda lo encontrado ante el modelo) y manejo de consultas en idiomas distintos del inglés.
El caso del hindi es ilustrativo. En las mismas preguntas con opciones de respuesta, cada modelo mostró su peor precisión justamente en hindi: según el mismo trabajo, un 79% de media frente al 89–91% en los demás idiomas. Y al responder consultas en hindi, los modelos citaron la Wikipedia en inglés más que cualquier medio informativo en hindi. No es que «el modelo sepa menos hindi». Es un índice construido por el mundo angloparlante para el mundo angloparlante, y una búsqueda que, ante una consulta que no está en inglés, se desliza hacia una fuente en inglés. Exactamente la misma mecánica se activará en tu propia base de documentos en español o en cualquier otro idioma que no sea el inglés si el modelo vectorial y el stack de búsqueda están configurados por defecto.
Cinco formas de llevarle al agente el documento equivocado
A continuación, los modos de fallo que veo con regularidad en pipelines en producción. El primero y el quinto encajan directamente en las categorías del estudio; los otros tres vienen de la práctica de construir sistemas de retrieval.
1. Encontró algo relevante, pero no lo necesario
Es la misma categoría del 32,7%. El agente busca la cláusula del contrato sobre plazos de pago, y el índice devuelve la página general de la sección «Condiciones de colaboración». El tema coincide, lo concreto no está. O se preguntó por un material y apareció el perfil de su autor: las palabras son las mismas, el objeto es otro.
El mecanismo es simple: la relevancia para el tema y la relevancia para la pregunta son cosas distintas, y la mayoría de las configuraciones de búsqueda optimizan por defecto la primera.
2. Entidad confundida
Un mismo nombre puede ser a la vez una empresa, un producto y un proyecto. El agente obtiene datos absolutamente correctos, solo que sobre otro objeto. Dentro de un mismo cliente esto pasa constantemente: un plan y un servicio del mismo nombre, la persona jurídica y la marca, el nombre del proyecto y el nombre de la carpeta.
Este error es el más difícil de detectar en una revisión, porque en el texto todo es verdad, salvo a qué está asociado.
3. Similitud semántica en lugar de coincidencia exacta
La trampa de ingeniería más típica. La búsqueda vectorial, por construcción, busca «sobre lo mismo» y no «exactamente eso». En una consulta conversacional es una ventaja; en un identificador exacto, una fuente de errores.
Un código de artículo, un número de pedido, la versión de un documento, el número de una norma, el nombre de un plan, una fecha: son justo las entidades donde un resultado semánticamente cercano es un resultado incorrecto. Y son justo las entidades donde el error cuesta más. La similitud de significado le gana a la coincidencia exacta, y el agente toma con seguridad la fila vecina.
4. La fuente quedó desactualizada
El documento alguna vez fue correcto. La política se reescribió, el plan cambió, el reglamento se actualizó, y la versión vieja se quedó en el índice sin ninguna penalización por antigüedad. La búsqueda entrega diligentemente el fragmento más relevante, y el relevante resulta ser el del año pasado.
Aquí hay además una segunda parte del problema: la fuente se actualizó, pero no se reindexó. Formalmente los datos están al día; en la búsqueda sigue la copia vieja.
5. No existe el estado «no encontré»
La más arquitectónica de las cinco. Si el sistema no contempla el permiso de decir «no hay evidencia suficiente», se optimiza para que la respuesta esté completa, no para que sea fiable.
En el estudio este efecto se midió aparte: a las consultas se les colaba una premisa falsa —un apellido incorrecto, una fecha desplazada, un detalle inventado— y se añadía la opción «información insuficiente para responder». Según el estudio, la precisión cayó del 88–96% al 19–70% según el modelo. El más vulnerable dio por cierto el dato inventado en el 64% de los casos. Es decir, dos tercios de las veces el sistema no notó que la pregunta estaba construida sobre algo falso y buscó diligentemente la confirmación de algo que no existía.
Los autores notaron además una rareza aparte, a la que llamaron detection-accuracy paradox: el mejor detector de premisas falsas resultó apenas segundo en la capacidad de dar, pese a todo, la respuesta correcta. Notar la trampa en la pregunta y salir de ella son, al parecer, dos capacidades distintas, y una no arrastra a la otra.
Un agente que no sabe negarse a responder es más peligroso que uno que se niega de más. Una mecánica parecida funciona en otros sistemas: la he analizado con el ejemplo de cómo un agente rompe su propia métrica, cuando el sistema premia el hecho de terminar el trabajo y no su calidad.
Qué hacer con esto
El orden de abajo va de lo más barato a lo más caro de implantar.
Separar la búsqueda de la respuesta. Primero el agente devuelve un resultado de búsqueda estructurado: qué documentos encontró, con qué fecha, de qué fuente. Solo después viene la generación a partir de esos fragmentos. Mientras los dos pasos estén fundidos en una sola llamada, no puedes decir dónde se rompió exactamente, y cualquier «mejora del prompt» dispara a ciegas.
Verificar que el fragmento corresponda a la pregunta, no al tema. Entre «este texto trata de plazos de pago» y «este texto contiene la respuesta a la pregunta sobre el plazo de pago del contrato n.º» hay un abismo. Un reranker que evalúe justo lo segundo elimina la mayor parte de la categoría «smart wrong».
Hybrid retrieval en lugar de embeddings puros. Reparte la carga: la búsqueda por keywords (BM25, el algoritmo clásico de ranking por coincidencia de palabras) se queda con identificadores exactos, códigos, nombres y versiones; la vectorial, con consultas conversacionales y parafraseadas; el reranker ordena a los candidatos; los filtros por metadatos descartan al cliente ajeno, el período equivocado y la versión equivocada. Esto no es «embeddings mejorados», es repartir riesgos entre mecanismos, cada uno fuerte donde el otro es ciego.
Después vienen dos cosas baratas que, por alguna razón, se hacen al final. La frescura debe ser una señal de ranking aparte: recency scoring más una política de obsolescencia, porque un documento sin fecha de indexación es un documento sin fecha de caducidad. Y la provenance —el pasaporte del fragmento: fuente, versión, momento de indexación, posición en el archivo— hace falta en cada fragmento: una respuesta sin una referencia válida simplemente no debe llegar al usuario. Es la forma más barata de convertir un error invisible en uno visible, y casi siempre se deja «para después».
Probar el retrieval por separado de la generación. Monta un conjunto de consultas reales, fija para cada una qué documento es la respuesta correcta y mide una sola cosa: si ese documento entra en el top-k, es decir, en ese puñado de resultados que la búsqueda realmente le entrega al agente. No «si la respuesta del agente es buena», sino si ha aparecido el archivo necesario. Treinta consultas bastan para ver el panorama, así que es trabajo de medio día, no de un trimestre.
Esta métrica no depende en absoluto del modelo, por eso es la única que muestra en estado puro el efecto de los cambios en el chunking (cómo se corta un documento largo en fragmentos), la indexación y el ranking. Y también responde si tiene sentido la próxima subida de modelo: si el documento necesario no llega al contexto en un tercio de los casos, el modelo más inteligente del mercado no va a salvar ese tercio.
La lógica es la misma que en el autoaprendizaje del agente: mientras el resultado no se pueda verificar automáticamente, la mejora no tiene de dónde impulsarse.
Lo último es un estado explícito de «no encontré evidencia suficiente» y una ruta de escalado a una persona. Esto ya es parte de la respuesta a la pregunta de qué blast radius tiene tu agente: un sistema que sabe detenerse limita las consecuencias de su propio error.
La verificación más barata, con la que conviene empezar mañana: toma las cinco últimas quejas sobre el agente y mira qué documentos le dieron, no qué respondió. Si en tu empresa hay una persona aparte a cargo del agente, este párrafo es para ella, y lo que hay que pedir son los logs de contexto, no ejemplos de malas respuestas.
La cadena donde se rompe
Si se reduce todo a un solo esquema, el camino de los datos a la respuesta se ve así:
Fuente → Extracción → Normalización → Almacenamiento → Indexación → Búsqueda → Reranking → Respuesta
El modelo se encarga del último eslabón. El estudio dice que la mayoría de los errores están en los dos anteriores. Y en mi práctica los culpables más frecuentes son los tres primeros: en la base vectorial se vuelca un dump crudo de archivos no estructurados, la unidad atómica de indexación se elige al azar, la actualización de la fuente no dispara la reindexación. Los datos en teoría están, solo que el agente no puede obtenerlos de forma fiable.
Por eso el diagnóstico empieza con la pregunta «qué fue exactamente lo que cayó en el contexto del agente cuando se equivocó», y solo después llega a la elección del modelo. La respuesta casi siempre está en los logs, si es que los guardas. Más o menos con la misma lógica evalúo las nuevas herramientas de IA: primero miro qué muestra el sistema sobre su propio trabajo, y solo después lo inteligente que suena.
RAG no elimina el problema, lo traslada
La mayoría de las veces, un agente que se equivocó no «pensó mal». Abrió la página equivocada y repitió su contenido con toda diligencia. Un modelo más inteligente en este escenario cambia solo la calidad de la redacción, y justamente por eso la subida de modelo decepciona tan a menudo: los mismos errores, expuestos de forma más profesional.
El RAG por sí solo tampoco salva: cambia el carácter del error. En lugar de «el modelo inventó» obtienes «el modelo repitió con seguridad el documento equivocado». El segundo al menos se puede rastrear hasta un archivo concreto, pero solo si el sistema tiene provenance, fechas y métricas de búsqueda separadas. Sin ellas sigues mirando un párrafo pulido sin manera de verificar de dónde salió.
Mi experiencia dice que la mayoría de los análisis de «por qué se equivocó el agente» terminan en tres líneas de log sobre qué archivo entró en el contexto.
FAQ
¿RAG resuelve el problema de las alucinaciones?
No, RAG cambia su naturaleza. En lugar de un dato inventado obtienes un dato real de un documento equivocado. Es mejor, porque el error se puede rastrear hasta la fuente, pero solo a condición de que cada fragmento tenga provenance: referencia, versión y fecha.
¿Cómo saber si el problema está en el retrieval y no en el modelo?
Toma unas decenas de consultas en las que el agente se equivocó y mira qué contexto se le pasó en realidad. Si el documento necesario estaba en el contexto y la respuesta es incorrecta, es el modelo. Si el documento no estaba o era otro, es la búsqueda. En el estudio de Stanford y Together AI, lo segundo fue más del 70% de los casos.
¿Qué es hybrid retrieval y por qué no bastan los embeddings solos?
Es la combinación de búsqueda por keywords (BM25) para coincidencias exactas, búsqueda vectorial para el significado, un reranker para ordenar a los candidatos y filtros por metadatos. La búsqueda vectorial pura, por construcción, encuentra «sobre lo mismo» y no «exactamente eso», por eso pierde con códigos de artículo, números, versiones y fechas, ahí donde el error cuesta más.
¿Qué sale más barato: mejorar la búsqueda o pasarse a un modelo más caro?
Los autores del estudio escriben directamente que mejorar el retrieval probablemente dará un mayor aumento de precisión que aumentar los parámetros del modelo, al menos para consultas sobre información actual. Un argumento adicional: el resultado de cambiar de modelo no lo controlas, mientras que los cambios en el índice, el ranking y los metadatos siguen siendo tuyos.
¿Se puede reemplazar el retrieval por una ventana de contexto grande?
Si todo el corpus útil cabe en el contexto, sí, y muchas veces es más simple que un pipeline. El límite conviene definirlo midiendo: ejecutar la misma tarea con 10, 50, 200 y 500 mil tokens y encontrar el punto donde la calidad empieza a caer. Ese punto muestra cuándo el retrieval hace falta de verdad.
¿Qué hacer si la consulta del usuario contiene una premisa falsa?
Prever una opción explícita de «datos insuficientes» y enseñarle al sistema a usarla. En el estudio, a los modelos se les daban preguntas con un detalle incorrecto y, a la vez, se añadía la respuesta «información insuficiente»: la precisión en ese conjunto caía del 88–96% al 19–70%, y el modelo más vulnerable dio por cierto el dato inventado en el 64% de los casos. Sin permiso para negarse, el sistema se optimiza para que la respuesta esté completa, no para que sea veraz.
¿Cómo probar el retrieval por separado de la generación?
Reúne un conjunto de consultas reales con los documentos correctos conocidos de antemano y mide si el documento necesario entra en el top-k de resultados. Esta métrica no depende del modelo, por eso muestra en estado puro el efecto de los cambios en la indexación, el chunking y el ranking.
Fuentes: Suzgun M., Shen E., Bianchi F., Spangher A., Icard T., Ho D. E., Jurafsky D., Zou J. «Evaluating Commercial AI Chatbots as News Intermediaries», arXiv:2605.22785, 21 de mayo de 2026; análisis de The Batch, «Web Retrieval Flusters LLMs», 24 de julio de 2026.
Publicado por Andrew Maryasov, consultor de IA, fundador de Auspex y Grow2.ai; las implantaciones las llevan Auspex (CRM) y Grow2.ai (agentes de IA).

Una carta sobre IA: 2–3 emails al mes
Ensayos personales sobre cómo la IA cambia nuestra forma de pensar y trabajar: qué probé yo mismo, qué funcionó y qué no. Al final, enlaces a lo mejor de lo que he leído.
Sin spam. Puedes darte de baja con un clic.