Precio de los agentes de IA: por qué la factura sube si el token baja
Escribí que el coste del trabajo de la IA siempre baja. Gemini 3.5 Flash triplicó su precio y el mismo benchmark cuesta 5,5 veces más. El error y las conclusiones.
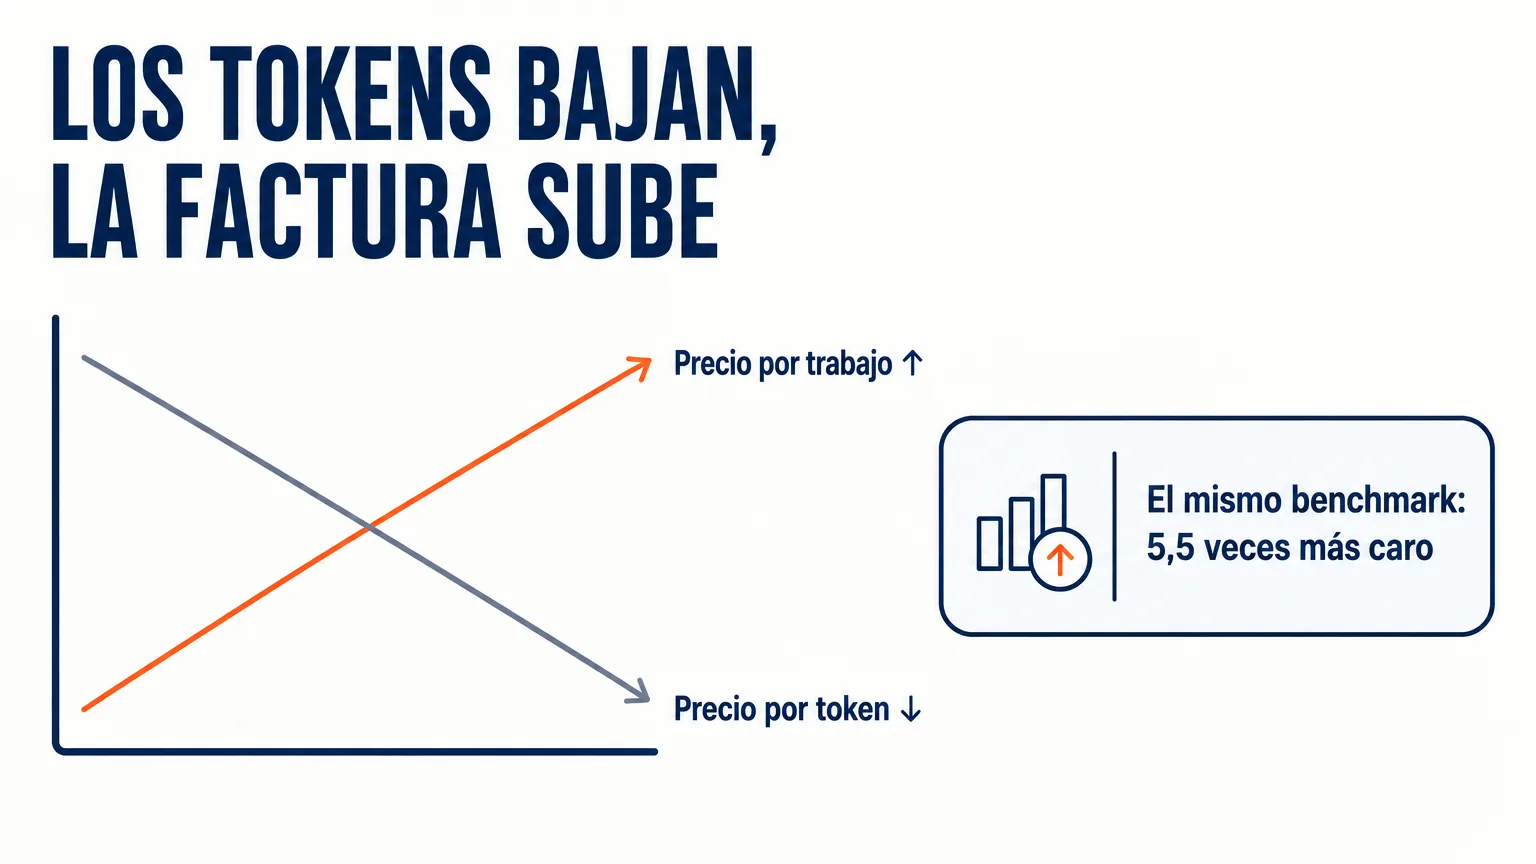
Andrew Maryasov, consultor de IA. En febrero de 2026 afirmé públicamente que el precio por unidad de trabajo de la IA siempre baja. En mayo Google lanzó Gemini 3.5 Flash, y el mismo conjunto de pruebas que su predecesor resolvía 5,5 veces más barato terminó costando 1552 $. Por token, Gemini 3.5 Flash es más barato que Gemini 3.1 Pro. Por trabajo, un 75% más caro. Mi error fue creer que esas dos magnitudes eran una sola.
Este es un análisis fechado de la dinámica de precios, no un texto atemporal: todas las tarifas y los nombres de versiones corresponden a mayo de 2026. A octubre de 2026, Google ya redirige las peticiones a Gemini 3.5 Flash hacia Gemini 3.6 Flash, y 3.6 y 3.8 Flash cuestan 0,75 $/3,75 $ por millón de tokens hasta finales de 2026 y 1,50 $/7,50 $ desde el 1 de enero de 2027. El mecanismo por el que la factura sube mientras el precio por token baja no depende del cambio de modelos, pero las cifras concretas revísalas en la lista de precios el día que leas esto.
TL;DR (en 30 segundos)
- El precio por token y el precio por trabajo son magnitudes distintas, y la segunda no está obligada a bajar junto con la primera.
- Gemini 3.5 Flash cuesta 1,50 $/9,00 $ por millón de tokens (entrada/salida), frente a 0,50 $/3,00 $ del modelo al que reemplazó. El triple de caro bajo la misma marca «Flash».
- En la ejecución del Intelligence Index de Artificial Analysis, el nuevo Flash salió más caro que Gemini 3.1 Pro, a pesar de que por token es más barato.
- La causa no está en la lista de precios, sino en que un modelo de razonamiento gasta iteraciones: pensamiento, verbosidad, repeticiones, reintentos.
- La palanca del coste es la topología del sistema, no una línea de la lista de precios. Un agente que hace cinco llamadas donde basta una cuesta más que cualquier ahorro en el modelo.
Me atraparon ya en febrero
El 21 de febrero de 2026 publiqué un post sobre la caída de los precios de la IA. El motivo fue el comentario de un suscriptor: «Andrew, 200 $ es un precio con descuento. Pronto esta suscripción va a costar 2000 $. ¿Qué vas a hacer entonces?»
Respondí con cifras. Stanford AI Index: el coste de la inferencia de nivel GPT-3.5 cayó más de 280 veces en aproximadamente un año y medio: de veinte dólares por millón de tokens en noviembre de 2022 a siete céntimos en octubre de 2024. GPT-4 costaba 30 $/60 $ en su lanzamiento; GPT-4o mini, dieciséis meses después, 0,15 $/0,60 $. Luego saqué la paradoja de Jevons: cuando el carbón se abarata, no se compra menos, sino más. Y el gasto corporativo en IA crecía justo cuando el precio por token se desplomó; aquí no doy a propósito un porcentaje concreto, porque no tengo una fuente primaria que lo respalde y que esté dispuesto a mostrar.
Y añadí la frase que ahora estoy pagando: el precio por unidad de trabajo baja y seguirá bajando: así funciona toda tecnología en la historia.
Le respondí al suscriptor con un gráfico, y tres meses después ese mismo gráfico me respondió a mí.
Qué pasó el 19 de mayo
En Google I/O 2026 salió Gemini 3.5 Flash. Directamente a general availability, sin preview público. Y entonces los desarrolladores miraron la lista de precios.
Según la lista de precios oficial de Google a finales de mayo de 2026:
| Modelo | Entrada ($/1M) | Salida ($/1M) |
|---|---|---|
| Gemini 3.1 Flash-Lite | 0,25 $ | 1,50 $ |
| Gemini 3 Flash | 0,50 $ | 3,00 $ |
| Gemini 3.5 Flash | 1,50 $ | 9,00 $ |
| Gemini 3.1 Pro | 2,00 $ | 12,00 $ |
El modelo que se posiciona como reemplazo de Gemini 3 Flash cuesta exactamente el triple que su predecesor. Y queda apenas una cuarta parte por debajo de la tarifa Pro. Durante años la palabra «Flash» significó «el nivel barato pero sensato»; ahora no significa nada concreto (imagina que la gasolina de 92 octanos de pronto cuesta en la gasolinera lo mismo que la de 98, y el letrero del surtidor no ha cambiado). La lista de precios oficial lo confirmaba: 1,50 $ por millón de tokens de entrada, 9,00 $ por millón de tokens de salida, incluidos los tokens de pensamiento, y 0,15 $ por el contexto en caché.
The Batch lo llevó al titular del número 355, del 29 de mayo: Gemini Flash Gets Pricey. La redacción señaló el contexto más amplio: Anthropic, OpenAI y Google subieron el precio por token en sus modelos nuevos. La tendencia no es un caso aislado.
El encarecimiento de un solo lanzamiento, por sí mismo, no me habría molestado: los precios se mueven en ambas direcciones, es normal.
Dónde exactamente me equivoqué
Mi tesis no era «los tokens se abaratan». Mi tesis era «la unidad de trabajo se abarata», y fue justo en esa formulación donde me atraparon.
Artificial Analysis pasa todos los modelos por el mismo conjunto de pruebas: el Intelligence Index. Es literalmente el mismo trabajo: las mismas tareas, el mismo volumen. Cuánto cuesta ejecutarlo:
Gemini 3.5 Flash con el pensamiento activado costó 1552 $. En palabras de la propia Artificial Analysis: es 5,5 veces más caro que la ejecución de Gemini 3 Flash y un 75% más caro que Gemini 3.1 Pro.
Léelo otra vez. El nuevo Flash es más barato que Pro por token (1,50 $ frente a 2,00 $) y, al mismo tiempo, tres cuartas partes más caro que Pro por trabajo terminado. Y frente al modelo al que reemplazó, el mismo trabajo se encareció 5,5 veces. The Batch lo dice sin suavizarlo: según la medición de Artificial Analysis, Flash sale más caro que Gemini 3.1 Pro.
Las dos afirmaciones son ciertas a la vez, y justo esa posibilidad no la contemplaba mi modelo del mundo de febrero: en ese momento estaba sinceramente convencido de que era una misma curva, solo que en unidades distintas.
El agente gasta iteraciones, no tokens
El mecanismo es simple cuando lo ves. El token no es una unidad de trabajo. Es una unidad de facturación. La unidad de trabajo es la tarea resuelta. Entre ambas está la cantidad de iteraciones que el modelo gasta hasta llegar a la respuesta.
Un modelo de razonamiento piensa en voz alta, y cada token de pensamiento se cobra como token de salida. Es verboso donde su predecesor respondía con una línea. Se vuelve a preguntar a sí mismo. En una cadena compleja repite el paso que no cuadró. El proveedor puede bajar el precio por token a la mitad y aun así pasar una factura mayor si el modelo empezó a gastar cuatro veces más tokens en la misma respuesta.
Después eso se multiplica por la arquitectura. Imagina un agente de diez pasos consecutivos, cada uno con una fiabilidad del 95%, una cifra con la que la mayoría de los equipos estaría conforme. La fiabilidad de extremo a extremo de esa cadena: 0,95¹⁰ ≈ 60%. Cuatro ejecuciones de cada diez habrá que repetirlas. El cerebro, mientras tanto, dice: «pero si es un 95%, casi perfecto», y la multiplicación dice otra cosa. La factura por los reintentos no aparecerá en la lista de precios de ningún proveedor, pero te llegará a la tarjeta.
Además, la repetición cuesta más que la primera ejecución: el agente entra a la segunda vuelta con el contexto inflado. Y sin un paso de verificación aparte ni siquiera sabe que el primer resultado era erróneo, y paga la tarifa completa por un disparate dicho con seguridad.
Ya escribí que los tokens son una mala métrica del riesgo de un agente de IA, y proponía medir el blast radius. Resulta que los tokens son una métrica igual de mala para el coste. Dos caminos distintos me llevaron a la misma conclusión, y me las arreglé para no notarlo la primera vez.
La topología cuesta más que el modelo
La diferencia entre el modelo más barato y el más caro de la tabla anterior es de ocho veces: de 0,25 $ por millón de tokens de entrada en Flash-Lite a 2,00 $ en 3.1 Pro. La diferencia entre un pipeline secuencial ordenado y un planificador con juez y consenso es de un orden de magnitud en la misma tarea. La topología mueve el coste en órdenes de magnitud. La elección del modelo lo mueve dentro de un mismo orden.
De ahí sale un orden de acciones contrario al intuitivo. Primero, la auditoría de la estructura: cuántas llamadas hace el agente, cuántas de ellas hacen falta de verdad, dónde se puede reducir la cadena a una sola llamada con un eval más preciso. Solo después, regatear por el modelo.
El error de arquitectura más caro ni siquiera está en la topología, sino en los alias. Si en tu config está escrito gemini-flash sin versión, tu «opción barata de respaldo» pudo haberse encarecido al triple mientras leías este párrafo. Una política de fallback escrita a comienzos de 2026 hoy lleva a otra categoría de precio bajo el mismo nombre.
Klarna: la factura llega en otra moneda
El ejemplo más conocido de que el coste se mide donde no toca: Klarna.
Su asistente de IA sobre modelos de OpenAI atendió 2,3 millones de conversaciones con clientes en el primer mes, lo que se equiparaba al trabajo de 700 agentes de soporte. El tiempo de resolución bajó de once minutos a menos de dos, y la empresa estimó el efecto en unos 40 millones de dólares: las cuatro cifras salen de su propio comunicado de prensa.
Y en mayo de 2025 Sebastian Siemiatkowski, cofundador y CEO, empezó a contratar gente de nuevo. Lo formuló así: cuando el coste se vuelve un criterio de evaluación demasiado predominante, lo que obtienes al final es una calidad más baja.
Este caso se cuenta mal una y otra vez, y yo estuve a punto de contarlo igual. Un portavoz de Klarna aclaró después que el CEO hablaba de la calidad de los agentes humanos subcontratados, no de la IA. Ahí mismo, Christina McAllister, analista principal de Forrester, señala como causa un recorte de personal demasiado brusco, no la automatización en sí. Klarna no «reconoció el fracaso de la IA»: pasó a un modelo híbrido y le dejó al cliente un camino garantizado hacia una persona.
Pero la estructura básica del error es la misma que la mía con los tokens. Klarna tenía una métrica limpia, medible y en descenso: el coste de atender una transacción, que según su propio informe bajó un 40% desde el primer trimestre de 2023. La métrica bajaba. La factura llegó en otra moneda: contactos repetidos, satisfacción, confianza en la marca. Yo tenía una métrica limpia y en descenso: el coste del token. La factura llegó en iteraciones.
Se abarata lo que mides. Se encarece lo que no mides.
¿Anula esto la paradoja de Jevons?
No. Jevons sigue vivito y coleando: el gasto en IA crece justamente porque la unidad se abarató y los usos se multiplicaron. Mi post de febrero describía bien el panorama macro y le respondió bien al suscriptor: 200 $ no se convertirán en 2000 $ por el mismo trabajo.
El error estaba en la palabra «siempre». Tomé una tendencia histórica que se sostenía en el abaratamiento de la inferencia y la extendí a una unidad que no depende de la inferencia, sino del comportamiento del modelo y de la forma de tu sistema. La tendencia del precio por token se sostiene en el hardware, la cuantización y la competencia, mientras que el precio por trabajo depende de cuántas veces piense tu agente antes de responder. Son dos curvas distintas, y no están obligadas a ir en la misma dirección.
Qué he cambiado en mi práctica. He dejado de mirar el precio por millón de tokens como indicador del coste. En su lugar mido el coste de una tarea completada con éxito, con reintentos, con tokens de pensamiento, con todos los pasos de la cadena. Antes de evaluar una herramienta nueva, ahora sumo al cálculo el coste de las iteraciones, no solo el coste de integrarla. Y fijo las versiones de los modelos en los configs de forma explícita, porque un alias es un cheque al portador sin límite.
La próxima vez que un proveedor te muestre un gráfico de la caída del precio por token, haz una sola pregunta: ¿y cuántos tokens hacen falta ahora para la misma respuesta?
FAQ
¿Por qué Gemini 3.5 Flash es más caro que Gemini 3.1 Pro si por token es más barato?
Por token, el nuevo Flash sí es más barato: 1,50 $ frente a 2,00 $ en la entrada. Pero en la ejecución del Intelligence Index de Artificial Analysis, con el pensamiento activado, costó 1552 $: un 75% más que Pro. El modelo gasta muchos más tokens en el mismo trabajo. Según Artificial Analysis, usa casi los mismos tokens de salida que Gemini 3 Flash (73 millones frente a 72 millones), pero muchos más de entrada, porque en las evaluaciones agénticas hace más turnos. Eso es lo que se come el ahorro en la tarifa.
¿Cuánto se ha encarecido exactamente Gemini Flash?
Gemini 3.5 Flash cuesta 1,50 $ por millón de tokens de entrada y 9,00 $ por millón de tokens de salida. El modelo al que reemplaza, Gemini 3 Flash, costaba 0,50 $ y 3,00 $ respectivamente. Es exactamente el triple, bajo el mismo nombre «Flash».
¿Qué es el «precio de la iteración» en contraste con el precio del token?
El precio del token es cuánto cobra el proveedor por unidad de texto. El precio de la iteración es cuántos tokens gasta tu sistema hasta llegar a una respuesta aceptable: el pensamiento del modelo, la repetición de pasos, los reintentos tras una validación fallida, la coordinación entre agentes. La factura la forma la segunda magnitud, y la lista de precios muestra la primera.
¿Cómo bajar de verdad el coste de un agente de IA?
Primero, la auditoría de la topología: cuántas llamadas al modelo hace el agente y cuántas de ellas son realmente necesarias. Reducir una cadena sobrante a una sola llamada da un ahorro de un orden de magnitud. Elegir un modelo más barato da un ahorro dentro de un mismo orden. Por eso la estructura se optimiza primero y el modelo, después.
¿Significa esto que la IA se está encareciendo en general?
No. El coste de la inferencia a calidad fija viene bajando históricamente, y eso continúa. Lo que ha cambiado es que los modelos nuevos gastan más tokens por respuesta y las arquitecturas agénticas multiplican la cantidad de llamadas. Por eso la factura concreta de un equipo concreto puede crecer en medio de un abaratamiento general.
¿Por qué es peligroso escribir gemini-flash sin versión en el config?
La marca «Flash» ya no garantiza un nivel de precio. Un alias sin versión explícita puede apuntar a un modelo que cuesta el triple que aquel para el que se escribió tu política de fallback. Fija el identificador completo del modelo.
¿La paradoja de Jevons ya no funciona?
Funciona. El gasto total en IA crece justamente porque la unidad se abarató y los usos se multiplicaron. La paradoja describe el nivel macro. El error aparece cuando de ella se deduce que el precio de cada tarea concreta también va a bajar, y no es así.
Publicado por Andrew Maryasov, consultor de IA, fundador de Auspex y Grow2.ai; las implantaciones las llevan Auspex (CRM) y Grow2.ai (agentes de IA).
Si ya tienes un agente funcionando en producción, calcula el coste de una tarea completada con éxito, no el coste de un millón de tokens. La diferencia entre esos dos números es tu factura real. Cómo analizo la topología y el coste de los sistemas agénticos: en la página de consultoría. Y si haces la cuenta por tu lado, escríbeme qué te ha salido: las cifras me interesan más que los pronósticos.
Fuentes:
- Gemini 3.5 Flash: everything you need to know: Artificial Analysis, 1552 $ por la ejecución del Intelligence Index, 5,5 veces más caro que Gemini 3 Flash y un 75% más caro que Gemini 3.1 Pro
- Gemini 3.5 Flash pairs smarts with speed: The Batch, 29 de mayo de 2026
- Gemini API pricing: tarifas por token
- AI Index Report 2025, capítulo 1: Stanford HAI: caída de 20,00 $ a 0,07 $ por millón de tokens, de noviembre de 2022 a octubre de 2024
- Klarna AI assistant handles two-thirds of customer service chats in its first month: comunicado de prensa de Klarna, 27 de febrero de 2024
- Klarna accelerates global momentum in Q1 2025: caída del 40% del coste por transacción desde el 1T de 2023
- Klarna is hiring humans again: Silicon Republic: la aclaración del portavoz de Klarna y el comentario de Christina McAllister (Forrester)
- Klarna reinvests in human talent: Customer Experience Dive, mayo de 2025

Una carta sobre IA: 2–3 emails al mes
Ensayos personales sobre cómo la IA cambia nuestra forma de pensar y trabajar: qué probé yo mismo, qué funcionó y qué no. Al final, enlaces a lo mejor de lo que he leído.
Sin spam. Puedes darte de baja con un clic.