Ціна AI-агентів: чому рахунок росте, коли токени дешевшають
Я писав, що вартість роботи AI падає завжди. Gemini 3.5 Flash подорожчав утричі, і той самий бенчмарк коштує в 5,5 раза більше. Розбір помилки та висновки.
Andrew Maryasov, AI-консультант. У лютому 2026 я публічно стверджував, що ціна за одиницю роботи AI падає завжди. У травні Google випустив Gemini 3.5 Flash — і той самий набір тестів, який попередниця проходила в 5,5 раза дешевше, став коштувати $1 552. Ціна за токен впала. Рахунок виріс. Помилка була в тому, що я вважав ці дві величини однією.
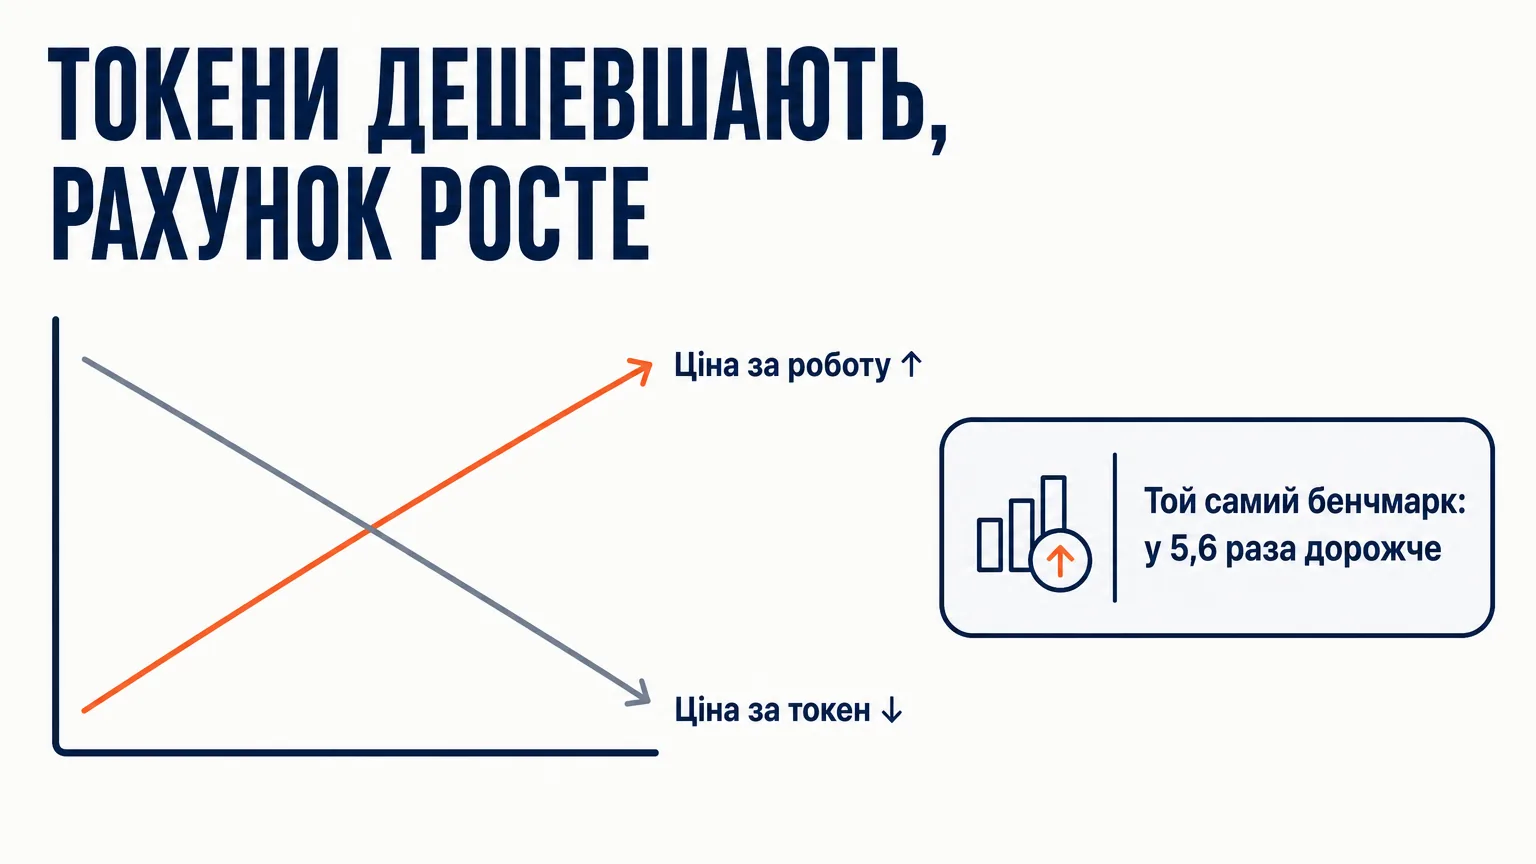
Це датований розбір цінової динаміки, а не вічнозелений текст: усі ставки й назви версій наведені станом на травень 2026 року. Механізм, через який рахунок росте на тлі падіння ціни за токен, від зміни моделей не залежить — а конкретні цифри перевіряйте в прайсі на день читання.
TL;DR (за 30 секунд)
- Ціна за токен і ціна за роботу — різні величини, і друга не зобов’язана падати разом із першою.
- Gemini 3.5 Flash коштує $1,50/$9,00 за мільйон токенів (вхід/вихід) проти $0,50/$3,00 у моделі, яку він замінив. Утричі дорожче під тим самим брендом «Flash».
- На прогоні Intelligence Index від Artificial Analysis новий Flash вийшов дорожчим за Gemini 3.1 Pro — при тому, що за токен він дешевший.
- Причина не в прайсі, а в тому, що reasoning-модель витрачає ітерації: мислення, багатослівність, повтори, ретраї.
- Важіль вартості — топологія системи, а не рядок у прайс-листі. Агент, який робить п’ять викликів там, де вистачає одного, дорожчий за будь-яку економію на моделі.
Мене спіймали ще в лютому
21 лютого 2026 я опублікував пост про падіння цін на AI. Приводом був коментар підписника: «Андрій, $200 — це дисконтна ціна. Скоро ця підписка буде коштувати $2000. Що робитимеш тоді?»
Я відповів цифрами. Stanford AI Index: вартість інференсу рівня GPT-3.5 впала більш ніж у 280 разів приблизно за півтора року — з двадцяти доларів за мільйон токенів у листопаді 2022-го до семи центів у жовтні 2024-го. GPT-4 на старті коштував $30/$60, GPT-4o mini через шістнадцять місяців — $0,15/$0,60. Далі я дістав парадокс Джевонса: коли вугілля дешевшає, його купують не менше, а більше. І корпоративні витрати на AI росли саме тоді, коли ціна за токен обвалилася — конкретний відсоток я тут навмисно не називаю, бо не маю під нього первинного джерела, яке готовий показати.
І дописав фразу, за яку тепер розплачуюсь: ціна за одиницю роботи падає, і падатиме — так працює кожна технологія в історії.
Я відповів підписнику графіком, а через три місяці той самий графік відповів мені.
Що сталося 19 травня
На Google I/O 2026 вийшов Gemini 3.5 Flash. Одразу в general availability, без публічного preview. А тоді розробники подивилися на прайс.
За даними офіційного прайсу Google на кінець травня 2026:
| Модель | Вхід ($/1M) | Вихід ($/1M) |
|---|---|---|
| Gemini 3.1 Flash-Lite | $0,25 | $1,50 |
| Gemini 3 Flash | $0,50 | $3,00 |
| Gemini 3.5 Flash | $1,50 | $9,00 |
| Gemini 3.1 Pro | $2,00 | $12,00 |
Модель, яку позиціонують як заміну Gemini 3 Flash, коштує рівно втричі дорожче за попередницю. І сидить лише на чверть нижче за Pro-тариф. Слово «Flash» роками означало «дешевий, але притомний ярус» — тепер воно не означає нічого конкретного (уявіть, що бензин А-92 на заправці раптом коштує як А-98, а напис на колонці не змінився). Офіційний прайс підтверджує: $1,50 за мільйон вхідних, $9,00 за мільйон вихідних із урахуванням токенів мислення, $0,15 за кешований контекст.
The Batch виніс це в заголовок випуску 355 від 29 травня: Gemini Flash Gets Pricey. Редакція відзначила ширший контекст: Anthropic, OpenAI і Google підняли ціну за токен на своїх нових моделях. Тренд не одиничний.
Саме по собі подорожчання одного релізу мене б не зачепило — ціни ходять в обидва боки, це нормально.
Де саме я помилявся
Моя теза була не «токени дешевшають». Моя теза була «одиниця роботи дешевшає» — і саме на цьому формулюванні мене й підловили.
Artificial Analysis ганяє всі моделі через однаковий набір тестів — Intelligence Index. Це буквально одна й та сама робота: ті самі задачі, той самий обсяг. Скільки коштує її прогнати:
Gemini 3.5 Flash з увімкненим мисленням обійшовся в $1 552. Формулювання самої Artificial Analysis: це в 5,5 раза дорожче за прогін Gemini 3 Flash і на 75% дорожче за Gemini 3.1 Pro.
Прочитайте це ще раз. Новий Flash дешевший за Pro за токен ($1,50 проти $2,00) і водночас на три чверті дорожчий за Pro за виконану роботу. А проти моделі, яку він замінив, та сама робота подорожчала в 5,5 раза. The Batch формулює це без пом’якшень: за вимірюванням Artificial Analysis, Flash обходиться дорожче, ніж Gemini 3.1 Pro.
Обидва твердження істинні одночасно, і саме цю можливість моя лютнева модель світу не передбачала — я тоді був щиро певен, що це одна й та сама крива, просто в різних одиницях.
Агент витрачає ітерації, а не токени
Механізм простий, коли його побачиш. Токен — це не одиниця роботи. Це одиниця розрахунку. Одиниця роботи — розв’язана задача. Між ними стоїть кількість ітерацій, які модель витрачає, доки дійде до відповіді.
Reasoning-модель думає вголос, і кожен токен мислення оплачується як вихідний. Вона багатослівна там, де попередниця відповідала одним рядком. Вона перепитує саму себе. У складному ланцюжку вона повторює крок, який не зійшовся. Провайдер може знизити ціну за токен удвічі — і все одно виставити більший рахунок, якщо модель почала витрачати вчетверо більше токенів на ту саму відповідь.
Далі це множиться на архітектуру. Уявіть агента з десяти послідовних кроків, кожен із надійністю 95% — цифра, якою більшість команд була б задоволена. Наскрізна надійність такого ланцюжка: 0,95¹⁰ ≈ 60%. Чотири прогони з десяти доведеться повторити. Мозок при цьому каже: «ну 95% же, майже ідеально» — а множення каже інше. Рахунок за ретраї не з’явиться в прайс-листі жодного вендора, але прийде у вас на картку.
Причому повтор коштує дорожче за перший прогон: агент заходить на другий круг із роздутим контекстом. А без окремого кроку верифікації він навіть не знає, що перший результат був хибним, — і платить за впевнену дурницю за повним тарифом.
Я вже писав, що токени — погана метрика ризику AI-агента, і пропонував міряти blast radius. Виявляється, токени — так само погана метрика вартості. Мене двічі привела до одного й того самого висновку різна дорога, і я примудрився не помітити цього перший раз.
Топологія коштує дорожче за модель
Різниця між найдешевшою і найдорожчою моделлю в лінійці Google — шестикратна: від $0,25 за мільйон у Flash-Lite до $1,50 у 3.5 Flash. Різниця між акуратним послідовним пайплайном і планувальником із суддею та консенсусом — порядок величини на тій самій задачі. Топологія рухає вартість через порядки. Вибір моделі рухає її всередині одного порядку.
З цього випливає порядок дій, зворотний до інтуїтивного. Спершу аудит структури: скільки викликів робить агент, скільки з них справді потрібні, де ланцюжок можна згорнути в один виклик із чіткішим evalʼом. Тільки потім — торг за модель.
Найдорожча архітектурна помилка навіть не в топології, а в аліасах. Якщо у вашому конфізі прописано gemini-flash без версії, ваш «дешевий запасний варіант» міг подорожчати втричі, поки ви читали цей абзац. Fallback-політика, написана на початку 2026 року, сьогодні веде в іншу цінову категорію під тією самою назвою.
Klarna: рахунок приходить не в тій валюті
Найвідоміший приклад того, що вартість вимірюють не там, — Klarna.
Їхній AI-асистент на моделях OpenAI за перший місяць провів 2,3 мільйона розмов з клієнтами, що прирівнювали до роботи 700 агентів підтримки. Час розв’язання впав з одинадцяти хвилин до менш ніж двох, а ефект компанія оцінила приблизно в $40 мільйонів — усі чотири числа з їхнього ж пресрелізу.
А в травні 2025 Себастьян Сємятковський, співзасновник і CEO, почав набирати людей назад. Його формулювання: коли витрати стають надто домінантним критерієм оцінки, на виході ви отримуєте нижчу якість.
Цей кейс масово переказують неправильно — і я мало не переказав слідом. Речник Klarna згодом уточнив, що CEO говорив про якість аутсорсингових людських агентів, а не про AI. Там же провідна аналітикиня Forrester Крістіна Макаллістер називає причиною надто різке скорочення штату, а не саму автоматизацію. Klarna не «визнала провал AI» — вона перейшла на гібридну модель і залишила клієнту гарантований шлях до людини.
Але базова структура помилки та сама, що й у мене з токенами. Klarna мала чисту, вимірювану, падаючу метрику: вартість обслуговування транзакції, яка за їхнім власним звітом впала на 40% від першого кварталу 2023 року. Метрика падала. Рахунок виставили в іншій валюті: повторні звернення, задоволеність, довіра до бренду. Я мав чисту падаючу метрику — вартість токена. Рахунок виставили в ітераціях.
Дешевшає те, що ви міряєте. Дорожчає те, чого ви не міряєте.
Чи скасовує це парадокс Джевонса
Ні. Джевонс живий і здоровий: витрати на AI ростуть саме тому, що одиниця подешевшала, а застосувань стало більше. Мій лютневий пост правильно описував макрокартину і правильно відповів підписнику — $200 не перетворяться на $2000 за ту саму роботу.
Помилка була у слові «завжди». Я взяв історичний тренд, який тримався на здешевленні інференсу, і поширив його на одиницю, яка визначається не інференсом, а поведінкою моделі та формою вашої системи. Тренд ціни за токен тримається на залізі, квантизації та конкуренції, тоді як ціна за роботу залежить від того, скільки разів ваш агент подумає, перш ніж відповісти. Дві різні криві, і в один бік вони йти не зобов’язані.
Що я змінив у себе. Я перестав дивитися на прайс за мільйон токенів як на індикатор вартості. Замість цього міряю вартість одного успішного завершення задачі — з ретраями, з токенами мислення, з усіма кроками ланцюжка. Перед тим, як оцінювати новий інструмент, я тепер додаю до розрахунку вартість ітерацій, а не тільки вартість вбудовування. І фіксую версії моделей у конфігах явно, бо аліас — це необмежений чек на пред’явника.
Наступного разу, коли вендор покаже вам графік падіння ціни за токен, поставте одне питання: а скільки токенів тепер потрібно на ту саму відповідь?
FAQ
Чому Gemini 3.5 Flash дорожчий за Gemini 3.1 Pro, якщо за токен він дешевший?
За токен новий Flash справді дешевший: $1,50 проти $2,00 на вході. Але на прогоні Intelligence Index від Artificial Analysis він з увімкненим мисленням обійшовся в $1 552 — на 75% дорожче за Pro. Модель генерує значно більше токенів мислення на ту саму задачу, і це з’їдає економію на ставці.
Наскільки саме подорожчав Gemini Flash?
Gemini 3.5 Flash коштує $1,50 за мільйон вхідних і $9,00 за мільйон вихідних токенів. Модель, яку він замінює, Gemini 3 Flash, коштувала $0,50 і $3,00 відповідно. Це рівно трикратне зростання під тією самою назвою «Flash».
Що таке «ціна ітерації» на противагу ціні токена?
Ціна токена — скільки провайдер бере за одиницю тексту. Ціна ітерації — скільки токенів ваша система витрачає, доки дійде до прийнятної відповіді: мислення моделі, повтори кроків, ретраї після невдалої валідації, координація між агентами. Рахунок формує друга величина, а прайс-лист показує першу.
Як реально знизити вартість AI-агента?
Спершу аудит топології: скільки викликів моделі робить агент і скільки з них справді необхідні. Згортання зайвого ланцюжка в один виклик дає економію на порядок. Вибір дешевшої моделі дає економію в межах одного порядку. Тому структуру оптимізують першою, а модель — другою.
Чи означає це, що AI дорожчає загалом?
Ні. Вартість інференсу фіксованої якості історично падає, і це триває. Змінилося те, що нові моделі витрачають більше токенів на відповідь, а агентні архітектури множать кількість викликів. Тому конкретний рахунок конкретної команди може зростати на тлі загального здешевлення.
Чому небезпечно писати gemini-flash без версії в конфігу?
Бренд «Flash» більше не гарантує цінового ярусу. Аліас без явної версії може вести на модель, що коштує втричі дорожче за ту, під яку писалася ваша fallback-політика. Фіксуйте повний ідентифікатор моделі.
Парадокс Джевонса більше не працює?
Працює. Сукупні витрати на AI ростуть саме тому, що одиниця подешевшала і застосувань стало більше. Парадокс описує макрорівень. Помилка виникає, коли з нього виводять, що ціна кожної конкретної задачі теж падатиме — це не так.
Опублікував Andrew Maryasov, AI-консультант, засновник Auspex і Grow2.ai; впровадження ведуть Auspex (CRM) і Grow2.ai (AI-агенти).
Якщо у вас уже крутиться агент у продакшені — порахуйте вартість одного успішного завершення задачі, а не вартість мільйона токенів. Різниця між цими двома числами і є ваш реальний рахунок. Як я розбираю топологію та вартість агентних систем — на сторінці консультацій. А якщо порахуєте самі, напишіть мені, що вийшло: цифри мене цікавлять більше за прогнози.
Джерела:
- Gemini 3.5 Flash: everything you need to know — Artificial Analysis: $1 552 за прогін Intelligence Index, у 5,5 раза дорожче за Gemini 3 Flash і на 75% дорожче за Gemini 3.1 Pro
- Gemini 3.5 Flash pairs smarts with speed — The Batch, 29.05.2026
- Gemini API pricing — ставки за токен
- AI Index Report 2025, глава 1 — Stanford HAI: падіння з $20,00 до $0,07 за мільйон токенів, листопад 2022 — жовтень 2024
- Klarna AI assistant handles two-thirds of customer service chats in its first month — пресреліз Klarna, 27.02.2024
- Klarna accelerates global momentum in Q1 2025 — падіння вартості транзакції на 40% від Q1 2023
- Klarna is hiring humans again — Silicon Republic: уточнення речника Klarna і коментар Крістіни Макаллістер (Forrester)
- Klarna reinvests in human talent — Customer Experience Dive, травень 2025
Лист про AI — 2–3 листи на місяць
Особисті есе про те, як AI змінює мислення й роботу: що я спробував сам, що спрацювало, а що ні. Наприкінці — посилання на найкраще за останній час.
Без спаму. Відписатися можна в один клік.