Скільки AI-агентів потрібно: коли флот виграє в одного
NVIDIA ENPIRE: вісім агентів доходять до кращого рішення швидше за одного. Розбираю умову, за якої це працює, і чому «один агент» лишається дефолтом у бізнесі.
Andrew Maryasov, AI-консультант, засновник Auspex і Grow2.ai. Правило «згорни ланцюг із дванадцяти агентів в одного з сильним eval» тримається рівно доти, доки завдання eval — перевірити відповідь. Там, де він здатний ранжувати багато кандидатів, а правильна відповідь наперед невідома, флот агентів доходить до кращого рішення швидше за одного. Умова тут не «скільки агентів ви можете запустити», а «чи існує автоматичний вердикт». Нижче — що саме виміряли в NVIDIA, чому друга половина того ж результату говорить протилежне, і за яких трьох умов це взагалі переноситься на бізнес-процеси.
TL;DR (за 30 секунд)
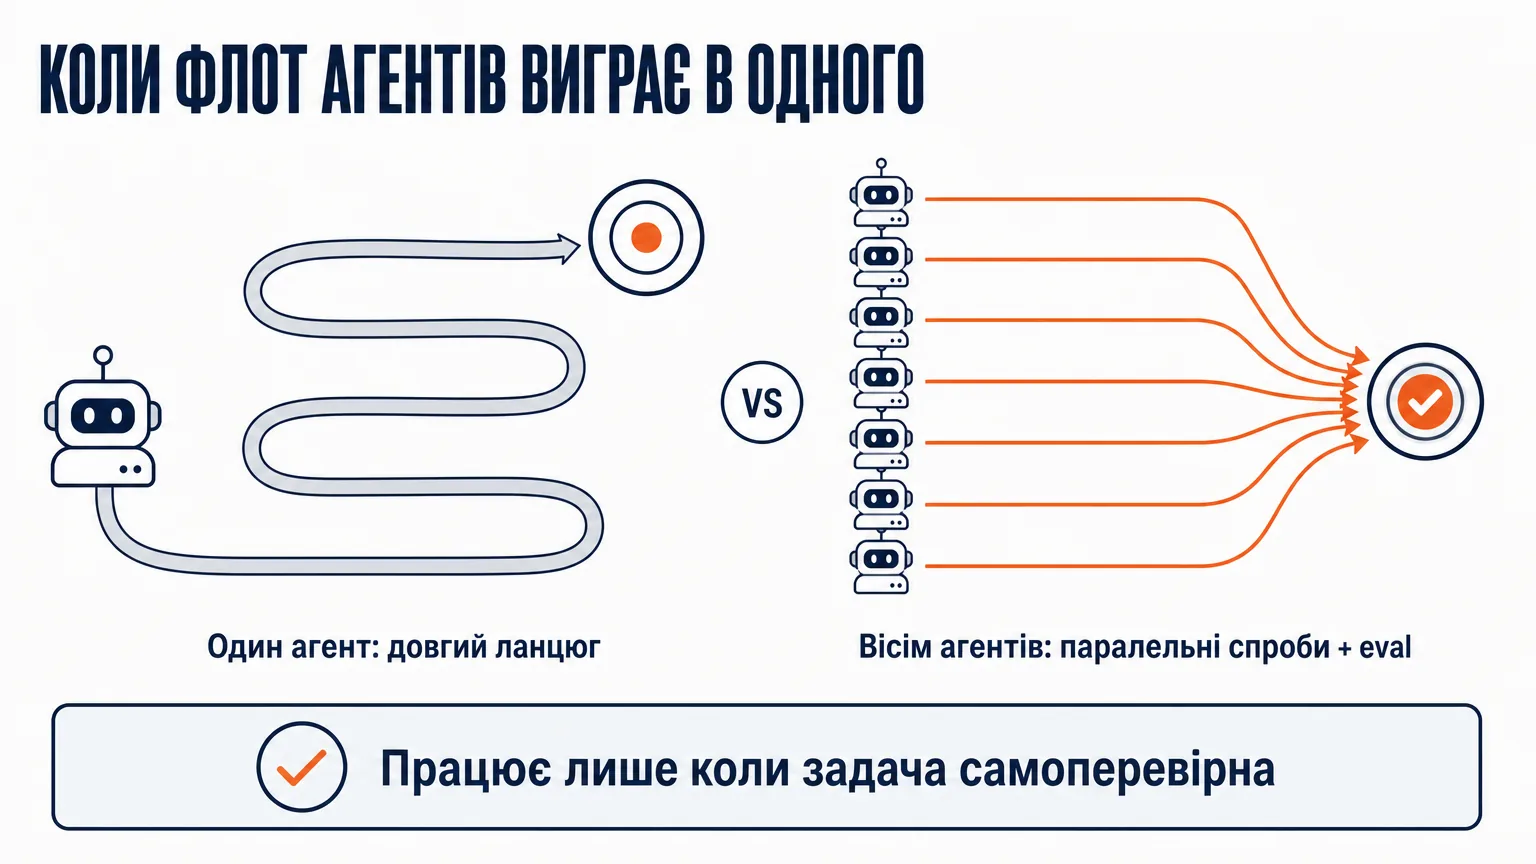
- Кількість агентів дає віддачу. У проєкті ENPIRE (NVIDIA, CMU, UC Berkeley, червень 2026) більша кількість агентів — у переказі Import AI ідеться про порядок восьми — доходить до вищих за оцінкою рішень раніше, і подеколи мультиагентна конфігурація дає вищий абсолютний бал, ніж одиночна. Ймовірна причина: ширше дослідження простору рішень.
- Але передумова важливіша за число. Флот там можливий тільки тому, що в системі вже є автоматичний вердикт «вийшло / не вийшло». Без нього вісім агентів дають не вісім гіпотез, а вісім текстів, які хтось має прочитати.
- Eval міняє роль. У правилі «один агент замість ланцюга» eval перевіряє відповідь. У флоті той самий eval ранжує кандидатів. Це різні функції, і друга дозволяє те, що перша забороняє.
- Друга половина результату — протилежна. Автори прямо пишуть, що зі зростанням кількості роботів середня утилізація робота падає: агент читає логи, пише код, налагоджує або чекає на модель, поки дороге залізо стоїть.
- Для бізнесу переносяться не вісім агентів, а три умови: результат перевіряється автоматично, середовище скидається без наслідків, простір рішень справді широкий. Більшість процесів у компаніях провалюють перші дві.
Правило, яке зараз повторюють усі
Формулювання ходить у різних варіантах, але суть одна: якщо ви можете написати наскрізний eval для завдання — згорніть ланцюг із п’яти чи дванадцяти агентів в одного з відпрацьованим промптом.
Найчіткіше воно сформульоване в AI-Native Playbook (розділ 3.4, автор — Gerstep): «Мультиагентний ланцюг — це людський спосіб упоратися зі складністю, а не відповідь на неї». Тобто команди розбивають задачу на агентів не тому, що задача цього вимагає, а тому, що не тримають складність одного промпта в голові. Eval тримає її замість них.
Аргументи за цим правилом сильні, і я з ними не сперечаюсь. Координаційні витрати в мультиагентних системах з’їдають велику частку токенів: контекст серіалізується в JSON, пересилається на кожному переході, розбирається наново з іншого боку. Більшість корпоративних процесів монотонні, впорядковані й передбачувані, без жодних адаптивних рішень — мультиагентна архітектура їм не потрібна взагалі.
Я і сам писав, що збої мультиагентної системи трапляються не всередині агентів, а на стиках між ними, і кожен новий агент — це новий стик.
З аргументами все гаразд. Погано те, що правило майже завжди наводять без передумови, за якої воно істинне.
Що саме показав ENPIRE
18 червня 2026 року дослідники NVIDIA, Університету Карнегі — Меллона і Берклі виклали препринт ENPIRE — обгортку, яка дає кодовим агентам замкнутий цикл для навчання політик реальних роботів.
Про один її модуль я вже писав окремо. Environment робить дві нудні речі — автоматично скидає сцену і автоматично перевіряє результат, — і без нього не працює жоден із трьох «розумних» модулів. Тоді мене цікавило саме це: поки задача не стала самоскидною і самоперевірною, агенту нема з чого вчитися.
Зараз мене цікавить інша половина тієї ж роботи — та, що про кількість агентів.
Автори формулюють в анотації: «ENPIRE можна суттєво прискорити на флоті роботів», і пропонують дві метрики — Mean Robot Utilization (MRU) і Mean Token Utilization (MTU) — щоб міряти ефективність мультиагентного фізичного автодослідження. Не кількість агентів. Утилізацію.
Jack Clark в Import AI 463 (29 червня 2026) підсумовує результат так: є переконлива віддача від масштабування агентів, більша їх кількість — наприклад, вісім — доходить до вищих за оцінкою рішень раніше за інших, і подеколи мультиагентна конфігурація дає вищий абсолютний бал, ніж одиночна, ймовірно через ширше дослідження простору можливих рішень.
Два уточнення, без яких це число легко перебільшити. «Наприклад, вісім» — це формулювання переказу, а не порогове значення з роботи; публічний конспект не наводить кривої віддачі, тож «вісім» варто читати як порядок, а не як налаштування. І «подеколи» тут несе вагу: вищий абсолютний бал у мультиагентній конфігурації трапляється, а не гарантований.
Влаштований цей флот так. На проєктній сторінці є схема пошуку у вигляді git-дерева гіпотез: одна гілка на агента, одна точка на випробувану ідею. Зеленим кільцем позначена ідея, яка підняла середню успішність команди, зеленими кривими — перенесення ідей між агентами.
Тобто це не фан-аут із голосуванням. Агенти не усереднюють свої висновки — вони ведуть паралельні гілки, підглядають одне в одного і ранжуються за одним спільним числом, яке рахує машина.
Чому це не спростування правила, а його межа
Правило «один агент із сильним eval» мовчки припускає, що правильна відповідь по суті визначена, а робота полягає в тому, щоб виконати її акуратно: оформити документ, провести транзакцію, пройти впорядковані кроки регламенту. У такій задачі eval — це контролер на виході, який каже «правильно» або «неправильно» про один результат. Другий агент тут не додає нової відповіді, він додає ще один стик, на якому можна розсинхронізуватися.
ENPIRE вирішує задачу протилежного типу. Який алгоритм навчить робота зав’язувати зіп-тай, наперед не знає ніхто — ні дослідник, ні агент. Робота полягає не в тому, щоб виконати відому відповідь, а в тому, щоб її знайти. Тут eval перестає бути контролером і стає суддею на турнірі: він порівнює багато кандидатів і впорядковує їх.
У цього підвищення є ціна, про яку варто сказати одразу. Щойно eval стає суддею, за яким ранжуються кандидати, він перетворюється на мішень: оптимізувати оцінку завжди дешевше, ніж оптимізувати результат. В ENPIRE це закрили грубо — у промпті прямим текстом написано, що правити код середовища не можна, це шахрайство. Механіку я розбирав окремо в тексті про reward hacking і чотири захисти; при переході від одного агента до восьми ризик не лишається тим самим, а множиться на кількість гілок.
Звідси розділення, яке я тепер вважаю точнішим за початкове правило:
Наявність автоматичного eval визначає, чи можливий флот. Ширина простору рішень визначає, чи він потрібен.
Без eval флот неможливий — не тому, що дорого, а тому, що вісім паралельних результатів без автоматичного вердикту перетворюються на вісім текстів, які читає людина. У цей момент людина і є eval, а кількість агентів упирається в її увагу.
При вузькому просторі рішень флот не потрібен — навіть з ідеальним eval. Якщо відповідь одна, вісім агентів знайдуть ту саму відповідь вісім разів.
Друга половина результату: залізо простоює, поки агент думає
Та сама робота містить результат, який рідко цитують разом із «вісьмома агентами». Автори пишуть прямо:
Кодові агенти не використовують ресурси робота повністю, поки читають логи, пишуть код, налагоджують або чекають на мовну модель. Зі зростанням кількості роботів MRU падає, а активна утилізація GPU зростає.
Дороге і дефіцитне тут — робот. Він фізичний, його не інстанціюєш ще вісім штук командою в терміналі. Агент, навпаки, дешевий і паралельний. Коли ви додаєте роботів, вузьке місце переїжджає з фізичного шару на шар мислення: станція з парою маніпуляторів, камерами і власною RTX 5090 стоїть і чекає, поки агент дочитає логи й дочекається відповіді моделі.
Саме тому автори і запропонували MRU з MTU. Метрика флоту — не «скільки в нас агентів», а «яка частка дефіцитного ресурсу реально працює».
Тому результат і не читається як реклама флотів: у тій самій роботі, де більше агентів дає кращий бал, зростання кількості роботів одночасно погіршує утилізацію заліза. Це дві різні осі масштабування, і тягнуть вони в різні боки.
Три умови, за яких це переноситься на бізнес
ENPIRE — про самонавчання політик робота силами кодових агентів. Ваш процес узгодження договорів — інша задача, і прямий перенос тут був би підміною. Перенос коректний тільки тоді, коли ваша задача відтворює три властивості середовища ENPIRE.
Перша: результат перевіряється автоматично. Не «керівник подивиться», а машина ставить нуль або одиницю без людини в контурі. У ENPIRE це детектор і сегментаційна модель, які незалежно з двох камер відповідають на одне питання. У вашому випадку це можуть бути тести, звірка з еталонним набором, перевірка схеми. Якщо вердикт виносить людина — умова не виконана, і далі можна не читати.
Друга: середовище скидається без наслідків. Спробу можна повторити з чистого аркуша, і невдала спроба нікому не коштує. Робот кладе зіп-тай назад. Клієнт, якому агент уже надіслав лист, назад не скидається. Більшість бізнес-процесів необоротні саме тут, і це головна причина, чому паралельний пошук у них не запускають.
Третя: простір рішень справді широкий. Є багато незалежних способів зробити роботу, і ви наперед не знаєте, який кращий. Якщо спосіб один і він описаний у регламенті — вам потрібен надійний виконавець, а не пошук.
Три з трьох — можна думати про флот. Дві з трьох — не можна, і найчастіше провалюється друга.
Де флот законний у звичайній компанії
Ділянки, де всі три умови сходяться, існують, просто їх менше, ніж здається з анонсів.
Код із тестами — канонічний випадок: вердикт виносить тестовий прогін, відкат безкоштовний, способів реалізації багато. Витягування даних із документів, коли у вас є розмічений еталонний набір на сотню зразків: вісім варіантів екстрактора ранжуються за точністю на цьому наборі автоматично.
Найближчий аналог до того, що робить ENPIRE, — пошук самої інструкції для агента. Ви фіксуєте eval-набір, генеруєте вісім варіантів промпта чи скіла, проганяєте кожен по набору й берете той, що дав кращий бал. Це рівно та сама конструкція: паралельні гілки, спільне число, ранжування замість усереднення. І вона доступна будь-якій компанії, яка спромоглася зібрати п’ятдесят прикладів із правильними відповідями.
А от «вісім агентів пишуть вам комерційні пропозиції» до цього списку не належить. Автоматичного вердикту, який відрізнить кращу пропозицію від гіршої до відправлення клієнту, не існує. Ви отримаєте вісім документів і людину, яка їх читає.
Окремо варто назвати пастку в інтерпретації. Виграш вісьмох агентів у ENPIRE виміряний як час до кращого рішення в дослідницькому пошуку, а не як пропускна здатність на рутині. Якщо ваша задача — обробити чергу з двохсот однакових заявок, ви масштабуєте пропускну здатність, і це зовсім інша механіка. Плутати «швидше знайшли» зі «швидше зробили» — найдорожча помилка при читанні таких результатів.
Коефіцієнти нагляду нікуди не поділися
Орієнтири, які я вважаю робочими, від цієї роботи не змінилися: приблизно десять-двадцять агентів на одного супервізора для низьких ставок, чотири-вісім для середніх, один-три там, де ціна помилки фінансова, медична або юридична.
Тепер видно, чому вони саме такі. Ці коефіцієнти описують середовища, де автоматичного eval немає і людина є eval. Коли вердикт виносить людина, кількість агентів упирається не в бюджет і не в інфраструктуру, а в її увагу. Чим вища ставка, тим уважніше треба дивитися і тим менше агентів вміщується в одну голову.
Ставка тут вимірюється не відчуттям, а обсягом шкоди і часом відкату. Вісім агентів у пісочниці з тестами і вісім агентів із доступом до бойової бази — це один рядок у дашборді й два різних коефіцієнти нагляду.
Правило «не нарощуй кількість агентів» описує світ без автоматичного вердикту. Для більшості компаній це і є їхній світ — тому правило лишається розумним дефолтом, а не помилкою.
Як звучить правило з передумовою
Початкове формулювання варто добудувати до такого:
Згортайте ланцюг агентів в одного там, де відповідь по суті визначена, а eval перевіряє результат. Розгортайте флот там, де відповідь треба знайти, а eval здатний ранжувати кандидатів без людини. Немає автоматичного eval — не робіть ні того, ні іншого, спершу зробіть eval.
Практичний порядок дій перед тим, як додавати агентів:
- Спитайте, чи існує машинний вердикт для цієї задачі. Немає — далі не йдіть, вся інша дискусія передчасна.
- Спитайте, чи відома правильна відповідь наперед. Відома — вам потрібен один надійний виконавець.
- Спитайте, що у вашому процесі є дефіцитним ресурсом на кшталт робота, і чи не почне він простоювати, поки агенти думають.
- Міряйте утилізацію цього ресурсу, а не кількість запущених агентів.
Четвертий пункт — прямий висновок із MRU. Кількість агентів на дашборді нічого не каже про те, чи працює те, за що ви платите. І як з будь-якою метрикою агента, спершу назвіть знаменник: «утилізація 60%» без відповіді на питання «від чого рахували» — це не показник, а число.
Чого ця робота не доводить
ENPIRE не доводить, що вісім агентів кращі за одного взагалі. Результат отриманий на одному класі задач — пошук алгоритму навчання політики для маніпуляції — у середовищі з автоматичним ресетом і автоматичною верифікацією.
Кривої віддачі публічний переказ не наводить, тож де починається насичення і де віддача стає від’ємною, ми не знаємо. Бізнес-агентів ця робота не міряє взагалі, жодного разу.
Координаційні витрати вона теж не скасовує — вона їх обходить архітектурою, у якій агенти не передають роботу одне одному по ланцюгу, а ведуть незалежні гілки з одним спільним числом. Віддача виникає не від кількості агентів, а від форми, у якій вони не заважають одне одному. Той самий вісімковий флот, зібраний як послідовний конвеєр, дав би зовсім іншу картину.
FAQ
Скільки AI-агентів потрібно бізнесу?
Стільки, скільки ваш нагляд здатен перевірити. Якщо вердикт про якість роботи виносить людина — орієнтуйтеся на десять-двадцять агентів на супервізора при низьких ставках, чотири-вісім при середніх і один-три у фінансах, медицині чи юриспруденції. Якщо вердикт автоматичний, стеля піднімається, і обмеженням стає утилізація дефіцитного ресурсу, а не увага людини.
Коли флот агентів реально виграє в одного агента?
Коли одночасно виконані три умови: результат перевіряється машиною без людини, спробу можна повторити без наслідків, і є багато незалежних способів зробити роботу. У ENPIRE виконані всі три, і саме там більша кількість агентів доходить до кращого рішення раніше.
Чи означає це, що правило «один агент із сильним eval» помилкове?
Ні. Воно правильне для задач, де відповідь по суті визначена, а eval перевіряє результат — це більшість корпоративних процесів. Помилкове не правило, а його застосування без цієї передумови до задач пошуку, де відповідь наперед невідома.
Що таке MRU і MTU в ENPIRE?
Mean Robot Utilization і Mean Token Utilization — дві метрики, які автори запропонували для вимірювання ефективності мультиагентного фізичного автодослідження. Вони міряють, яка частка дефіцитного ресурсу реально працює, а не скільки агентів запущено.
Чому зростання флоту роботів погіршує утилізацію?
Бо агент значну частину часу не діє, а думає: читає логи, пише код, налагоджує, чекає на відповідь моделі. У цей час фізичний ресурс простоює. Автори фіксують це прямо: зі зростанням кількості роботів MRU падає. Зауважте, що йдеться саме про масштабування роботів, а не агентів — це різні осі, і робота міряє просідання по першій.
Чи можна масштабувати агентів, якщо в нас немає автоматичної перевірки?
Технічно можна, практично — це переносить навантаження на людину. Вісім паралельних результатів без машинного вердикту означають вісім артефактів, які хтось прочитає. Спершу будується перевірка, потім масштабується кількість.
З чого почати, якщо хочеться спробувати паралельний пошук?
З найдешевшої ділянки, де вердикт уже автоматичний. Зберіть п’ятдесят-сто прикладів із правильними відповідями, згенеруйте кілька варіантів інструкції для агента, проженіть кожен по набору й візьміть кращий за балом. Це та сама конструкція, що у ENPIRE, тільки без роботів.
Що далі
Найкорисніше, що можна винести з цієї роботи, — не число «вісім». Це порядок питань: спершу автоматичний вердикт, потім ширина простору рішень, і тільки потім кількість агентів.
Компанії зазвичай йдуть у зворотному порядку і впираються в те, що дискусія про кількість агентів була передчасною на два кроки.
Якщо ви зараз вирішуєте, скільки агентів запускати, — почніть з питання, хто у вашому процесі ставить нуль або одиницю. Якщо відповідь «людина», то ви вже знаєте свою стелю, і вона не про агентів.
Джерела:
- ENPIRE: Agentic Robot Policy Self-Improvement in the Real World — препринт, arXiv:2606.19980, 18.06.2026 (NVIDIA, CMU, UC Berkeley)
- Проєктна сторінка ENPIRE — анотація, метрики MRU/MTU, дерево гіпотез
- Import AI 463 — Jack Clark, 29.06.2026, переказ результату про масштабування агентів
- AI-Native Playbook, 3.4 Making Agents Reliable — Gerstep, формулювання правила про згортання ланцюга
Опублікував Andrew Maryasov, засновник Auspex і Grow2.ai — впроваджую AI-агентів у бізнес-процеси.
Лист про AI — 2–3 листи на місяць
Особисті есе про те, як AI змінює мислення й роботу: що я спробував сам, що спрацювало, а що ні. Наприкінці — посилання на найкраще за останній час.
Без спаму. Відписатися можна в один клік.