Персональна AI-операційна система: шість місяців практики в цифрах
Пів року будую персональну AI-операційну систему: файли замість промптів, п'ять failure modes, цифри METR, з чого почати і 30-денний план старту.
Andrew Maryasov, AI-консультант. Впроваджую AI-агентів для бізнесу, а паралельно з листопада 2025 року живу у власній AI-операційній системі — звичайній Markdown-папці, яку читає агент. Тут — що спрацювало, що ні і де я зловив себе на дурницях.
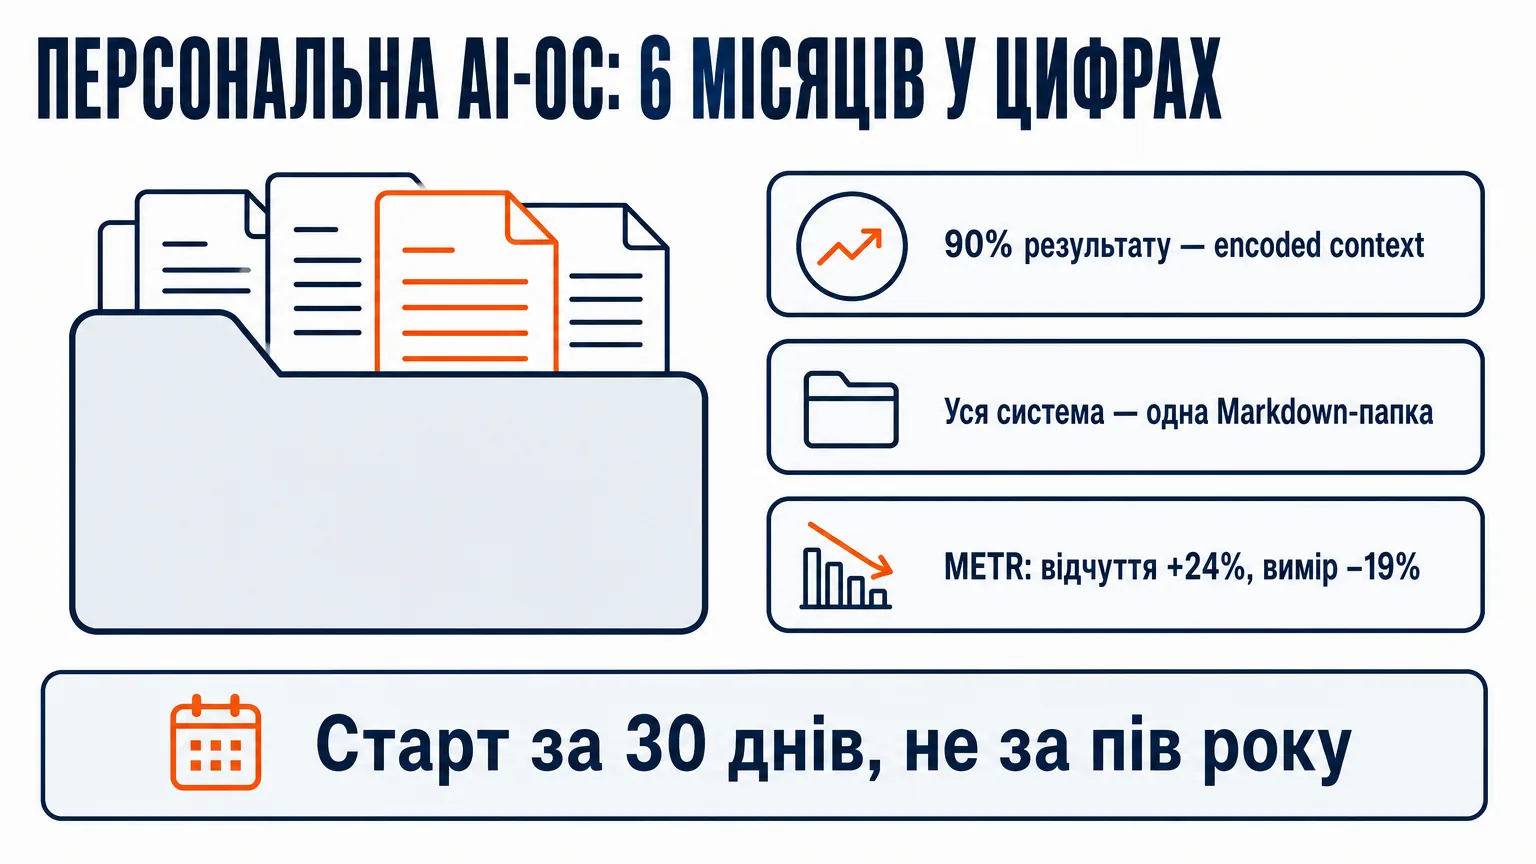
TL;DR (за 30 секунд)
- 90% результату — це encoded context, а не cleverness промпта. Накопичений контекст про мене, мою роботу і цілі важить більше, ніж будь-яке формулювання запиту.
- Уся система — одна Markdown-папка. Жодного custom data layer: git-нативно, grep-debuggable, а переїзд на новий інструмент — одним
cp -R. - Своїм відчуттям довіряти не можна. METR, липень 2025: розробники прогнозували +24% швидкості до початку роботи, а вимірювання показало −19%. Сорок три відсоткові пункти між прогнозом і фактом.
- Стартувати можна за 30 днів — але не з копіювання чужого стеку. Стек — це фінал чужої історії. Починають із контексту: тиждень логування, тиждень encoding, один закодований judgment call, і все на цифрах.
Гіст, який зібрав 5 тисяч зірок за тиждень
У квітні Андрій Карпати виклав на GitHub gist про свою щоденну роботу з AI. П’ять тисяч зірок за перший тиждень, 16 мільйонів переглядів у X. Його однорядкове резюме: «Obsidian — це IDE; LLM — програміст; wiki — кодова база».
Я живу в такій штуці шість місяців. Персональна AI-операційна система тут — буквально папка з Markdown-файлами, де агент має повний контекст про мене, мої проєкти і мої цілі.
Карпати називає цей підхід «files are the API». Жодного кастомного шару даних, жодного хитрого runtime: файли, які однаково бачать і людина, і агент, — git-нативно і grep-debuggable. Коли виходить наступна модель чи новий редактор, я переїжджаю однією командою cp -R.
Чотири калібрування, які не делегуються
Головне, що я зрозумів за ці пів року: AI-систему для команди не побудуєш, якщо сам у ній не пожив. Чотири калібрування, які формуються тільки на власній шкірі.
Смак. З сотні драфтів упізнати той, який вирішує задачу.
Інтуїція ціни. Скільки задача реально коштує в токенах: де виправдано доплатити за frontier-модель, а де вистачить Haiku.
Інтуїція blast-radius. Де агента можна відпустити самого, а де треба дивитися в очі кожному кроку, бо одна помилка наробить лиха.
Співвідношення контексту й промпта. Найболючіше з чотирьох: 90% результату дає encoded context про мене, мою роботу й мої цілі; формулювання запиту важить набагато менше. Не делегується нікому й не видно на жодному дашборді — набирається тільки через reps, повторення на реальній роботі.
Із цього ж переконання виросла моя робота з клієнтами в Grow2.ai: перш ніж нести підхід у чиюсь команду, я проживаю його сам.
Що в мене на диску
Моя система, без скріншотів, словами:
my2brain/
├── .claude/
│   ├── CLAUDE.md           — operating manual для агента
│   ├── TELOS/              — місія, цілі, переконання, стратегії
│   ├── MEMORY/State/       — активна задача, open loops
│   ├── skills/             — 60+ скілів
│   └── rules/, references/ — конвенції, що читаються по тригеру
├── 00_Inbox/               — тимчасовий збір
├── 01_Projects/            — активні проєкти з дедлайном
├── 02_Areas/               — області відповідальності
├── 03_Resources/           — довідники, концепції
├── Goals/                  — каскадні цілі
└── Daily Notes/            — щоденні нотатки
Це не Obsidian проти Claude Code — це одна Markdown-папка, яку обидва бачать однаково. Повний список інструментів навколо неї, з цінами, я розбирав окремо: мій AI-стек 2026.
Чотири файли роблять усю важку роботу.
CLAUDE.md — 40-60 рядків operating constraints: хто я і як організований workspace. По суті — специфікація мого робочого середовища, записана текстом: той самий принцип, про який я писав у «Софт тепер — це текст, а не код», тільки застосований до власної роботи.
TELOS: місія + цілі. Щоб агент знав, які задачі тягнуть до моїх цілей, а які — просто термінові.
GTD-список із п’ятьма секціями — Now, Next, Waiting, Someday, Done. Агент читає його перед плануванням і дописує після виконання.
who-am-i + personal-voice. Без цих двох агент пише generic. З ними — пише так, як писав би я. Цей текст, до речі, — мій драфт, агент правив. Не навпаки.
Що реально змінилось за шість місяців
Без обіцянок «×10 продуктивності». Три речі, які я можу показати.
Я перестав повторювати себе. Корекція, яку я дав агенту місяць тому, сьогодні працює автоматично — через систему пам’яті (Graphiti + MemPalace). Це найважче пояснити словами: відчуваєш на третій тиждень, коли бачиш, як агент уникає помилки, про яку ти сам забув, що йому казав.
Контекст під рукою, а не в голові. Клієнт запитує про щось, що ми обговорювали два місяці тому, — у мене є verbatim тієї розмови плюс структуровані факти з графу. Без «здається, ми тоді вирішили…».
Зв’язки, яких я б свідомо не побудував. LightRAG показує перетини між нотатками. Пишеш комерційну пропозицію для нового клієнта — і раптом бачиш нотатку з вебінару 2024 року, яка точно лягає під цей кейс. У голові її вже немає. На диску — є.
П’ять failure modes, на яких я зловив себе
1. Правити AI нижче власного експертного рівня — означає псувати. Польове дослідження Dell’Acqua, Mollick і колег із 758 консультантами BCG («Navigating the Jagged Technological Frontier») показало: правка AI без експертизи в темі здатна опустити результат нижче за той, який людина дала б сама. Я бачив це на email-чернетках: перші місяці переписував усе підряд — і якість падала. Тепер email приймаю майже без правок, а в юридичних документах переписую кожен рядок, бо там точно знаю, чого хочу.
2. Після третього провалу — не re-prompt, а додати контекст. Помилка майже завжди в missing context. Третій провал — сигнал зупинитися і зібрати контекст замість четвертого формулювання.
3. Промпт, який росте квартал за кварталом, — сигнал missing context. Виріс із 50 рядків до 500 — переносьте вміст у context-файли. Промпти мусять коротшати, файли — рости.
4. Вартість дрейфує тихо. Один день $5, другий $15, через місяць $80. У моменті завжди «дешево» — і це найгірше. Жорсткий денний ліміт плюс weekly review — мінімум, що рятує. У мене зараз $15 на день, і за цю межу я себе не пускаю.
5. Marketplace-скіли виконуються з твоїми правами доступу. Скіл — це код, який запускається з твоїми permissions. Моє правило просте: читаю код кожного скіла перед install і не ставлю нічого, чого не можу прочитати за десять хвилин.
І найболючіше відкриття — не моє. Дослідження METR (липень 2025, «Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity»): до початку роботи досвідчені open-source розробники прогнозували, що AI прискорить їх на 24%, а вимірювання показало сповільнення на 19%. Сорок три відсоткові пункти між прогнозом і фактом — і навіть постфактум ті самі розробники оцінювали себе на +20%. Деталі й методику автори виклали у себе на сайті. У перший місяць своєму відчуттю довіряти не можна. Потрібен вимір.
З чого почати
Найприродніший старт — узяти чийсь готовий стек і повторити. Він же найгірший. Стек — це фінал чужої історії: він зібраний під чужі задачі, чужий бюджет і чужу голову. Копіюєш фінал — отримуєш колекцію підписок і відчуття, що «щось не так».
Порядок інший. Спершу контекст: що AI знає про вас, вашу роботу і ваші цілі. П’ять-десять файлів простим текстом дадуть більше, ніж друга і третя підписка. Потім одна повторювана задача, яку ви щодня пропускаєте через агента. Потім лог, який відрізняє «зекономило час» від «відчувалося продуктивним». Інструменти доростуть самі: мій стек виглядає так, як виглядає, тому що ріс із контексту, а підписки додавалися останніми.
Межа, за якою ця карта закінчується: вона загальна, а перша петля цінності у кожного своя. Який процес автоматизувати першим, що покласти в контекст-файли вашої роботи, де у вас проходить лінія «агенту можна» — цього зі статей не дістати.
30 днів замість шести місяців
Мені знадобилося пів року проб і помилок. Ця арка стискає їх у чотири тижні.
| Тиждень | Що робити | Навіщо |
|---|---|---|
| 1 | Пропускати все через агента | Не заради економії часу, а заради лога: що реально економить час, а що лише відчувається продуктивним |
| 2 | Encode тільки те, що зробив двічі | Один раз — не варто: скіл згниє і смітитиме |
| 3 | Закодувати одне повторюване рішення (deal-scoring, скринінг співрозмовника, тріаж support’у) як скіл | Написання rubric’у виявляє, які рішення були послідовні, а які — «що сьогодні відчулося правильним» |
| 4 | Міряти: час, якість, cost, debugging overhead | Вбити все, що виглядає добре на відчуття, але провалюється на цифрах |
Три маркери 30-го дня, які відрізняють компаундинг від плато: три-п’ять щоденних workflow’ів на adequate quality; acceptance rate вище 70% — частка AI-output, яку приймаєш із мінімальними правками; і один закодований judgment call — перший артефакт, яким можна поділитися з командою.
Цей перший командний артефакт не вибираєш свідомо. Daily brief, який я зробив для себе, стає шаблоном командного стендапу. Style guide — стандартом комунікації. Рубрика оцінки угоди — командним due diligence. Команда сама витягує те, що масштабується. Це я зрозумів тільки на четвертому місяці.
Пів року — замало, щоб робити гучні заяви. Достатньо, щоб з’явилося калібрування «це працює» / «це театр». Далі розкладатиму конкретні файли й скіли по одному — почну з GTD.md, бо саме цей файл найшвидше окупає вкладений у нього час.
А поки — питання, яке варте більше, ніж весь цей текст. Якщо AI справді робить вас швидшими: як саме ви це виміряли?
FAQ
З якого інструмента почати особисту AI-систему?
З одного — будь-якого сучасного асистента, який уміє читати вашу папку з файлами. Питання в контексті: п’ять-десять текстових файлів про вас, вашу роботу і цілі дадуть більше, ніж друга і третя підписка.
Скільки коштує особиста AI-система на місяць?
Вхідний квиток — одна підписка. У мене це були $20 за ChatGPT, потім $20 за Claude. За пів року система доросла до ~$300 на місяць, але це фінал історії, а не старт. Важливіше з першого дня тримати денну стелю витрат: дрейф із $5 до $80 на день відбувається непомітно. Повний розклад із цінами — у моєму стеку.
Як вести лог у перший місяць?
Три колонки на кожну задачу: скільки часу вона забрала б без агента, скільки забрала з ним, і скільки часу ви витратили на перевірку та правки. Третя колонка й ловить самообман — саме її не бачили розробники в дослідженні METR, коли прогнозували +24%, а вимірювання показало −19%.
Що робити, коли агент утретє не справляється із задачею?
Додавати контекст замість того, щоб переформульовувати запит. Помилка майже завжди у відсутніх матеріалах, не в моделі. Третій провал — сигнал зробити крок назад і спитати: чого агент не знає про вашу задачу?
Лист про AI — 2–3 листи на місяць
Особисті есе про те, як AI змінює мислення й роботу: що я спробував сам, що спрацювало, а що ні. Наприкінці — посилання на найкраще за останній час.
Без спаму. Відписатися можна в один клік.