Sistema operativo personal de IA: seis meses de práctica en cifras
Seis meses construyendo un sistema operativo personal de IA: archivos en lugar de prompts, cinco failure modes, las cifras de METR, por dónde empezar y un plan de 30 días.
Andrew Maryasov, consultor de IA. Implemento agentes de IA para empresas y, en paralelo, desde noviembre de 2025 vivo en mi propio sistema operativo de IA: una carpeta común de Markdown que lee un agente. Este texto no es “cómo automaticé todo en una noche”, sino un informe honesto: qué funcionó, qué no y dónde me descubrí haciendo tonterías.
TL;DR (en 30 segundos)
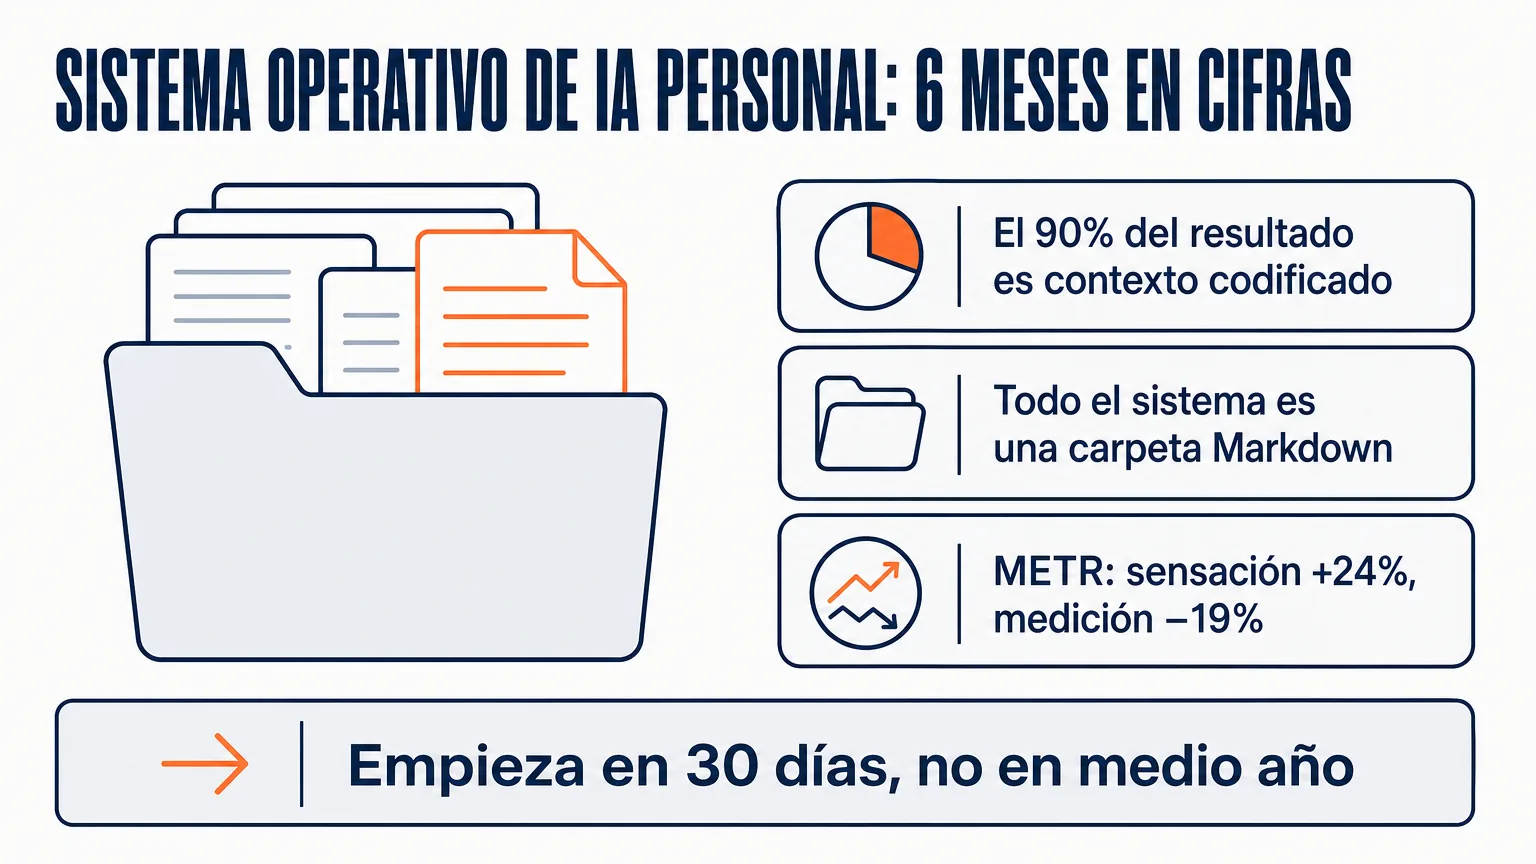
- El 90% del resultado es el encoded context, no la astucia del prompt. El contexto acumulado sobre mí, mi trabajo y mis metas pesa más que cualquier formulación de la consulta.
- Todo el sistema es una sola carpeta de Markdown. Nada de custom data layer: git-nativo, depurable con grep, y mudarse a una herramienta nueva es un solo
cp -R. - No puedes confiar en tus sensaciones. METR, julio de 2025: los desarrolladores pronosticaron +24% de velocidad antes de empezar, y la medición mostró −19%. Cuarenta y tres puntos porcentuales entre el pronóstico y el hecho.
- Puedes arrancar en 30 días, pero no copiando el stack de otro. Un stack es el final de la historia de otra persona. Se empieza por el contexto: una semana de registro, una semana de encoding, un judgment call codificado, y todo medido con cifras.
El gist que juntó 5 mil estrellas en una semana
En abril, Andrej Karpathy publicó en GitHub un gist sobre su trabajo diario con IA. Cinco mil estrellas en la primera semana, 16 millones de vistas en X. Su resumen de una línea: “Obsidian es el IDE; el LLM es el programador; la wiki es la base de código”.
Yo llevo seis meses viviendo en algo así. Un sistema operativo personal de IA no es una metáfora: es literalmente una carpeta con archivos Markdown donde el agente tiene el contexto completo sobre mí, mis proyectos y mis metas. Y no quiero “inspirar”, quiero mostrar cifras: qué funciona, qué no y dónde me estorbé a mí mismo.
Karpathy llama a este enfoque “files are the API”. Sin capa de datos a medida, sin runtime ingenioso: archivos que la persona y el agente ven exactamente igual — git-nativo y depurable con grep. Cuando sale el siguiente modelo o un editor nuevo, me mudo con un solo comando: cp -R.
Cuatro calibraciones que no se delegan
Lo principal que entendí en este medio año: no puedes construir un sistema de IA para un equipo si no viviste en uno tú mismo. No es una frase grandilocuente — son cuatro calibraciones que solo se forman en carne propia.
Gusto. De cien borradores, elegir no el “bonito”, sino el que resuelve la tarea.
Intuición de costo. Cuánto cuesta realmente una tarea en tokens: dónde se justifica pagar más por un modelo frontier y dónde alcanza con Haiku.
Intuición de blast radius. Dónde puedes soltar al agente solo y dónde tienes que mirar cada paso de cerca, porque un error puede hacer destrozos.
La proporción entre contexto y prompt. La más dolorosa de las cuatro: el 90% del resultado lo da el encoded context sobre mí, mi trabajo y mis metas, no la astucia del prompt. Esto no se delega a nadie y no se ve en ningún dashboard — se acumula solo con reps, repeticiones en trabajo real.
De esa misma convicción nació mi trabajo con clientes en Grow2.ai: antes de llevar un enfoque al equipo de alguien más, lo vivo yo primero.
Qué tengo en el disco
Este es mi sistema — sin capturas de pantalla, en palabras:
my2brain/
├── .claude/
│   ├── CLAUDE.md           — operating manual para el agente
│   ├── TELOS/              — misión, metas, creencias, estrategias
│   ├── MEMORY/State/       — tarea activa, open loops
│   ├── skills/             — 60+ skills
│   └── rules/, references/ — convenciones que se leen por trigger
├── 00_Inbox/               — captura temporal
├── 01_Projects/            — proyectos activos con deadline
├── 02_Areas/               — áreas de responsabilidad
├── 03_Resources/           — referencias, conceptos
├── Goals/                  — metas en cascada
└── Daily Notes/            — notas diarias
Esto no es Obsidian contra Claude Code: es una sola carpeta de Markdown que ambos ven igual. La lista completa de herramientas alrededor de ella, con precios, la desglosé aparte: mi stack de IA 2026.
Cuatro archivos hacen todo el trabajo pesado.
CLAUDE.md — 40-60 líneas sobre quién soy y cómo está organizado el workspace. No es marketing, son operating constraints. En esencia, una especificación de mi entorno de trabajo escrita en texto: el mismo principio del que escribí en “El software ahora es texto, no código”, solo que aplicado a mi propio trabajo.
TELOS: misión + metas. Para que el agente sepa qué tareas empujan hacia mis metas y cuáles solo son urgentes.
La lista GTD con cinco secciones — Now, Next, Waiting, Someday, Done. El agente la lee antes de planificar y la actualiza después de ejecutar.
who-am-i + personal-voice. Sin estos dos, el agente escribe genérico. Con ellos, escribe como escribiría yo. Este texto, por cierto, es mi borrador y el agente corrigió. No al revés.
Qué cambió de verdad en seis meses
Sin promesas de “productividad ×10”. Tres cosas que puedo mostrar.
Dejé de repetirme. Una corrección que le di al agente hace un mes hoy funciona en automático, gracias al sistema de memoria (Graphiti + MemPalace). Es lo más difícil de explicar con palabras: lo sientes en la tercera semana, cuando ves cómo el agente evita un error que tú ya olvidaste que le habías señalado.
El contexto está a mano, no en la cabeza. Un cliente pregunta por algo que discutimos hace dos meses — y tengo el verbatim de esa conversación más los hechos estructurados del grafo. Sin “me parece que habíamos decidido…”.
Conexiones que yo no habría construido a propósito. LightRAG muestra los cruces entre notas. Escribes una propuesta comercial para un cliente nuevo — y de pronto ves una nota de un webinar de 2024 que encaja exacto en ese caso. En la cabeza ya no está. En el disco, sí.
Cinco failure modes que descubrí en mí mismo
1. Corregir a la IA por debajo de tu propio nivel de expertise es arruinar el resultado. El estudio de campo de Dell’Acqua, Mollick y colegas con 758 consultores de BCG («Navigating the Jagged Technological Frontier») mostró que corregir la salida de la IA sin expertise en el tema puede dejar el resultado por debajo del que la persona habría dado sola. Yo lo vi en mis borradores de email: los primeros meses reescribía todo — y la calidad caía. Ahora los emails los acepto casi sin cambios, pero en los documentos legales reescribo cada línea, porque ahí sé exactamente lo que quiero.
2. Después del tercer intento fallido: no hagas re-prompt, agrega contexto. El error casi siempre está en el missing context, no en el modelo. El tercer fallo es la señal para dar un paso atrás, no para intentar otra vez con una formulación un poco mejor.
3. Un prompt que crece trimestre tras trimestre es señal de missing context. Si pasó de 50 líneas a 500, mueve el contenido a archivos de contexto. Los prompts deben acortarse; los archivos, crecer.
4. El costo se desvía en silencio. Un día $5, otro $15, al mes $80. En el momento siempre parece “barato” — y eso es lo peor. Un límite diario estricto más una weekly review es el mínimo que te salva. Yo ahora tengo $15 al día, y no me dejo pasar de ese límite.
5. Las skills del marketplace se ejecutan con tus permisos de acceso. Una skill es código que corre con tus permissions, no una instrucción pasiva. Mi regla es simple: leo el código de cada skill antes de instalarla y no instalo nada que no pueda leer en diez minutos. Lo planteo como política propia y no me apoyo en el informe de nadie.
Y el descubrimiento más doloroso no es mío. El estudio de METR (julio de 2025, «Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity»): antes de empezar, desarrolladores open source experimentados pronosticaron que la IA los aceleraría un 24%, y la medición mostró una desaceleración del 19%. Incluso después, esos mismos desarrolladores se estimaban en +20%. Los autores publicaron el método en su sitio. El primer mes no puedes confiar en tu sensación. Necesitas medir.
Por dónde empezar
El arranque más natural es tomar el stack ya montado de alguien y repetirlo. También es el peor. Un stack es el final de la historia de otra persona: está armado para tareas ajenas, un presupuesto ajeno y una cabeza ajena. Copias el final y te queda una colección de suscripciones y la sensación de que algo no encaja.
El orden es el inverso. Primero el contexto: qué sabe la IA sobre ti, tu trabajo y tus metas. Cinco o diez archivos en texto plano rinden más que una segunda y una tercera suscripción. Después, una tarea repetitiva que pasas cada día por el agente. Después, un registro que distinga “esto ahorró tiempo” de “esto se sintió productivo”. Las herramientas llegan solas: mi stack se ve como se ve porque creció desde el contexto, y las suscripciones fueron lo último.
Luego viene el arco de treinta días. Y el borde donde el mapa se acaba: el mapa es general, el primer bucle de valor es tuyo. Qué proceso automatizar primero, qué poner en los archivos de contexto de tu trabajo, dónde pasa tu línea de “al agente sí se le puede” — eso no sale de un artículo.
30 días en lugar de seis meses
A mí me tomó medio año de prueba y error. Se puede arrancar más rápido — esta es la ruta que de verdad funciona, sin experimentos de más.
| Semana | Qué hacer | Para qué |
|---|---|---|
| 1 | Pasar todo por el agente | No para ahorrar tiempo, sino por el registro: qué ahorra tiempo de verdad y qué solo se siente productivo |
| 2 | Codificar solo lo que hiciste dos veces | Una sola vez no vale la pena: la skill se pudre y estorba |
| 3 | Codificar una decisión recurrente (deal scoring, screening de interlocutores, triaje de soporte) como skill | Escribir la rúbrica revela qué decisiones eran consistentes y cuáles eran “lo que hoy se sintió correcto” |
| 4 | Medir: tiempo, calidad, costo, debugging overhead | Matar todo lo que se siente bien pero falla en los números |
Tres marcadores del día 30 que separan el efecto compuesto de la meseta: de tres a cinco workflows diarios con calidad adecuada; un acceptance rate arriba del 70% — la parte del output de la IA que aceptas con correcciones mínimas; y un judgment call codificado — el primer artefacto que puedes compartir con un equipo.
Y la sorpresa: ese primer artefacto de equipo no lo eliges a propósito. El daily brief que hice para mí se convierte en la plantilla del standup del equipo. El style guide, en el estándar de comunicación. La rúbrica para evaluar un deal, en el due diligence del equipo. No soy yo quien elige qué compartir — el equipo mismo toma lo que escala. Eso lo entendí recién en el cuarto mes.
Seis meses es poco para hacer declaraciones grandilocuentes. Es suficiente para que aparezca la calibración de “esto funciona” / “esto es teatro”. Más adelante iré desglosando archivos y skills concretos, uno por uno — voy a empezar con GTD.md, porque es el archivo que más rápido paga el tiempo que inviertes en él.
Mientras tanto, una pregunta que vale más que todo este texto. Si la IA de verdad te hace más rápido: ¿cómo exactamente lo mediste?
FAQ
¿Con qué herramienta empiezo un sistema de IA personal?
Con una — cualquier asistente actual capaz de leer tu carpeta de archivos. La pregunta no es la herramienta, es el contexto: cinco o diez archivos de texto plano sobre ti, tu trabajo y tus metas rinden más que una segunda y una tercera suscripción.
¿Cuánto cuesta al mes un sistema de IA personal?
La entrada es una suscripción. En mi caso fueron $20 de ChatGPT y luego $20 de Claude. En seis meses el sistema llegó a unos $300 al mes, pero eso es el final de la historia, no el arranque. Lo que importa desde el primer día es un techo de gasto diario: la deriva de $5 a $80 al día ocurre sin que la notes. El desglose completo con precios está en mi stack.
¿Cómo llevo el registro el primer mes?
Tres columnas por tarea: cuánto habría tardado sin el agente, cuánto tardó con él y cuánto tiempo dedicaste a revisar y corregir. La tercera columna es la que atrapa el autoengaño — es justo lo que no vieron los desarrolladores del estudio de METR cuando pronosticaron +24% y la medición mostró −19%.
¿Qué hago cuando el agente falla la misma tarea por tercera vez?
Añadir contexto en lugar de reformular la petición. El error casi siempre está en el material que falta, no en el modelo. El tercer fallo es la señal para dar un paso atrás y preguntar qué no sabe el agente sobre tu tarea.
Una carta sobre IA — 2–3 emails al mes
Ensayos personales sobre cómo la IA cambia nuestra forma de pensar y trabajar: qué probé yo mismo, qué funcionó y qué no. Al final, enlaces a lo mejor de lo que he leído.
Sin spam. Puedes darte de baja con un clic.